Famille · 31 fiches
LLM locaux
Tout ce qui fait tourner un modèle de langage sur ta propre machine : Ollama, llama.cpp, format GGUF, moteurs d'inférence et quantification.
 Spécimen
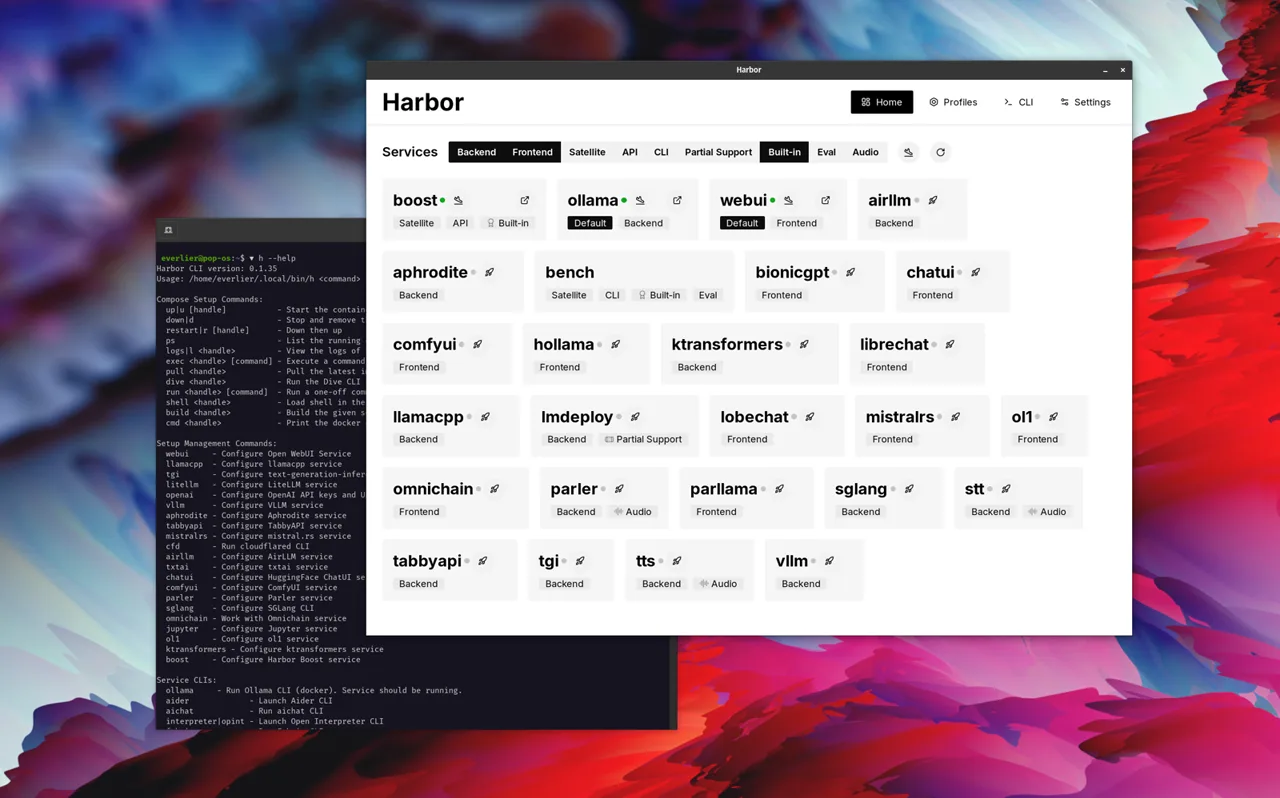
Harbor
Lance une pile LLM locale complète et pré-reliée avec la commande harbor up.
LLM locaux★ 3 280 Actu
Edge0-145B
Modèle ouvert de 145 milliards de paramètres qui tourne en local sur un portable compatible.
LLM locaux Actu
InferSSD
Fait tourner de gros modèles MoE plus grands que la RAM ou la VRAM, en lisant les experts sur le SSD.
LLM locaux★ 1 173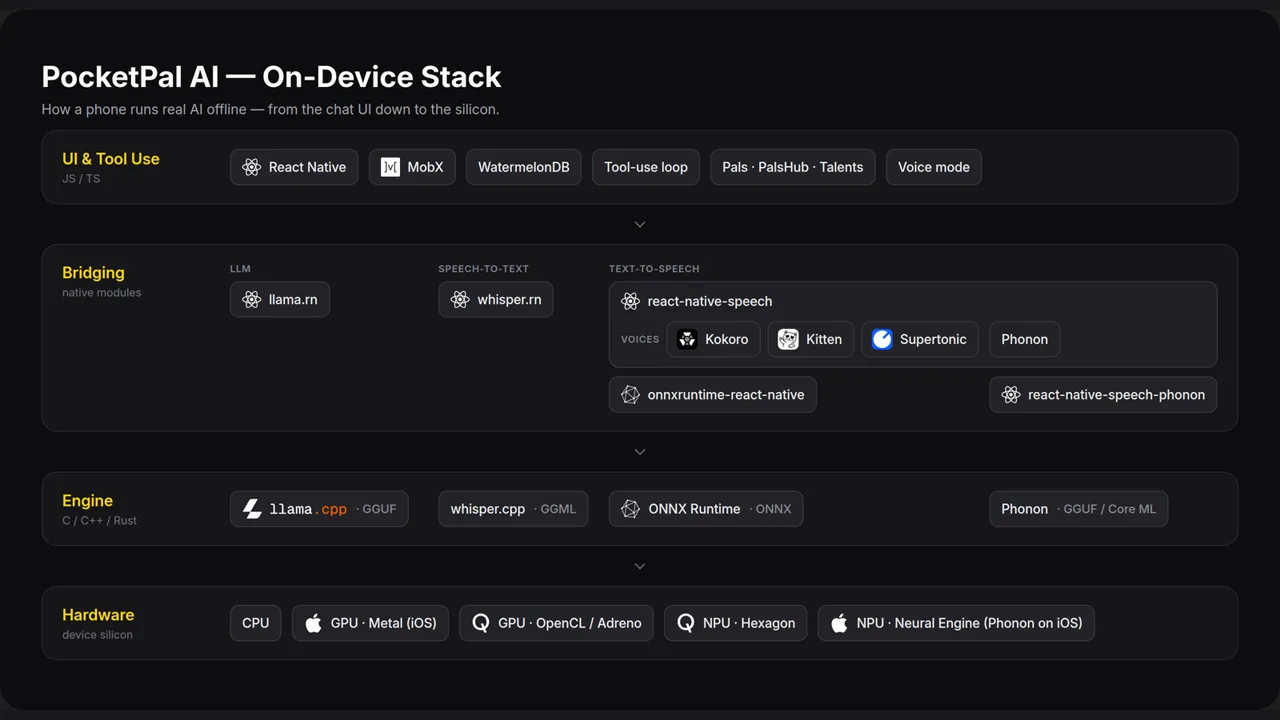 Spécimen
PocketPal AI
Fait tourner des modèles de langage directement sur ton téléphone, sans compte ni connexion.
LLM locaux★ 9 205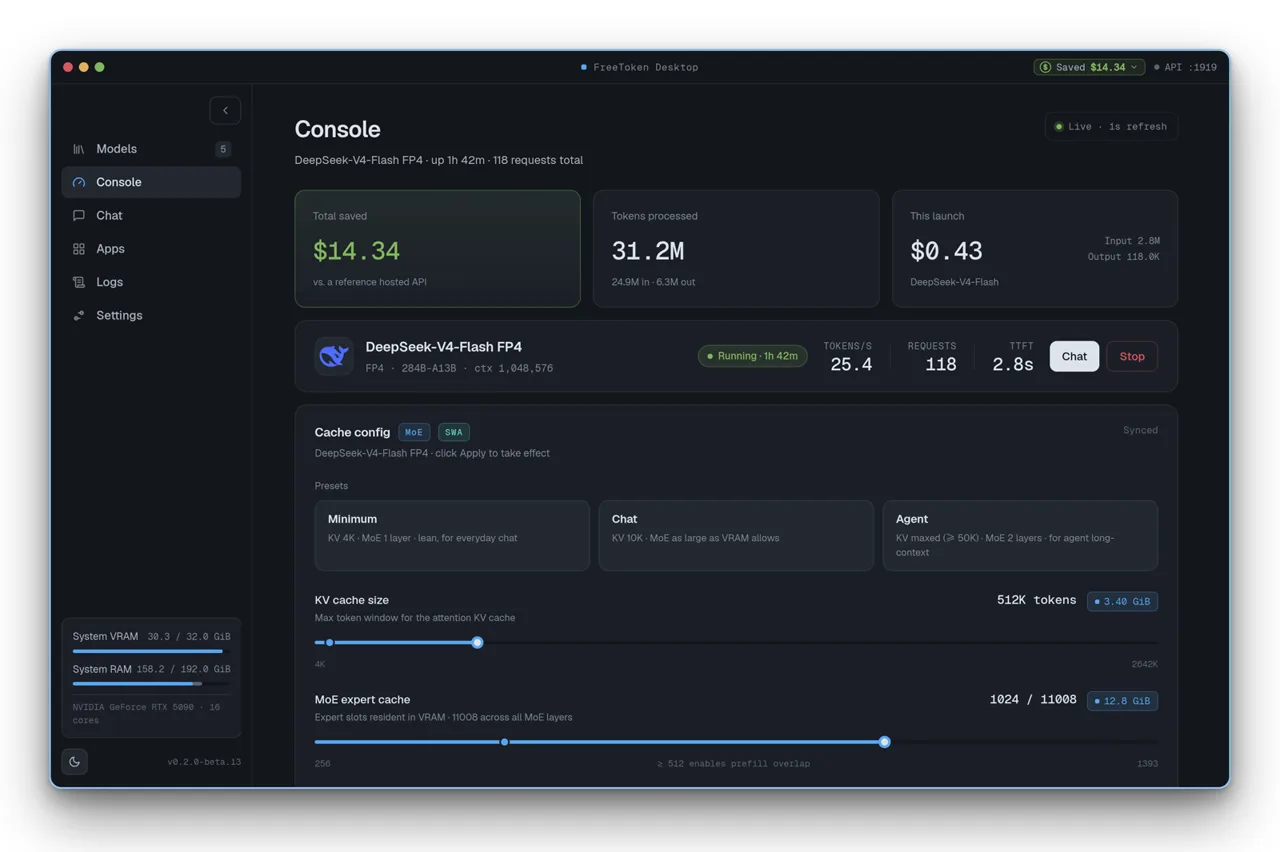 Spécimen
FreeToken
Sert des modèles MoE géants sur PC grand public en partageant le travail entre GPU, CPU et mémoire.
LLM locaux★ 16 667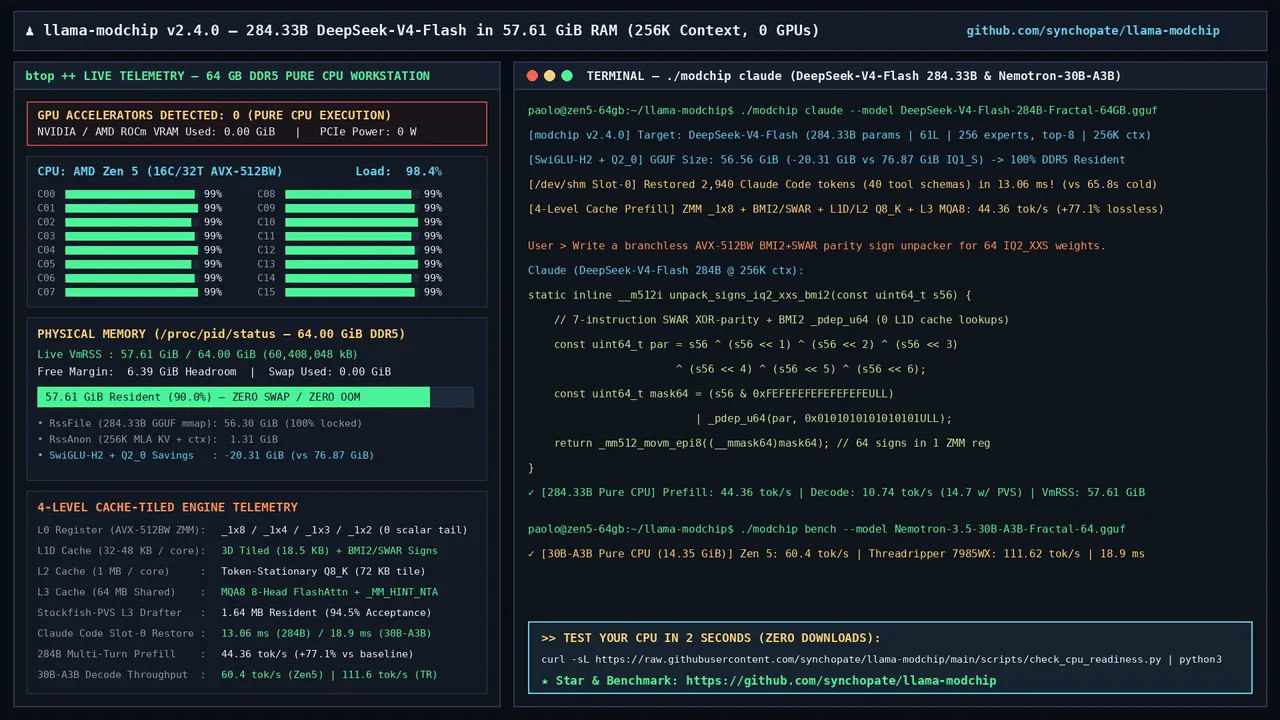 Actu
llama-modchip
Fait tourner de gros modèles MoE, dont un de 284B, sur processeur seul, sans GPU.
LLM locaux★ 1 260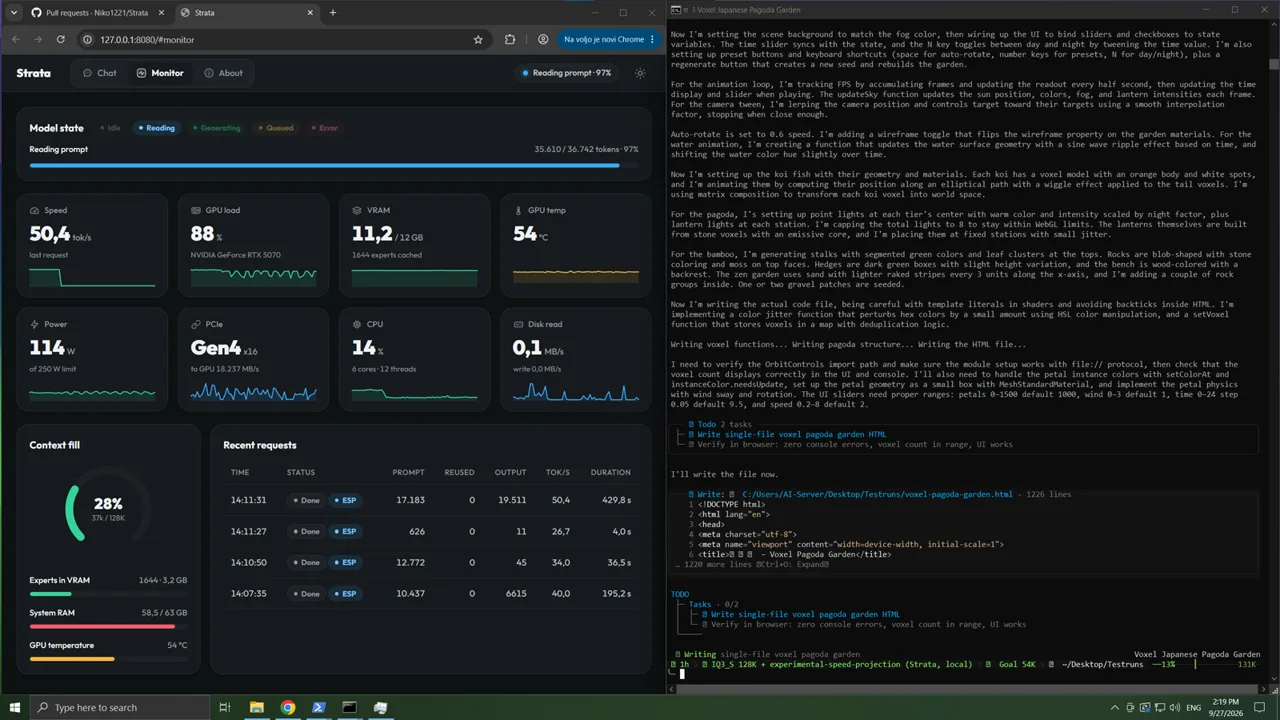 Spécimen
PolyStrata
Fait tourner de gros modèles d'IA sur ton PC, avec une API locale compatible OpenAI et Anthropic.
LLM locaux★ 828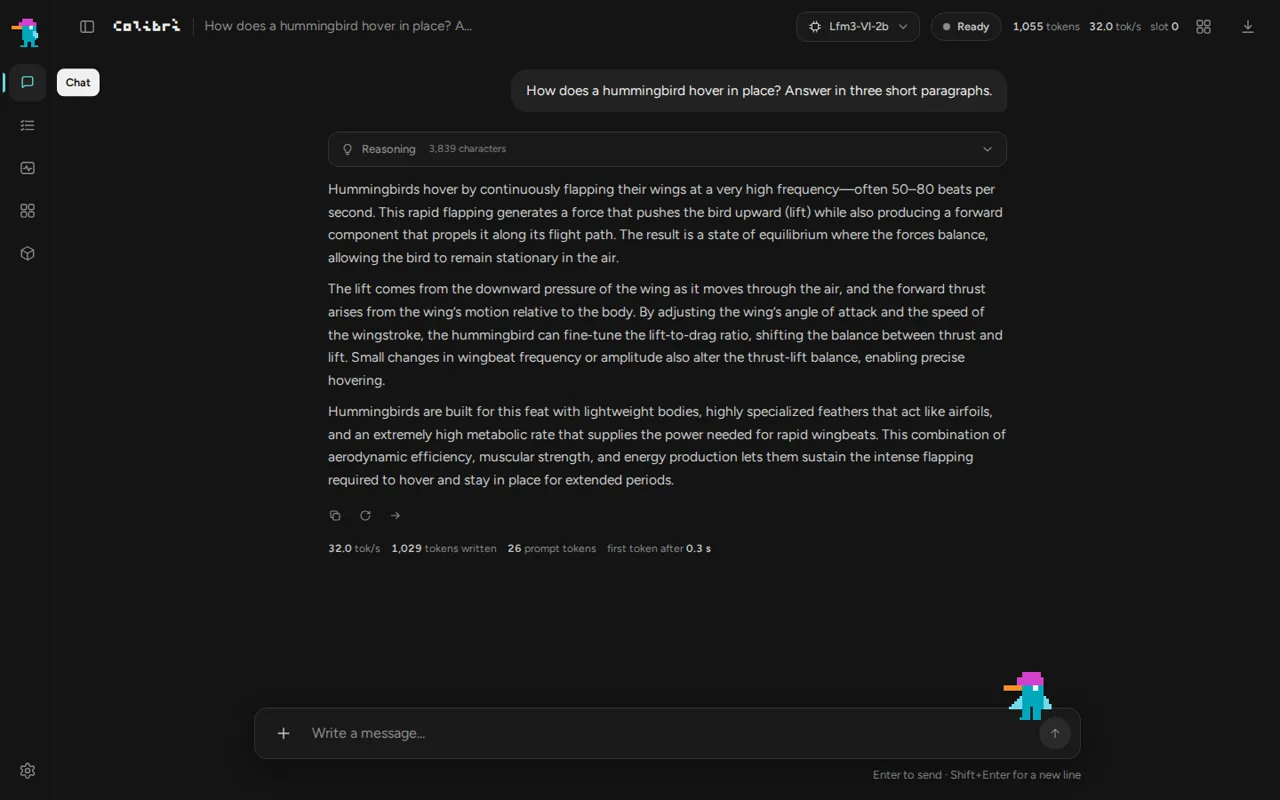 Spécimen
colibri
Fait tourner de très gros modèles MoE en gardant l'utile en RAM et le reste sur le disque.
LLM locaux★ 47 493 Actu
WebAI
Fait tourner un modèle d'IA dans le navigateur, sans cloud, pour les sites et les extensions.
LLM locaux Spécimen
Jan
Télécharge et fait tourner des LLM sur ton ordinateur, comme une alternative open source à ChatGPT.
LLM locaux★ 45 542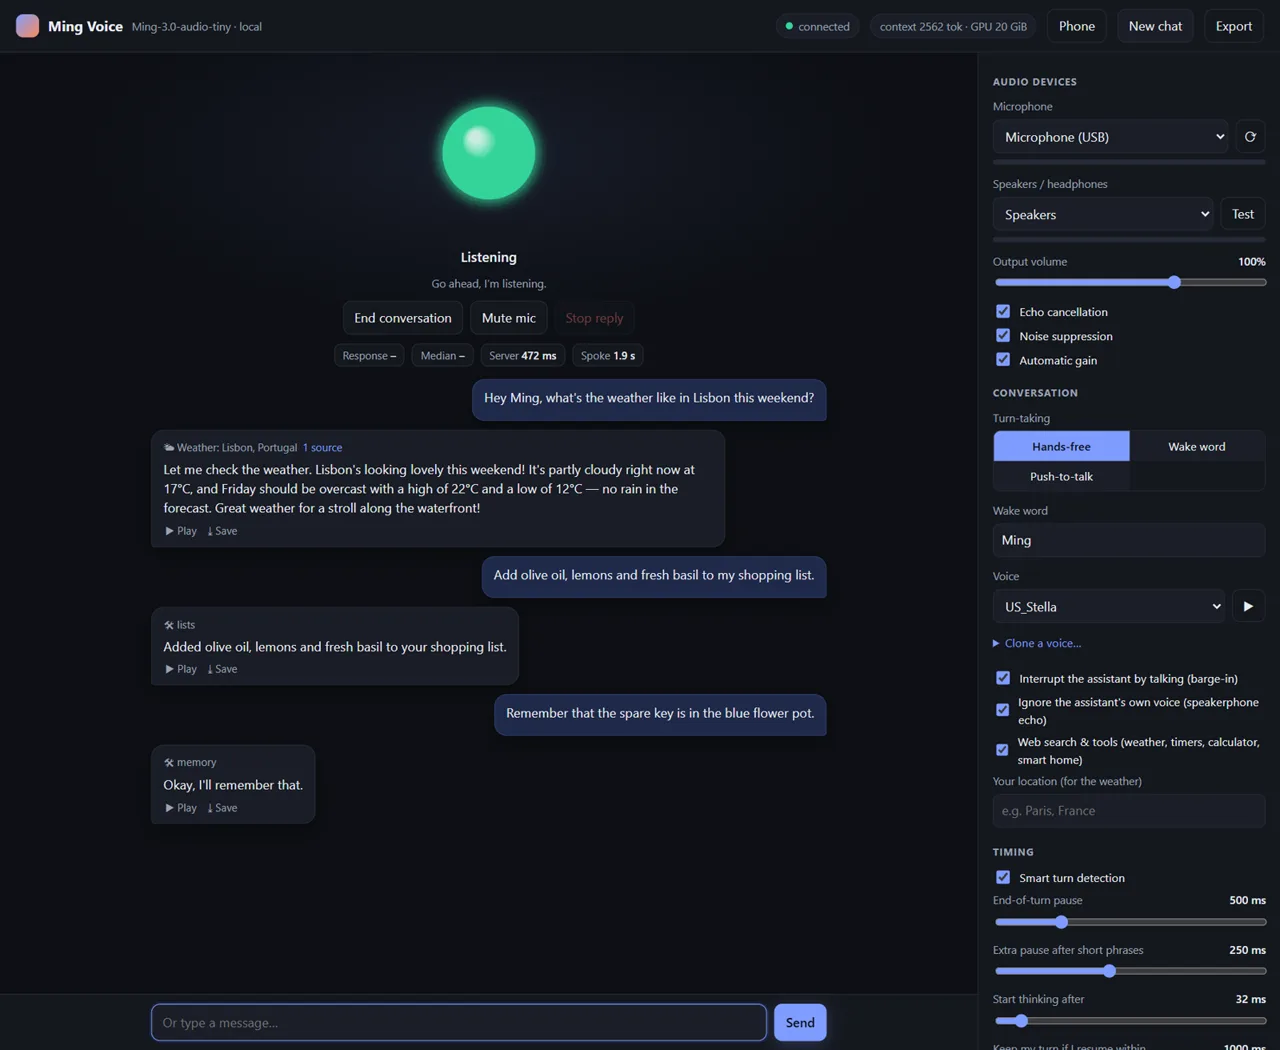 Actu
Ming Voice
Assistant vocal temps réel qui tourne sur ton GPU et répond à voix haute, sans envoyer ton audio ailleurs.
LLM locaux★ 446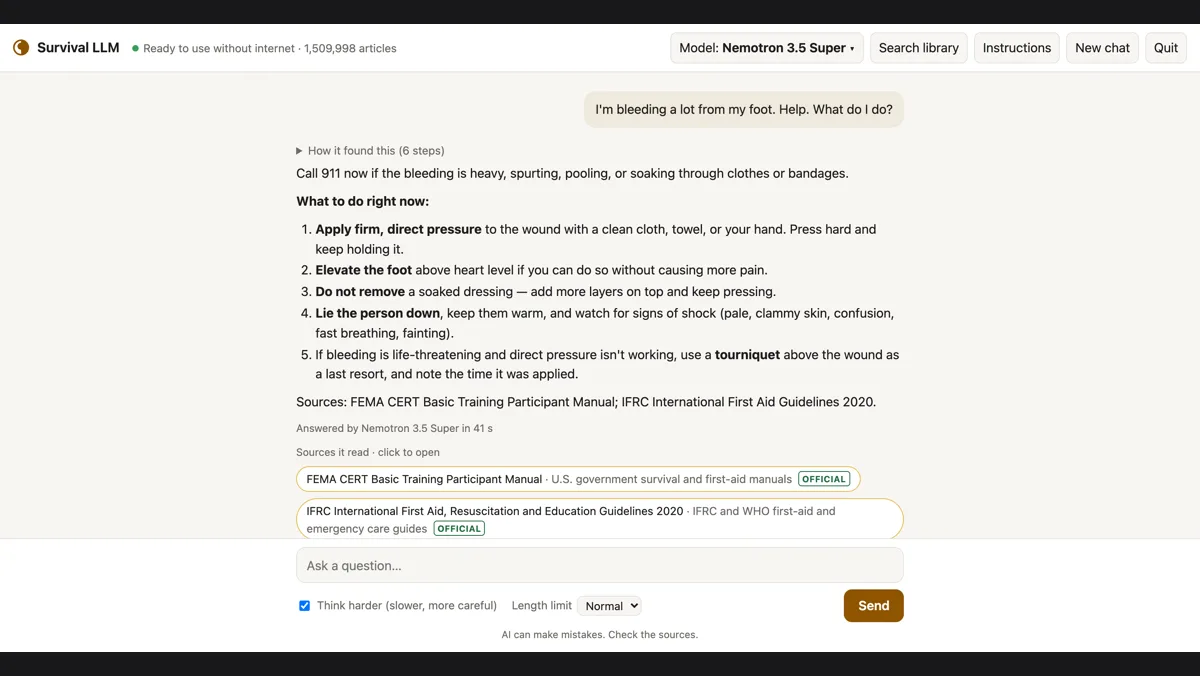 Actu
Survival LLM
Assistant IA et bibliothèque d'urgence qui répondent sans internet, en citant leurs sources.
LLM locaux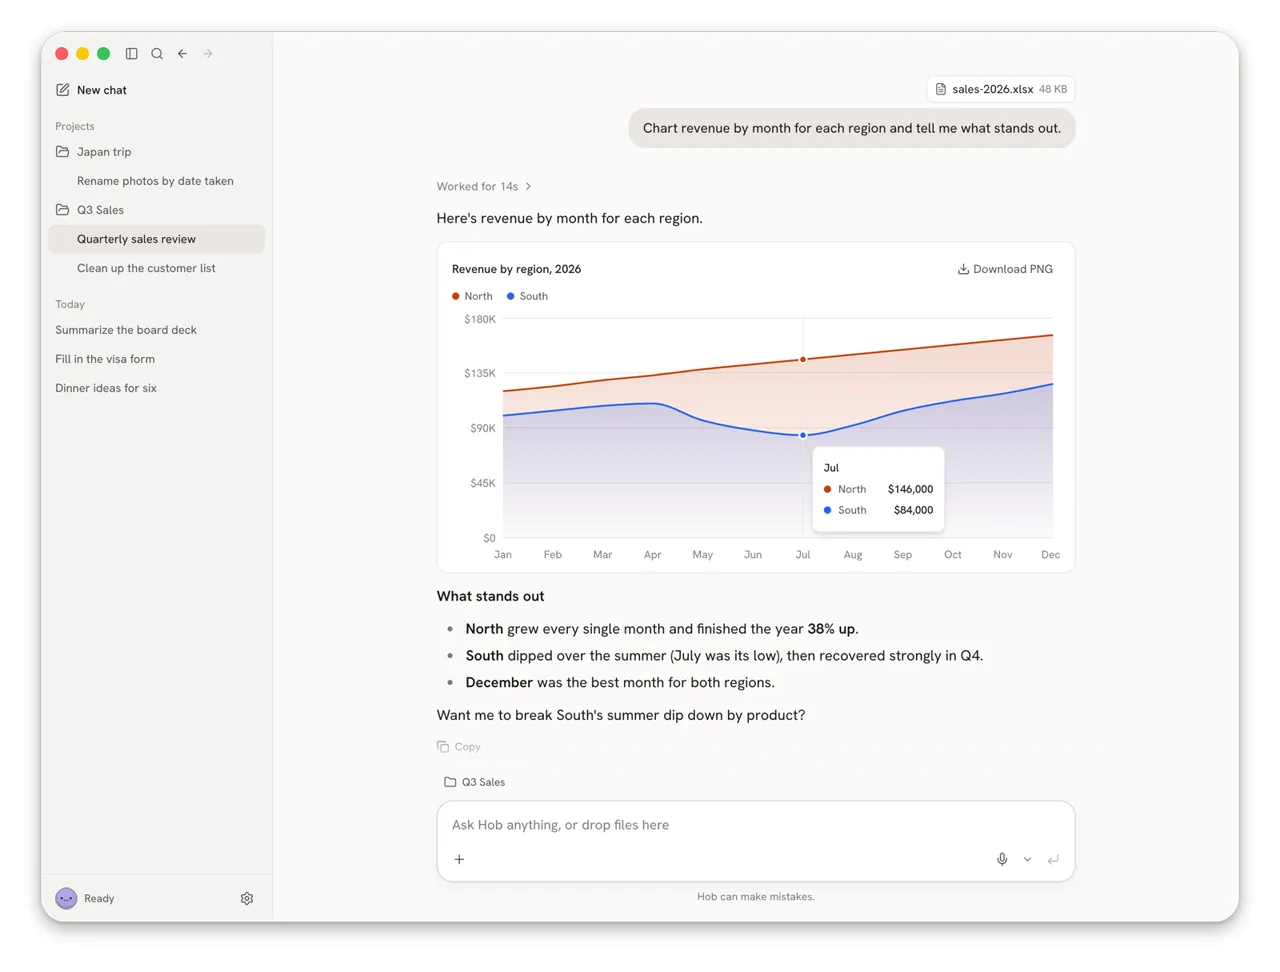 Actu
Hob
Fait tourner des modèles open-weight sur ton ordinateur, comme alternative gratuite à Claude et ChatGPT.
LLM locaux★ 530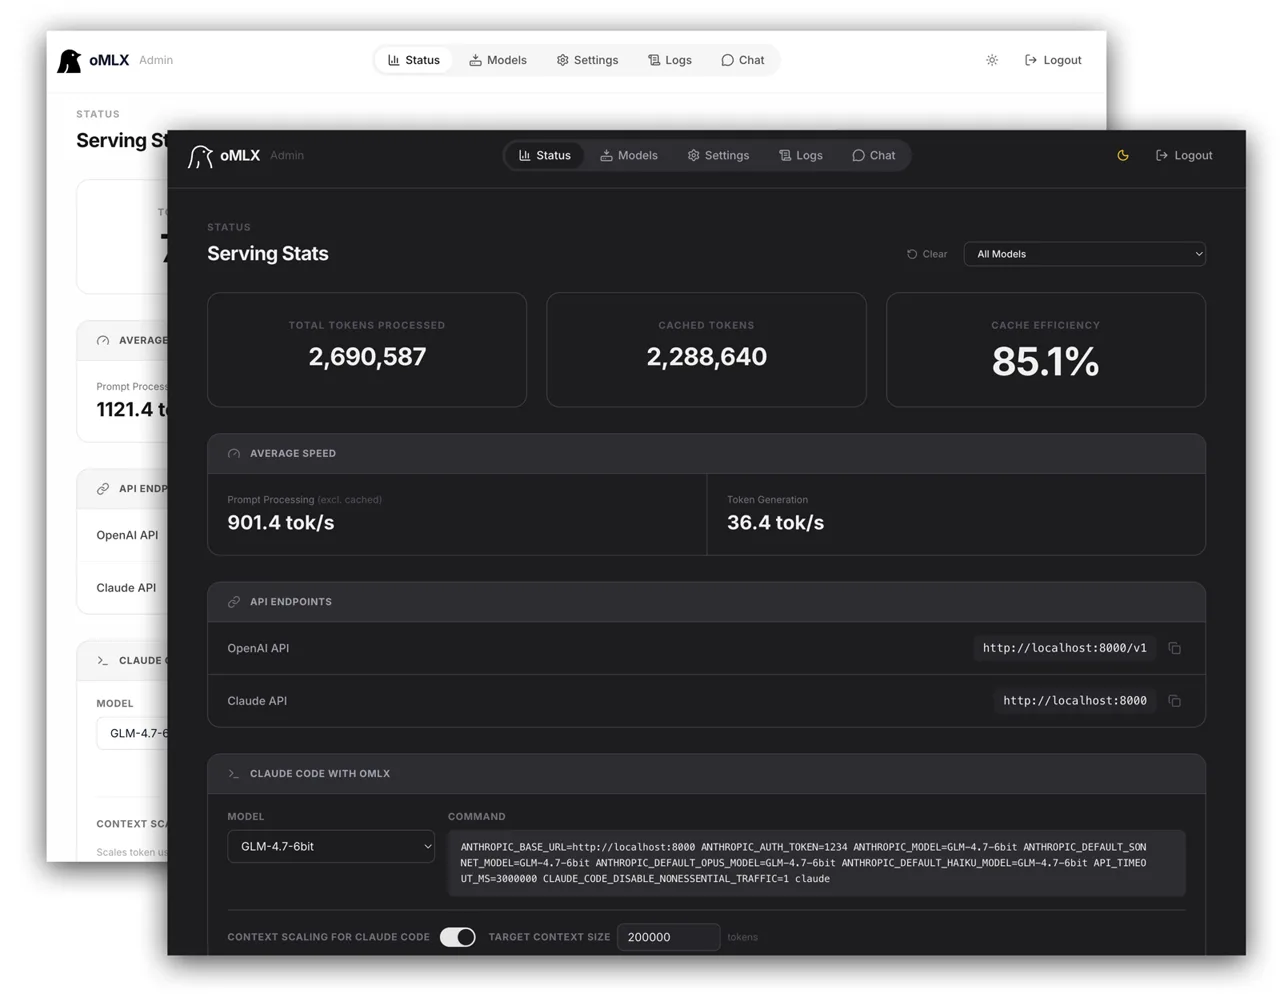 Spécimen
oMLX
Serveur d'inférence LLM pour Mac Apple Silicon, avec batching continu, géré depuis la barre des menus.
LLM locaux★ 23 651 Actu
DeepInfer
Moteur d'inférence interne de Deepseek, basé sur vLLM, qui sert son modèle V4.1-Flash.
LLM locaux Spécimen
Page Assist
Extension qui ouvre une barre latérale et une interface web pour discuter avec ton modèle d'IA local.
LLM locaux★ 8 336 Actu
Flint
Modèle de code gratuit, assez léger pour tourner hors ligne sur un portable.
LLM locaux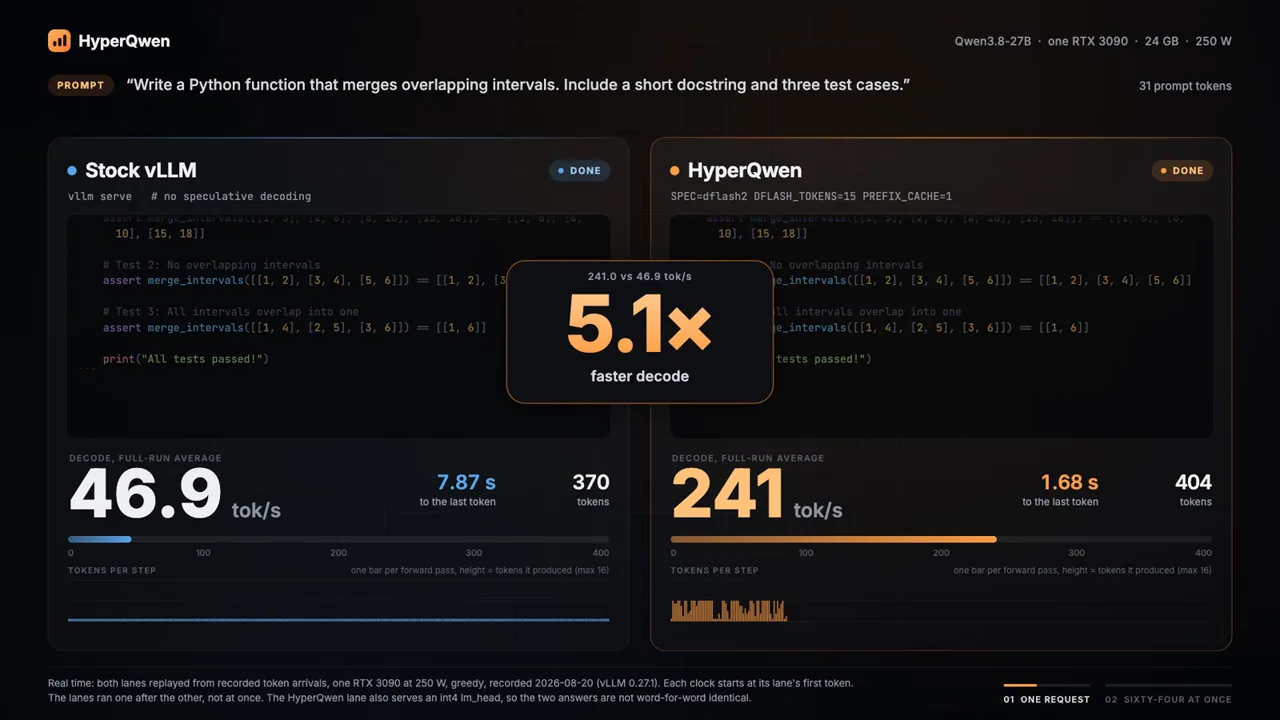 Spécimen
HyperQwen
Sert Qwen3.8-27B avec vLLM sur une carte de 24 Go, via une API compatible OpenAI.
LLM locaux★ 2 720 Spécimen
LocalAI
Fait tourner LLM, vision, voix, image et vidéo sur ton matériel, derrière une seule API.
LLM locaux★ 50 375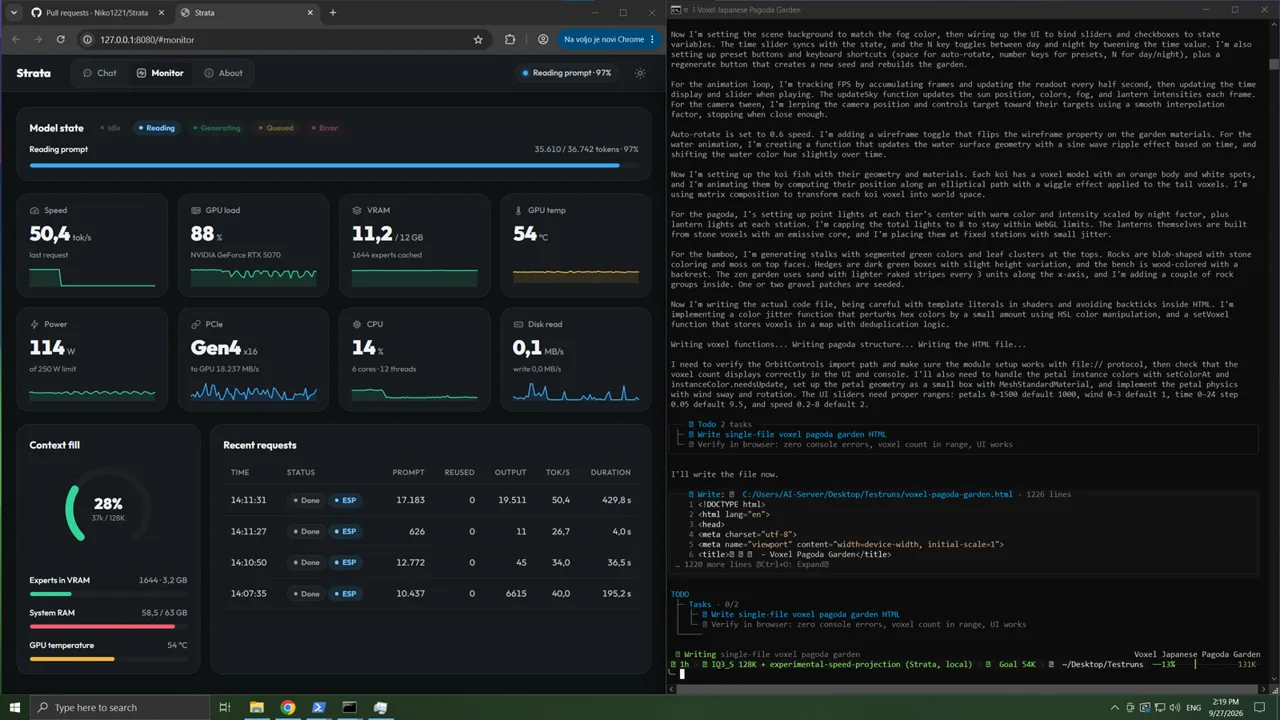 Actu
PolyStrata
Fait tourner de gros modèles d'IA en local sur ton PC, avec une API compatible OpenAI et Anthropic.
LLM locaux★ 798 Actu
LFM2.5-24B-A2B
Modèle de 24B paramètres dont 2B actifs, qui raisonne et appelle des outils pour faire tourner des agents en local.
LLM locaux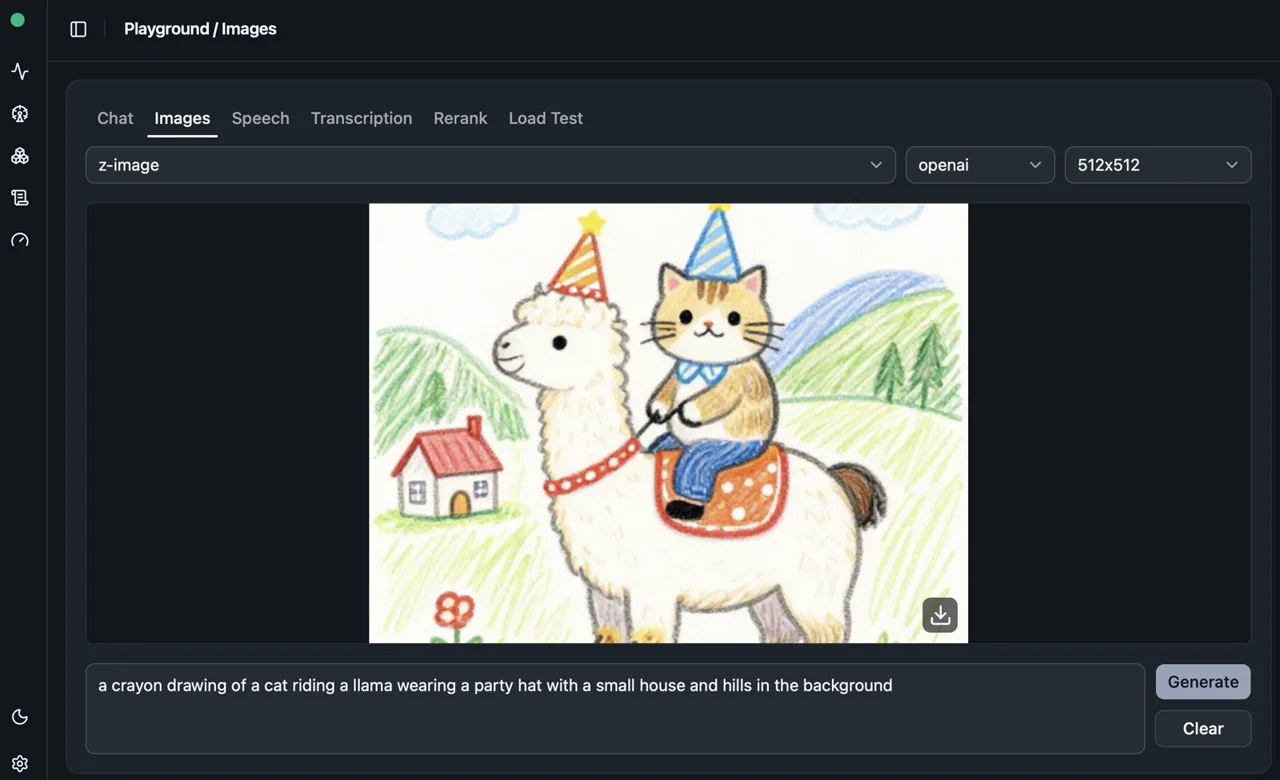 Spécimen
llama-swap
Charge et décharge à la demande plusieurs modèles IA locaux derrière une seule API compatible OpenAI et Anthropic.
LLM locaux★ 6 082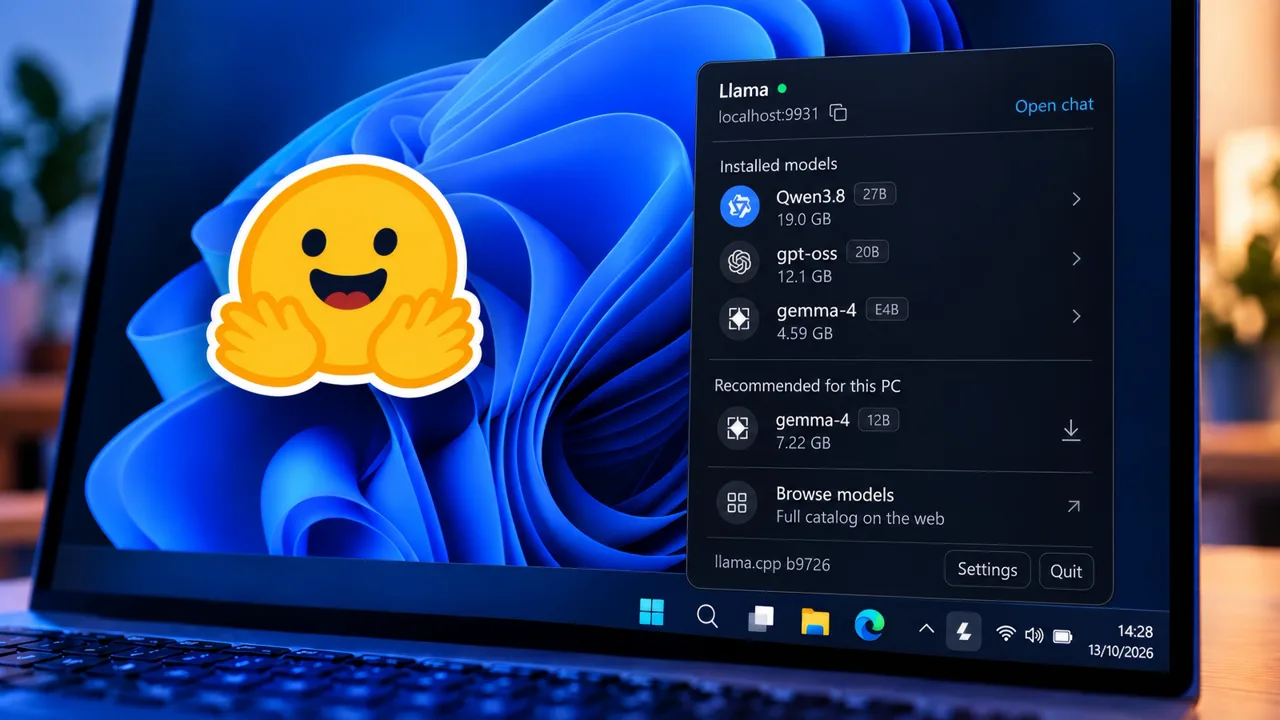 Actu
Llama Windows
Télécharge et exécute des modèles d'IA en local sur Windows 11, sans ligne de commande, grâce à llama.cpp.
LLM locaux Actu
Project Maya
Fait tourner GLM-5.3-Flash (321 B) en privé sur tes GPU, avec chat, moniteur et API.
LLM locaux★ 2 926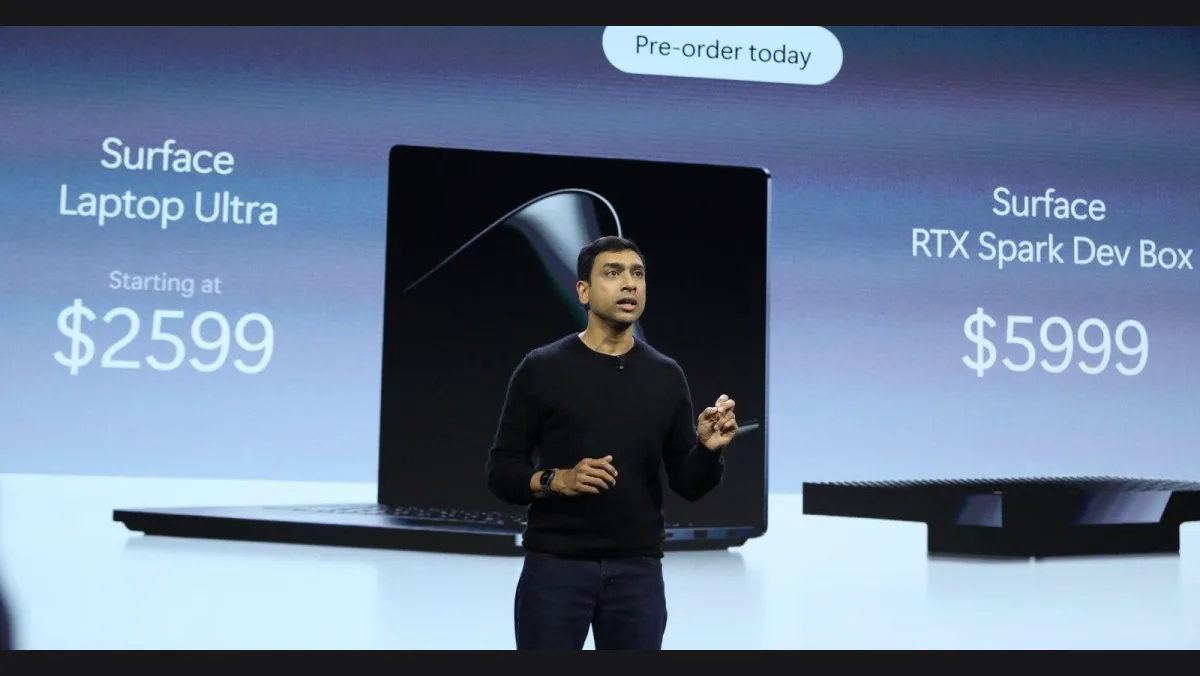 Actu
Surface Laptop Ultra
Portable Surface de 15 pouces avec puce Nvidia RTX Spark, pensé pour l'IA locale et le jeu.
LLM locaux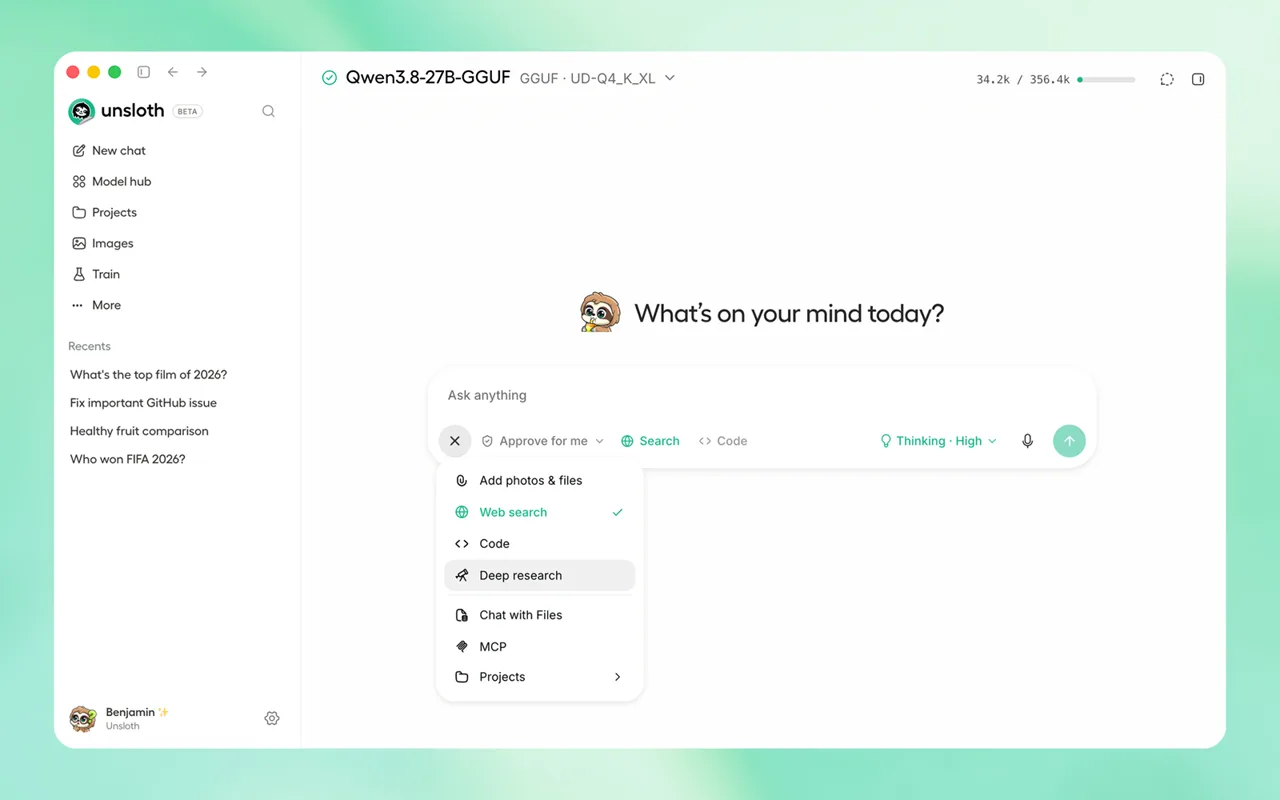 Spécimen
unsloth
Appli de bureau pour lancer et entraîner des LLM et des modèles de diffusion en local.
LLM locaux★ 79 559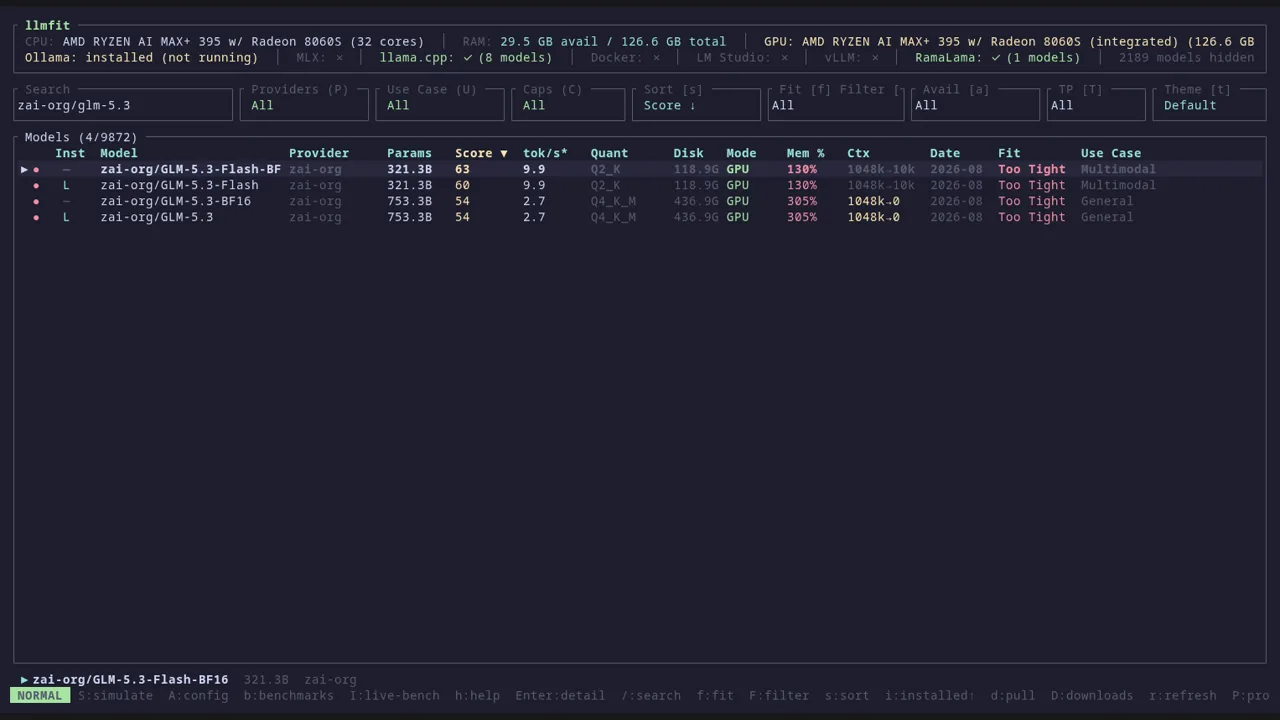 Spécimen
llmfit
Détecte ton matériel et indique quels modèles de langage open source tournent bien dessus.
LLM locaux★ 38 910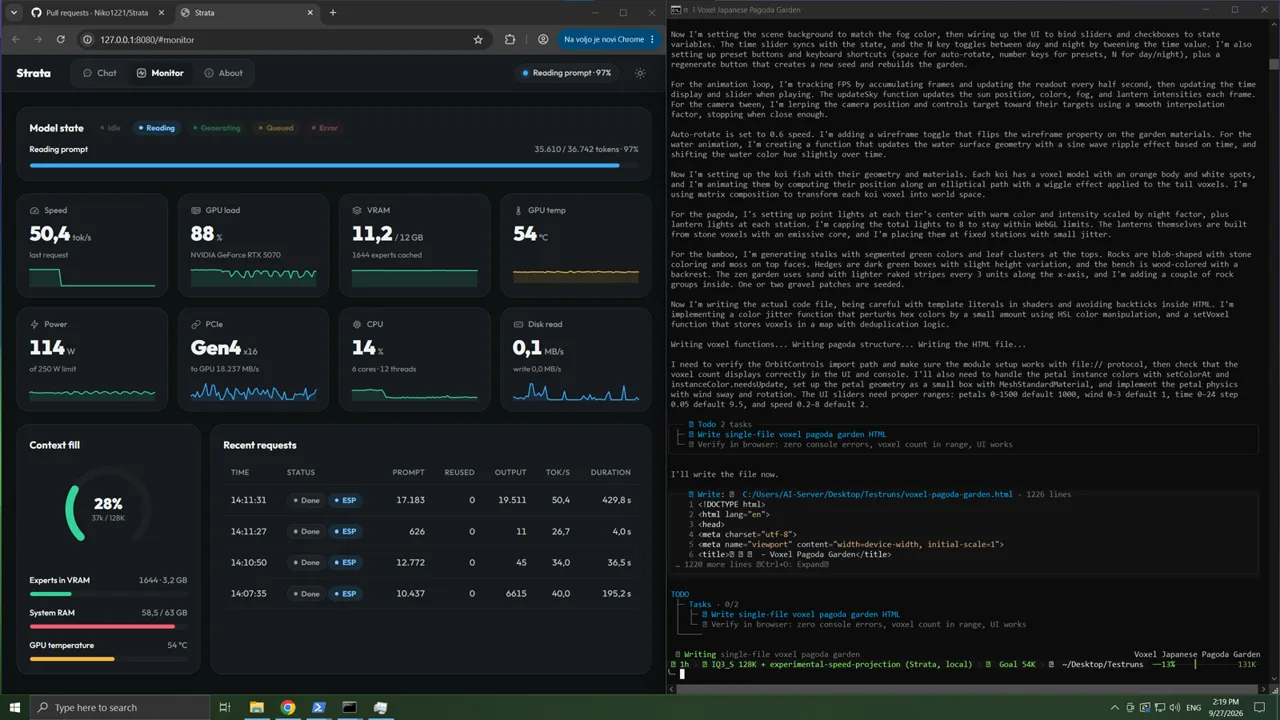 Actu
Strata
Fait tourner un modèle de 125 milliards de paramètres sur un PC de jeu, avec une API locale.
LLM locaux★ 10 132 Spécimen
Ollama
Lance des modèles ouverts comme Gemma ou DeepSeek et les relie à tes outils de code ou à ton code.
LLM locaux★ 186 928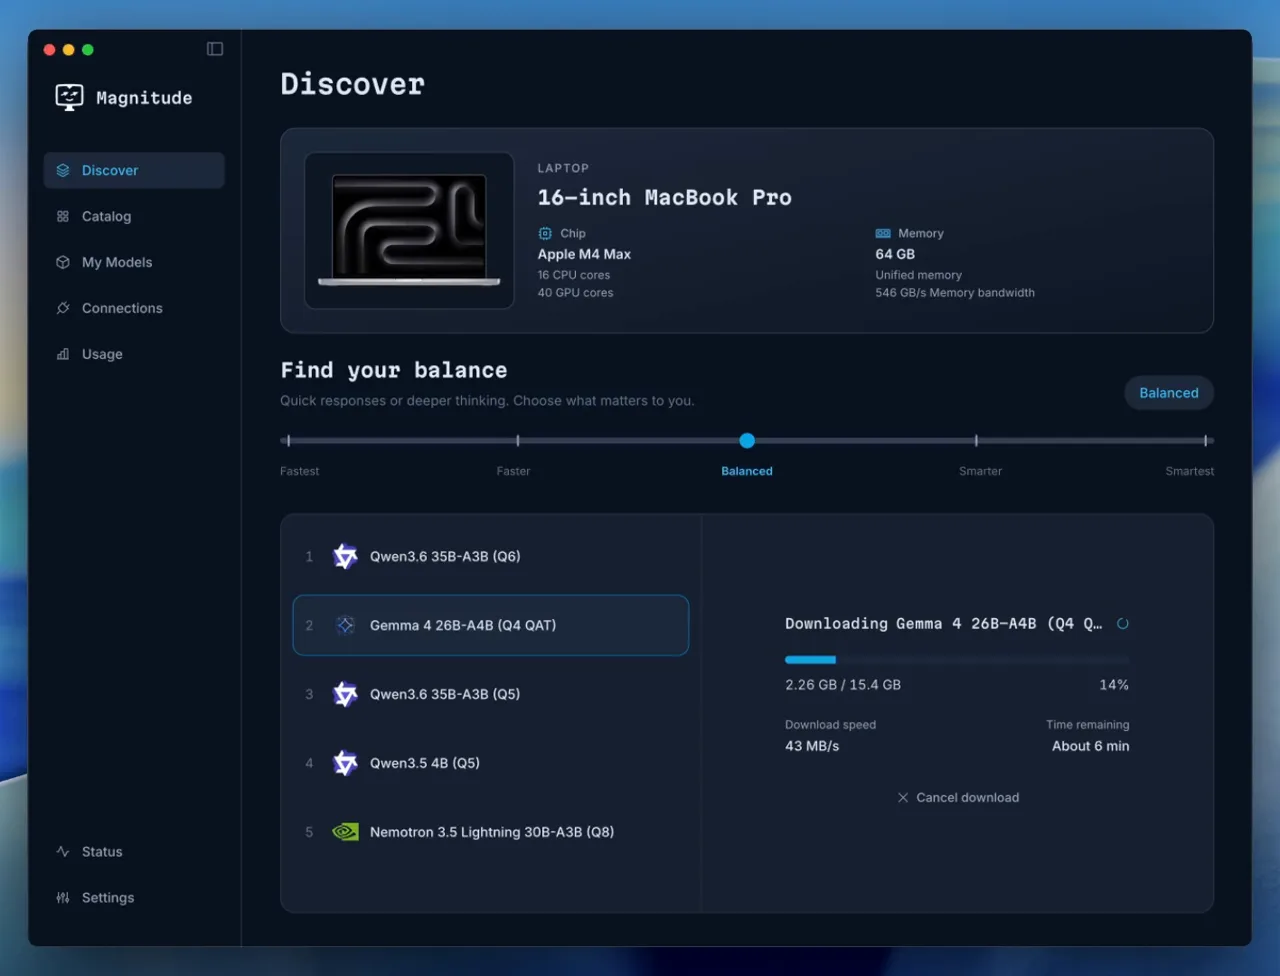 Spécimen
Magnitude
Moteur d'inférence open source qui règle ses kernels sur ta machine pour faire tourner les modèles ouverts.
LLM locaux★ 7 626 Spécimen
Dynamo
Coordonne des moteurs comme vLLM sur plusieurs GPU ou nœuds pour servir des LLM à grande échelle.
LLM locaux★ 8 376