Magnitude est un moteur d’inférence open source, livré sous forme d’application de bureau, qui fait tourner des modèles ouverts sur ta propre machine et les relie aux agents que tu utilises déjà. Sa particularité : il compile et règle ses kernels, les petits programmes de calcul, directement sur ton matériel avant de lancer un modèle. Le projet annonce jusqu’à 2x plus de vitesse que llama.cpp, d’après ses propres mesures.
En bref
- Moteur d’inférence open source (Apache 2.0), écrit surtout en Rust
- Compile et règle ses kernels sur ta machine avant de lancer un modèle
- Mesuré par le projet : +92 % en décodage sur Metal, +19 % sur CUDA face à llama.cpp
- Un clic pour connecter Pi, OpenCode, Hermes, Codex, Claude Code, Cline et d’autres
- Apple Silicon, NVIDIA, AMD ou CPU seul, sans internet une fois le modèle téléchargé
Magnitude, un moteur d’inférence qui s’adapte à ta puce
Pour utiliser un modèle de langage ouvert en local, il faut un programme qui l’exécute : c’est le moteur d’inférence. Magnitude joue ce rôle. Il se présente comme une application de bureau pour macOS, Windows et Linux, qui télécharge des modèles ouverts, les fait tourner sur ton ordinateur et les met à disposition des agents que tu utilises déjà.
Le problème visé est la vitesse. Selon la documentation, les moteurs comme llama.cpp, Ollama ou LM Studio livrent des kernels précompilés pour de grandes familles de matériel. Magnitude compile et règle les siens sur ta machine, pour qu’ils correspondent à ta puce exacte.
Comment fonctionne Magnitude
Avant qu’un modèle ne démarre, Magnitude règle ses kernels sur ton matériel. Les notes de la version 0.2.4 précisent que ce réglage au premier chargement est limité à environ une minute, quel que soit l’appareil. Auparavant, le premier chargement d’un modèle pouvait durer de 20 à 50 minutes sur une machine sans GPU, en donnant l’impression de se figer.
Le projet écrit aussi à la main des kernels optimisés pour les familles de modèles ouverts les plus répandues. La liste des modèles pris en charge est publiée sur le site du projet. Côté mémoire, la documentation annonce 27 % de mémoire en moins par agent, libérée quand les agents s’arrêtent, et des sessions simultanées qui partagent leurs caches de préfixe pour éviter de ralentir.
Les modèles se chargent à la demande et se déchargent quand ils restent inactifs. La première requête après une pause inclut donc le temps de chargement ; les suivantes réutilisent le contexte mis en cache, et les modèles compatibles profitent du décodage spéculatif. Le bouton Load model, dans My Models, permet de charger un modèle à l’avance.
Les mesures face à llama.cpp
Le projet publie un comparatif avec llama.cpp, réalisé avec Qwen 3.6 35B A3B en 4 bits, un contexte de 64k et sans décodage spéculatif. Le préremplissage correspond au traitement de ton prompt, le décodage à la génération de la réponse. Ces chiffres sont ceux du projet lui-même, pas d’une mesure indépendante.
Il ne s’agit que de deux machines et d’un seul modèle : la source ne détaille pas d’autres configurations.
- Mac M4 Pro 48 Go (Metal) : préremplissage de 466 à 507 tok/s (+9 %), décodage de 30 à 57 tok/s (+92 %)
- DGX Spark (CUDA) : préremplissage de 2 033 à 2 507 tok/s (+23 %), décodage de 49 à 58 tok/s (+19 %)
Installer Magnitude et connecter un agent
L’installation passe par l’application de bureau, qui inclut déjà la commande magnitude : aucune installation séparée n’est nécessaire. Le README donne trois étapes.
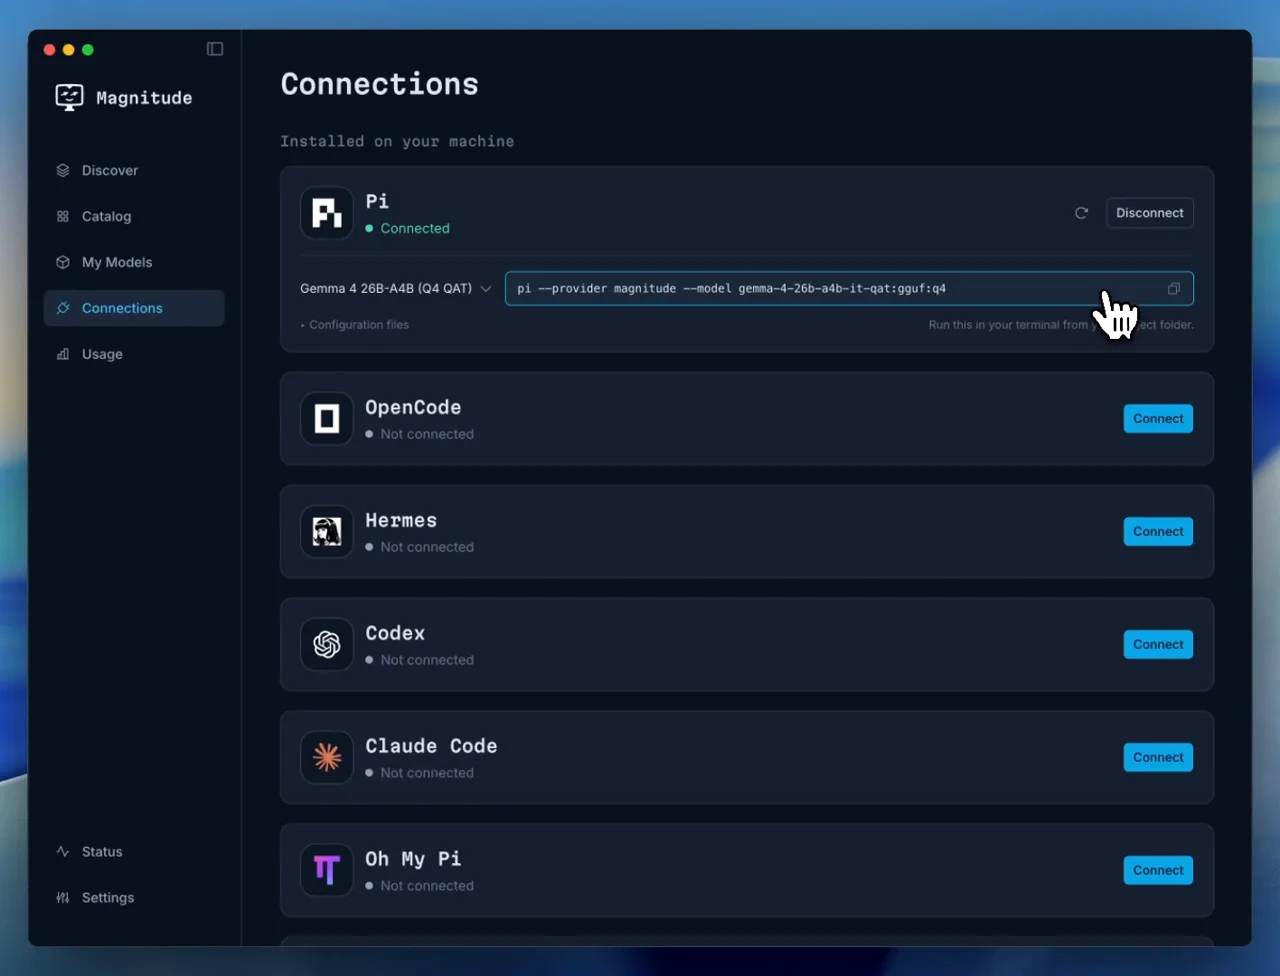
Pour les agents, un clic connecte Pi, OpenCode, Hermes, OpenClaw, Codex, Claude Code, Oh My Pi et Cline. Tout autre outil peut passer par l’API compatible OpenAI. Il est aussi possible d’utiliser Magnitude depuis un autre ordinateur, un conteneur ou WSL en activant Network access, mais seule l’inférence est alors accessible. Le dossier des modèles peut être déplacé sur un autre disque depuis les réglages (Model storage).
- Télécharger Magnitude, l’installer et ouvrir l’application
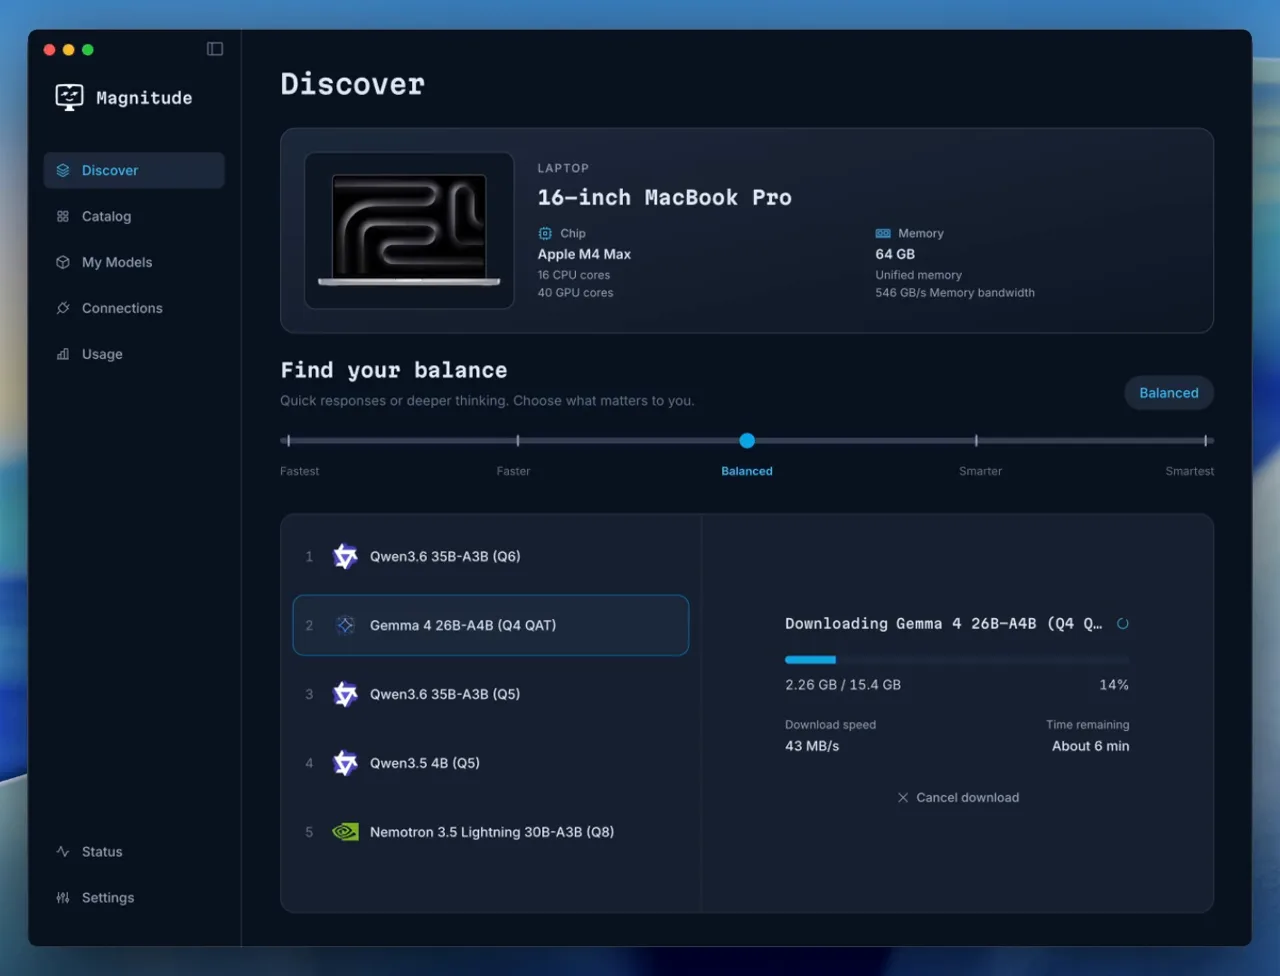
- Choisir un modèle recommandé dans Discover et le télécharger
- Connecter ton agent dans Connections, puis l’utiliser
Pour qui et pour quels usages
Magnitude s’adresse à qui veut faire tourner des modèles en local avec des agents, sans payer de jetons : la source indique que les prompts, les fichiers et les modèles restent sur la machine et qu’aucune connexion internet n’est nécessaire une fois le modèle téléchargé. Les prix ne sont pas détaillés au-delà de la mention « free », mais le projet est sous licence Apache 2.0.
Côté matériel, la source cite les GPU Apple Silicon, NVIDIA ou AMD, ou un simple CPU. Il n’y a pas de minimum fixe : les petites machines font tourner de petits modèles, et plus de mémoire permet d’en lancer de plus gros.
Où en est le projet
Le dépôt a été créé le 12 juin 2026. Au relevé du 3 octobre 2026, il compte 6 314 étoiles, 426 forks, 11 contributeurs et 34 tickets et demandes de fusion ouverts. Le code est écrit à 56 % en Rust, 17 % en TypeScript, 11 % en Python et 8 % en C++. La dernière version, @magnitudedev/cli@0.2.5, date du 3 octobre 2026.
Les versions récentes corrigent surtout la compatibilité et la mémoire. La 0.2.5 accélère la génération des modèles à mélange d’experts avec prédiction de plusieurs tokens, et double environ la vitesse de traitement des prompts sur les Mac M5 et suivants. La 0.2.4 réduit la mémoire nécessaire au-delà des poids du modèle : pour Qwen3.5-4B, la mémoire de travail passe de 3,7 Go à 120 Mo. Elle fait aussi renvoyer une erreur 503 avec Retry-After quand une requête échoue en cours de route, afin que les agents réessayent automatiquement. La 0.2.3 corrige l’installeur sous Windows 10.
Ce qu’il faut savoir avant de se lancer
Le projet est jeune et publie des correctifs presque chaque jour, dont plusieurs concernent des Mac M1 et M2 où certains modèles ne se chargeaient pas. Les notes de la 0.2.5 indiquent des corrections sur ces puces.
Le premier chargement peut prendre du temps à cause du réglage des kernels, et la première réponse après une pause inclut le chargement du modèle. Les gains annoncés dépendent du matériel et du modèle : la source ne précise ni les résultats sur AMD ni ceux d’un CPU seul.
Quelques repères
- Inférence : C’est l’étape où un modèle d’IA déjà entraîné est utilisé pour produire une réponse à partir d’une question. Un moteur d’inférence est le programme qui exécute cette étape.
- Kernel : Un kernel est un petit programme de calcul, exécuté par un processeur ou une carte graphique, qui réalise une opération précise du modèle. Sa vitesse dépend de son adaptation au matériel.
- Token : Un token est un morceau de texte, souvent un mot ou une partie de mot, que le modèle lit et produit. La vitesse se mesure souvent en tokens par seconde.
Questions fréquentes
Magnitude est-il gratuit ?
Oui, d’après le projet : Magnitude est présenté comme gratuit, sans coût de jetons, et open source sous licence Apache 2.0. La source ne détaille pas d’autre offre.
Magnitude est-il plus rapide que llama.cpp ?
D’après les mesures du projet, oui : +92 % en décodage sur un Mac M4 Pro (Metal) et +19 % sur un DGX Spark (CUDA), avec Qwen 3.6 35B A3B en 4 bits. Ce sont des mesures du projet sur un seul modèle.
Quel matériel faut-il pour faire tourner Magnitude ?
Un GPU Apple Silicon, NVIDIA ou AMD, ou simplement un CPU, sous macOS, Windows ou Linux. Il n’y a pas de minimum fixe : plus de mémoire permet de lancer de plus gros modèles.
Magnitude fonctionne-t-il sans internet ?
Oui, une fois le modèle téléchargé. Selon la source, les prompts, les fichiers et les modèles restent sur ta machine.
À retenir
Magnitude est un moteur d’inférence open source qui règle ses kernels sur ta machine et connecte en un clic plusieurs agents à des modèles ouverts locaux. Ses gains face à llama.cpp, +92 % en décodage sur Metal et +19 % sur CUDA, viennent des mesures du projet sur un seul modèle.