Sommaire11 parties
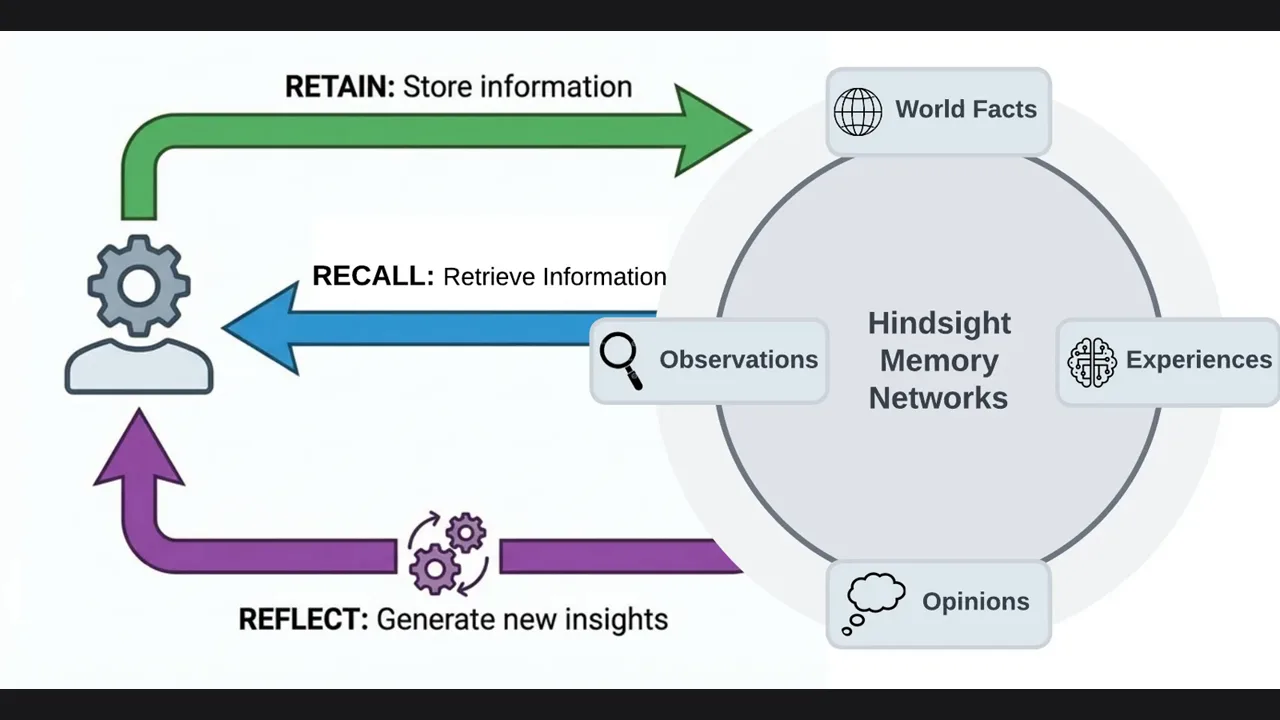
Hindsight est un système de mémoire open source pour agents IA, publié sous licence MIT par Vectorize. Son but : qu’un agent apprenne avec le temps, et pas seulement qu’il retrouve l’historique de ses conversations. Il se lance avec Docker et se pilote par trois opérations, retain, recall et reflect.
En bref
- Un serveur de mémoire à long terme pour agents IA, sous licence MIT
- Trois opérations : retain pour stocker, recall pour chercher, reflect pour raisonner
- Les faits sont consolidés en observations, puis en pages de connaissance
- Plus de 25 fournisseurs de LLM, dont ollama, lmstudio et llamacpp en local
- Version v0.10.2 publiée le 29 septembre 2026
Hindsight, une mémoire d’agent IA qui apprend
Un agent IA oublie tout d’une session à l’autre : chaque conversation repart de zéro, sans rien savoir de la personne ni de ce qui s’est déjà dit. Hindsight s’attaque à ce problème en donnant à l’agent une mémoire à long terme. Le README précise que la plupart des systèmes de mémoire se concentrent sur le rappel de l’historique, alors que Hindsight veut produire des agents qui apprennent.
La documentation explique pourquoi une simple recherche vectorielle ne suffit pas. Une question comme « Qu’a fait Alice au printemps dernier ? » demande un raisonnement sur le temps, pas seulement une proximité de sens. De même, savoir qu’Alice travaille chez Google et que Google est à Mountain View doit permettre de répondre à « Où travaille Alice ? », même si cette phrase n’a jamais été stockée telle quelle.
Comment fonctionne Hindsight : retain, recall, reflect
Hindsight ne conserve pas les conversations brutes. Avec retain, un modèle de langage en extrait des faits, des dates, des entités et des relations, qui sont ensuite normalisés et indexés. Chaque fait est relié aux entités qu’il mentionne et aux autres faits qui les partagent, ce qui permet de répondre à partir de deux faits qui n’ont jamais été enregistrés ensemble.
recall retrouve des souvenirs en lançant quatre recherches en parallèle : sémantique, par mots-clés (BM25), par graphe d’entités et par période. Les résultats sont fusionnés selon leur rang et non selon leur score, puis reclassés par un modèle de type cross-encoder. Le tout est coupé à un budget en tokens plutôt qu’à un nombre fixe de résultats, car un agent raisonne en quantité de contexte disponible.
reflect va plus loin : il renvoie une réponse, pas une liste de souvenirs. Il lance une boucle où l’agent choisit ses propres outils, jusqu’à dix tours, consulte d’abord les modèles mentaux et les pages de connaissance, puis les observations, et enfin les faits bruts. Il cite uniquement les éléments qu’il a réellement récupérés.
from hindsight_client import Hindsight
client = Hindsight(base_url="http://localhost:8888")
# Retain: Store information
client.retain(bank_id="my-bank", content="Alice works at Google as a software engineer")
# Recall: Search memories
client.recall(bank_id="my-bank", query="What does Alice do?")
# Reflect: Generate disposition-aware response
client.reflect(bank_id="my-bank", query="Tell me about Alice")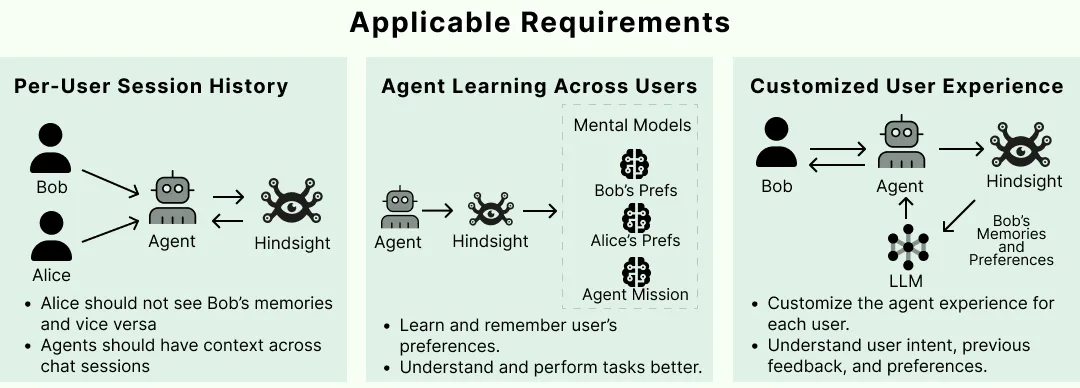
Faits, observations et pages de connaissance
Hindsight distingue plusieurs niveaux de mémoire. Les faits sont de deux sortes : les faits sur le monde (« Alice travaille chez Google ») et les expériences, c’est-à-dire ce que l’agent a lui-même fait. Au-dessus, les observations sont des croyances consolidées à partir de nombreux faits, avec les citations exactes qui les appuient et un compteur de preuves.
Un processus d’arrière-plan fusionne les faits qui se recoupent au lieu de les empiler. Quand une nouvelle preuve arrive, l’observation est affinée sans être écrasée : son historique est conservé, ce qui permet de voir une croyance évoluer. La documentation donne l’exemple d’un utilisateur d’abord enthousiaste de React, qui est passé à Vue.
Viennent ensuite les modèles mentaux, des réponses permanentes à une question que tu définis une fois, et les pages de connaissance, des documents vivants que la mémoire écrit sur elle-même, rangés en dossiers comme un wiki. La commande hindsight fs mount les projette sur le disque sous forme de fichiers markdown ordinaires.
Chaque mémoire vit dans une bank, un espace isolé pour un utilisateur, un agent ou un projet, sans fuite d’une bank à l’autre. Une bank porte une mission, des directives (règles à ne jamais enfreindre) et une disposition réglée de 1 à 5 sur le scepticisme, le littéralisme et l’empathie. Ces réglages n’influencent que reflect : recall renvoie les mêmes souvenirs quel que soit celui qui demande.
Installer Hindsight avec Docker ou pip
Le README recommande Docker. La commande ci-dessous démarre l’API sur le port 8888 et l’interface sur le port 9999, avec un volume pour conserver les données. Hindsight s’appuie sur PostgreSQL avec pgvector, et une base embarquée est incluse dans cette configuration.
D’autres modes existent : Docker avec un PostgreSQL externe, pip, Kubernetes avec Helm, ou le service hébergé Hindsight Cloud. Les clients officiels existent pour Python, Node.js, TypeScript, Go et en ligne de commande. Le paquet hindsight-all permet aussi un mode embarqué en Python, sans serveur séparé.
- Linux (x86_64, ARM64), macOS Apple Silicon et Windows (x86_64) sont pris en charge avec Docker, pip et la base embarquée
- Sur les Mac Intel, l’installation par pip est signalée par un avertissement : le README conseille
hindsight-all-slim - Le choix du fournisseur de LLM se fait avec
HINDSIGHT_API_LLM_PROVIDER
export OPENAI_API_KEY=sk-xxx
docker run -it --pull always --name hindsight --restart unless-stopped -p 8888:8888 -p 9999:9999 \
  -e HINDSIGHT_API_LLM_API_KEY=$OPENAI_API_KEY \
  -v hindsight-data:/home/hindsight/.pg0 \
  ghcr.io/vectorize-io/hindsight:latest
Brancher Hindsight à un agent existant
Le moyen le plus simple d’ajouter de la mémoire à un agent existant est le LLM Wrapper, installé avec pip install hindsight-litellm. On remplace son client de modèle par un client enveloppé : les souvenirs sont alors rappelés avant chaque appel et la conversation est retenue après. wrap_openai() et wrap_anthropic() couvrent les deux kits de développement concernés, et LiteLLM, placé dessous, ouvre l’accès à plus de 100 modèles. Pour décider soi-même quand stocker et rappeler, les SDK et l’API REST restent disponibles.
Chaque serveur expose aussi un point d’accès MCP par bank, activé par défaut, qui met retain, recall et reflect à disposition de tout client MCP. Le README annonce plus de 60 intégrations, dont des agents de code, des frameworks d’agents comme LangGraph ou CrewAI, et des outils sans code comme n8n.
Pour les agents de code en ligne de commande, un paquet construit une mémoire de projet par dépôt, à partir de l’historique git et des sessions passées. Il s’installe ainsi :
npx @vectorize-io/hindsight-coding-agents install all
npx @vectorize-io/hindsight-coding-agents install claude-code
Où en est le projet Hindsight
Le dépôt a été créé le 30 octobre 2025. Au relevé du 2 octobre 2026, il compte 44 574 étoiles, 5 863 forks, 276 contributeurs et 240 tickets et demandes de fusion ouverts. Le code est écrit à 72 % en Python, 18 % en TypeScript, 6 % en MDX et 2 % en Rust.
La dernière version, v0.10.2, date du 29 septembre 2026, après v0.10.1 le 21 septembre et v0.10.0 le 14 septembre. Les notes de ces versions mentionnent entre autres des stratégies de consolidation par périmètre, un réglage par bank pour désactiver la recherche textuelle et ne garder que la recherche vectorielle, une commande hindsight-admin rename-bank, de nombreuses corrections pour le stockage sur Oracle, et un gain de 26 % à 43 % sur chaque rafraîchissement dans reflect.
Ce qu’il faut savoir avant de se lancer avec Hindsight
Hindsight est sous licence MIT. Il a besoin d’un modèle de langage pour extraire les faits : plus de 25 fournisseurs sont pris en charge, hébergés (OpenAI, Anthropic, Gemini…) ou locaux (ollama, lmstudio, llamacpp). Le README ne donne pas de configuration matérielle minimale.
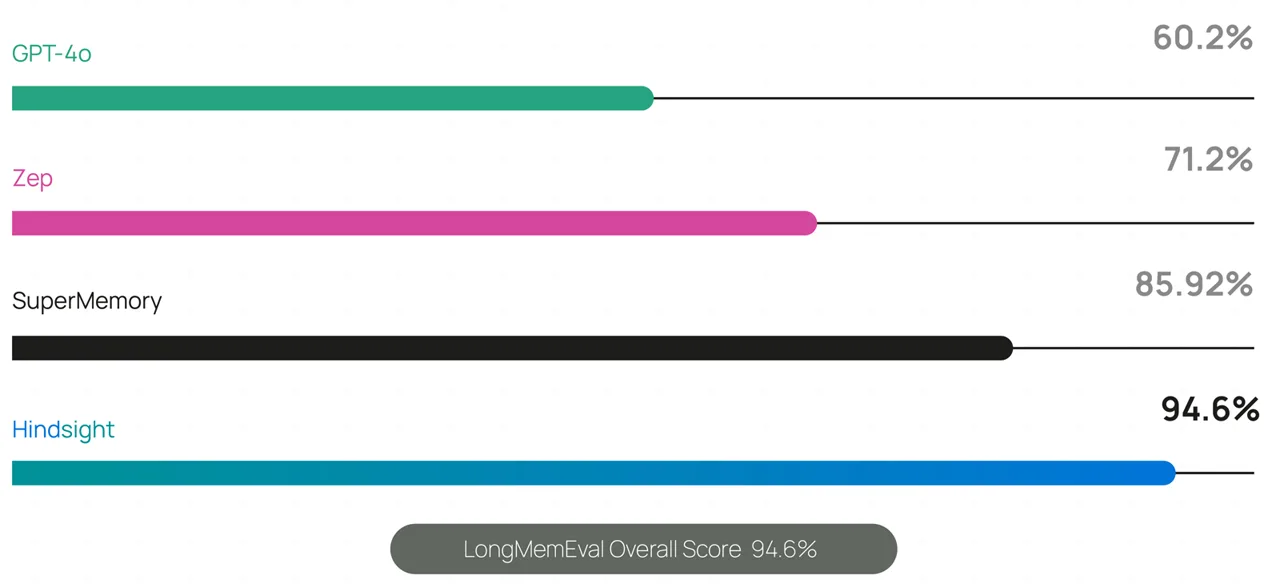
Côté performances, le site du projet publie des résultats sur plusieurs bancs d’essai, par exemple 94,6 % sur LongMemEval-S contre 74,0 % pour le meilleur autre système comparé. Selon le README, ces chiffres ont été reproduits de façon indépendante par des chercheurs de Virginia Tech et du Washington Post, tandis que les scores des autres solutions sont déclarés par leurs éditeurs. Ce sont donc des mesures publiées par le projet lui-même.
Hindsight Cloud, le service hébergé, facture à l’usage, sans abonnement mensuel ni tarif par utilisateur, avec des crédits offerts au départ. La documentation indique 5 dollars de crédit à l’inscription avec GitHub ; le README ne détaille pas de grille tarifaire.
Quelques repères
- Modèle de langage (LLM) : Un programme d’IA entraîné sur de grandes quantités de texte, capable de comprendre et de produire du langage. Il sert ici à lire un texte pour en extraire des informations structurées.
- Recherche vectorielle : Une méthode qui transforme les textes en suites de nombres pour retrouver ceux dont le sens est proche d’une question, même sans mots en commun.
- MCP : Sigle de Model Context Protocol, un standard qui décrit comment un assistant IA se connecte à des outils ou à des sources de données.
Questions fréquentes
Hindsight est-il gratuit ?
Oui pour le code : Hindsight est publié sous licence MIT et peut être auto-hébergé. Le service hébergé Hindsight Cloud facture à l’usage, avec des crédits offerts au départ, dont 5 dollars à l’inscription avec GitHub selon la documentation.
Comment installer Hindsight ?
Le README recommande Docker, avec une image qui expose l’API sur le port 8888 et l’interface sur le port 9999. Hindsight s’installe aussi avec pip, avec Helm sur Kubernetes, ou s’utilise via Hindsight Cloud.
Hindsight fonctionne-t-il avec des modèles de langage locaux ?
Oui. Hindsight accepte plus de 25 fournisseurs de LLM, dont ollama, lmstudio et llamacpp pour un usage entièrement local, ainsi que tout point d’accès compatible OpenAI.
Quelle différence entre recall et reflect dans Hindsight ?
recall renvoie des souvenirs, après quatre recherches menées en parallèle. reflect renvoie une réponse construite par une boucle d’agent qui consulte les modèles mentaux, les observations puis les faits, et cite ce qu’elle a utilisé.
À retenir
Hindsight est un serveur de mémoire sous licence MIT qui transforme des conversations en faits, en observations puis en pages de connaissance, accessibles par retain, recall et reflect. Son activité est soutenue, avec trois versions publiées entre le 14 et le 29 septembre 2026, et ses résultats de benchmark sont publiés par le projet lui-même.
Sources
- vectorize-ioREADME
- hindsight.vectorize.iodocumentation officielle
- GitHubnotes de version