Sommaire11 parties
PolyStrata est un logiciel open source (licence MIT) qui fait tourner sur un PC ordinaire de gros modèles d’IA, de ceux qui demandent d’habitude un serveur. Ils discutent, écrivent du code et se branchent à tes applications et à tes agents de code, sans que rien ne quitte ta machine. Douze modèles sont proposés, sur deux moteurs, avec une installation guidée pour Windows et Linux.
En bref
- Douze modèles sur deux moteurs, dont Qwen3.6, Gemma 4, GLM 5.3 Flash et DeepSeek V4 Flash.
- Qwen3.6-35B-A3B écrit à 94-100 tokens par seconde sur un portable avec une carte de 8 Go.
- Une API compatible OpenAI et Anthropic tourne sur localhost pour tes applications et agents de code.
- Installation guidée sur Windows et Linux ; le second moteur reste expérimental.
- Licence MIT, 899 étoiles sur GitHub au 7 novembre 2026.
Qu’est-ce que PolyStrata ?
PolyStrata permet de faire tourner une IA chez soi. Il charge de gros modèles de langage, qui demandent d’ordinaire un serveur, sur un PC normal. Ils conversent, écrivent du code et travaillent avec tes applications, et rien ne quitte ton PC.
Le projet a été créé par VecSzn et s’appuie sur Strata, de Niko1221. Selon sa FAQ, il existe en dépôt séparé parce que le mainteneur de Strata a répondu que d’autres architectures de modèles (DeepSeek, GLM) n’étaient pas prévues. Ces modèles ont donc reçu un moteur à part, à côté de celui de Strata.
Comment fonctionne PolyStrata
Le projet repose sur deux moteurs. Le premier, celui de Strata repris tel quel, fait tourner Qwen3.8-Flash-Next sur une carte NVIDIA ou AMD de 12 Go ou plus, sous Windows ou Linux. Le second a été écrit pour PolyStrata et fait tourner les onze autres modèles, avec une ou deux cartes NVIDIA.
Ces onze modèles sont des modèles à experts : seule une partie de leurs poids sert à chaque token. Le moteur décide quels experts restent dans la mémoire de la carte graphique et lesquels s’exécutent sur le processeur, ce qui permet de lancer des modèles trop gros pour la carte. Il lit les mêmes fichiers GGUF que llama.cpp, et sa FAQ indique que sa sortie a été comparée à celle de llama.cpp, token par token, sur un même fichier.
Quels modèles et quelle vitesse ?
Les douze modèles sont Qwen3.8-Flash-Next, GLM 5.3 Flash, DeepSeek V4 Flash, LFM2.5-24B-A2B, Flint 40B-A2.5B, Qwen3.6-35B-A3B, Clover-35B-A3B-Preview, Ornith 1.5, Gemma 4 26B-A4B, Tiel Coder 35B-A3B, MiniCPM-V 4.7 35B-A3B et Kolibri 1. Plusieurs lisent aussi les images ; GLM 5.3 Flash, DeepSeek V4 Flash, LFM2.5, Flint, Clover et Kolibri 1 ne lisent que du texte.
Les vitesses du README viennent de deux machines : un portable (RTX 4070 Laptop de 8 Go, 32 Go de RAM) et une station avec une RTX 5090. Pour écrire une réponse, Qwen3.6-35B-A3B atteint 94 à 100 tokens par seconde sur le portable et 394 à 395 sur la RTX 5090. Gemma 4 26B-A4B écrit à 92-93 sur le portable. Sur ce portable, le projet dit lire les prompts 2,7 à 3,5 fois plus vite que llama.cpp et écrire 1,5 à 1,8 fois plus vite, avec Qwen3.6 et Tiel Coder.
GLM 5.3 Flash et DeepSeek V4 Flash sont les plus lourds : leur fichier pèse de 79 à 114 Go pour l’un et 91 Go pour l’autre. Le README précise qu’ils ne tournent pas sur la carte de 8 Go et exigent une carte de 32 Go.
- LFM2.5-24B-A2B : 70-73 tokens/s sur le portable, 480-485 sur la RTX 5090.
- Flint 40B-A2.5B : 61-63 sur le portable, 251-252 sur la RTX 5090.
- Ornith 1.5 : 76-82 sur le portable, 316-319 sur la RTX 5090.
- GLM 5.3 Flash : 59-66 sur la RTX 5090 ; DeepSeek V4 Flash : 56.
Installer PolyStrata
Il faut télécharger le dépôt et le décompresser, ou le cloner avec git. Sous Windows, on double-clique sur START-HERE.bat. Sous Linux, on lance ./setup.sh dans le dossier. L’installateur détecte ta carte, prépare le bon moteur et pose quelques questions : quel modèle et quelle taille, quelle longueur de contexte, et si le modèle doit lire les images. Appuyer sur Entrée à chaque fois donne la réponse recommandée.
Le modèle est ensuite téléchargé, de 11 à 114 Go selon le choix, et la reprise se fait là où le téléchargement s’est arrêté. Ton navigateur ouvre alors l’application de PolyStrata sur l’adresse locale du port 8080. Pendant le démarrage, le PC peut ralentir ou ne plus répondre pendant 1 à 3 minutes, plus longtemps la première fois : c’est normal, précise le README. Un Mac Apple Silicon est possible, mais seulement avec Qwen3.8-Flash-Next.
Le projet propose aussi de confier l’installation à un assistant de code (Claude Code, Cursor, Codex, GitHub Copilot) via un fichier d’instructions, et un serveur MCP permet à ces outils de lancer et d’arrêter PolyStrata. Pour mesurer ta propre machine, BENCH.bat ou ./bench.sh prend 5 à 10 minutes, et le benchmark du moteur se lance ainsi :
python polystrata.py benchmark --model <name> --prompt-tokens 24000Utiliser PolyStrata avec tes applications
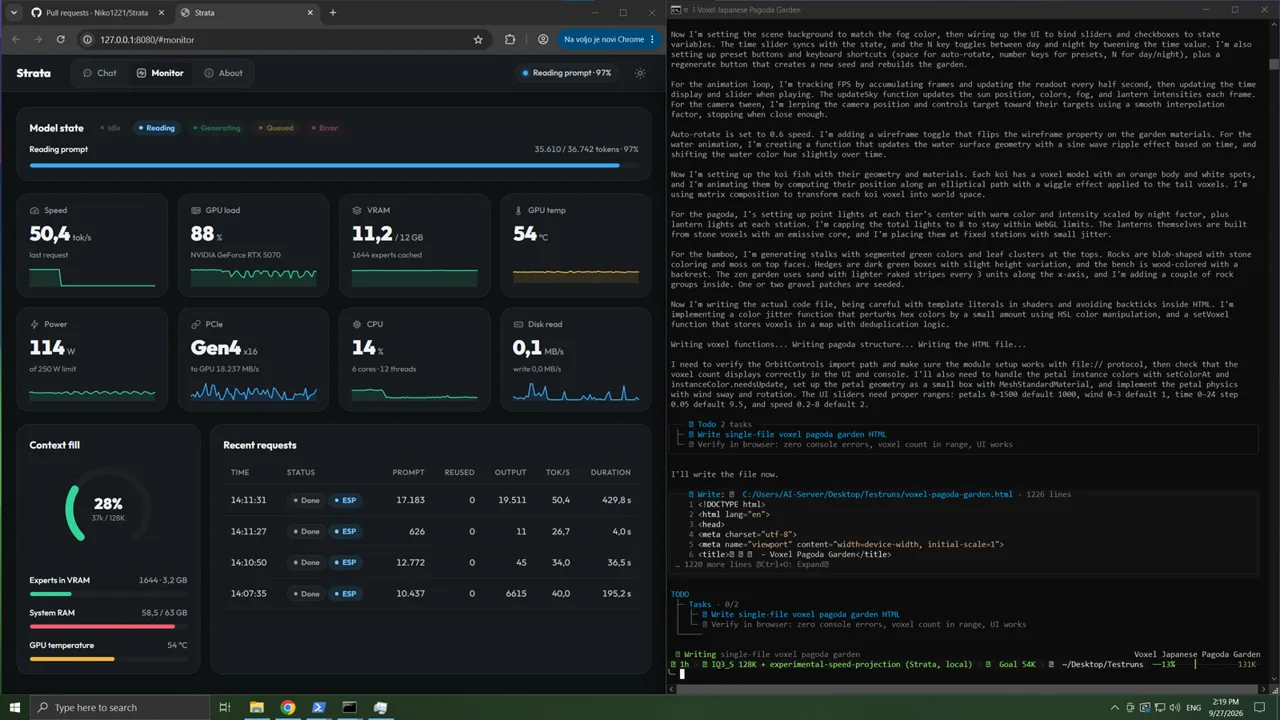
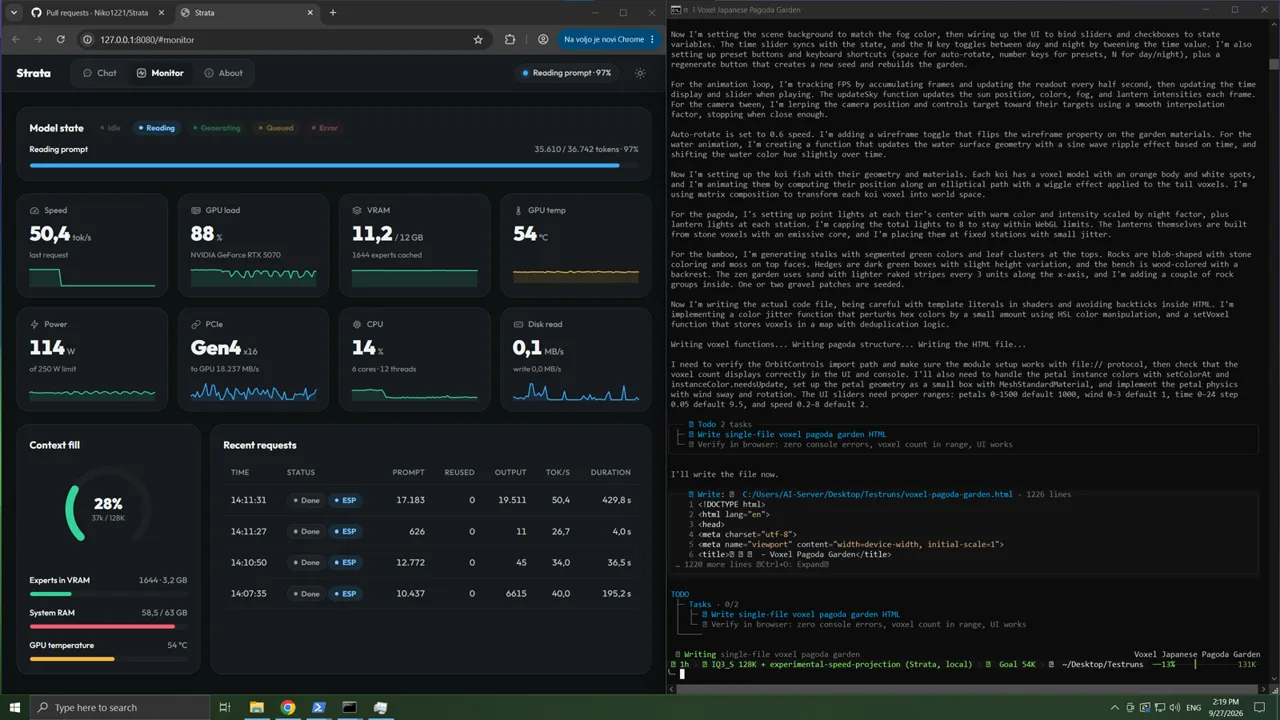
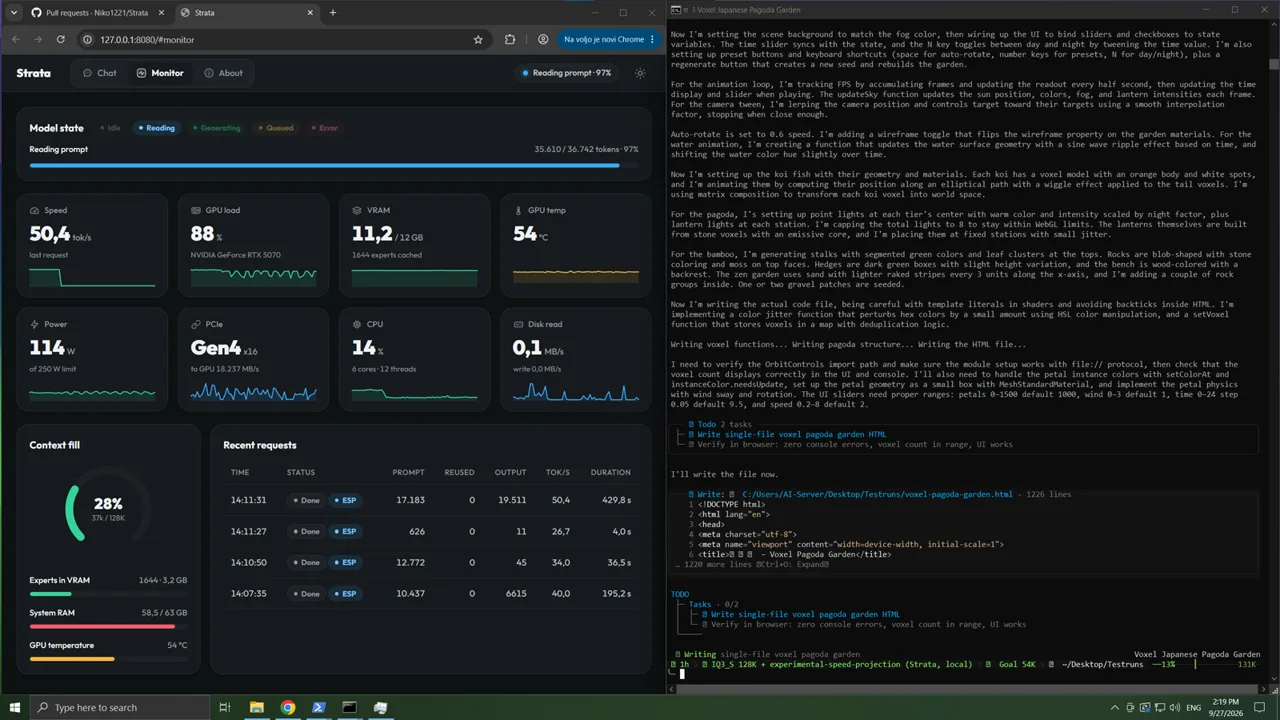
Dans le navigateur, l’application offre un chat, un moniteur en direct du modèle et de ton GPU, CPU et RAM, et une page de réglages. Tu peux choisir le niveau de réflexion du modèle : off, low, medium ou high. Off est le plus rapide, high convient aux questions difficiles.
Pour tes outils, il suffit d’ajouter un fournisseur « compatible OpenAI » avec l’adresse de base ci-dessous. N’importe quelle clé d’API et n’importe quel nom de modèle fonctionnent. Les applications qui utilisent l’API d’Anthropic passent par /v1/messages, et le README donne pour Claude Code la variable suivante, avec "fit_max_tokens": true dans le fichier strata-‹model›.json. La route /v1/responses couvre Codex CLI.
Pour y accéder depuis un téléphone ou un autre PC, le README demande de toujours définir une clé d’API.
http://127.0.0.1:8080/v1
ANTHROPIC_BASE_URL=http://127.0.0.1:8080
Où en est le projet
Le dépôt a été créé le 6 octobre 2026. Au 7 novembre 2026, il compte 899 étoiles, 126 copies, 303 contributeurs et 27 tickets et demandes de fusion ouverts. Sa dernière version publiée est la v0.1.45-poly.7, du 31 octobre 2026. Le code est écrit à 61 % en C++, 22 % en Python et 13 % en Cuda.
Cette version réduit la RAM utilisée par les onze modèles du second moteur. Sur le portable, Qwen3.6-35B-A3B après un prompt de 32 000 tokens occupait 17,9 Gio avec la version précédente et occupe 13,1 Gio maintenant, à vitesse d’écriture égale. Un réglage optionnel, désactivé par défaut, réduit encore cette mémoire : il suffit d’ajouter la ligne suivante à la liste "args" de strata-‹model›.json. Il fait descendre la RAM tenue à 6,5 Gio sur le test du README, au prix d’une écriture de 3 à 14 % plus lente selon les cas. La version précédente a ajouté le modèle Clover-35B-A3B-Preview.
"--ram-experts-mib", "6144"Ce qu’il faut savoir avant de se lancer
Le second moteur est présenté comme expérimental : il a tourné sur un PC avec une carte de 32 Go, et les huit modèles plus petits aussi sur un portable avec une carte de 8 Go. Il demande une carte NVIDIA RTX série 20 ou plus récente ; les cartes AMD sont prises en charge en bêta pour plusieurs modèles, tandis que GLM 5.3 Flash, DeepSeek V4 Flash, Flint et Kolibri 1 n’y ont pas été essayés. Les cartes GTX série 10 ne sont pas gérées par ce moteur.
Côté mémoire, le README donne une estimation de RAM par modèle, par exemple environ 21 Go de RAM pour Qwen3.6 à côté d’une carte de 8 Go, et 96 Go pour GLM 5.3 Flash. Le projet est sous licence MIT, mais chaque modèle a la sienne : celle de LFM2.5 n’autorise l’usage commercial qu’aux entreprises de moins de 10 millions de dollars de chiffre d’affaires annuel.
Quelques repères
- Token : Unité de texte qu’un modèle de langage lit ou écrit, souvent un morceau de mot. La vitesse d’un modèle se mesure en tokens par seconde.
- VRAM : Mémoire vive de la carte graphique. Plus elle est grande, plus la carte peut garder de données du modèle près de son processeur.
- API : Interface qui permet à deux programmes de se parler selon des règles communes. Une application l’utilise pour envoyer une question à un modèle et recevoir sa réponse.
Questions fréquentes
PolyStrata est-il gratuit et open source ?
Oui, PolyStrata est open source sous licence MIT. Chaque modèle garde cependant sa propre licence : celle de LFM2.5 n’autorise l’usage commercial qu’aux entreprises de moins de 10 millions de dollars de chiffre d’affaires annuel.
PolyStrata fonctionne-t-il sur Windows et sur Linux ?
Oui, l’installation guidée existe pour les deux. GLM 5.3 Flash et DeepSeek V4 Flash ne tournent que sous Linux, et Qwen3.8-Flash-Next fonctionne aussi sur Mac Apple Silicon.
Quelle carte graphique faut-il pour PolyStrata ?
Une carte NVIDIA RTX série 20 ou plus récente, de 8 Go ou plus, suffit pour la plupart des modèles. Qwen3.8-Flash-Next demande 12 Go ou plus, et GLM 5.3 Flash comme DeepSeek V4 Flash exigent une carte de 32 Go.
Peut-on utiliser PolyStrata avec Claude Code ou une API OpenAI en local ?
Oui, PolyStrata expose une API compatible OpenAI et une API compatible Anthropic sur localhost. Pour Claude Code, le README indique de définir ANTHROPIC_BASE_URL et d’ajouter l’option fit_max_tokens dans le fichier de réglages du modèle.
À retenir
PolyStrata fait tourner douze modèles d’IA sur un PC Windows ou Linux et les expose par une API OpenAI et Anthropic en local, sans envoyer de données ailleurs. Son second moteur reste expérimental, et la vitesse comme la mémoire dépendent beaucoup de la carte et de la RAM disponibles.
Sources
- simplexai-labsREADME
- docs/INSTALL.mddocumentation officielle
- docs/FAQ.mddocumentation officielle
- GitHubnotes de version