Sommaire11 parties
PolyStrata est un moteur open source qui fait tourner de gros modèles de langage sur un PC ordinaire, des modèles qui demandent d’habitude un serveur. Il propose neuf modèles sur deux moteurs, une installation guidée sous Windows et Linux, et une API locale compatible OpenAI et Anthropic. Rien ne quitte ta machine, mais huit des neuf modèles restent expérimentaux.
En bref
- Neuf modèles au choix, sur deux moteurs, sans cloud
- Qwen3.6-35B-A3B écrit 94 à 100 tokens par seconde sur un portable à carte de 8 Go
- API locale compatible OpenAI et Anthropic pour brancher applis et agents de code
- Huit modèles sur neuf sont expérimentaux
- Licence MIT, installation par START-HERE.bat ou ./setup.sh
Ce que fait PolyStrata
PolyStrata permet de faire tourner une IA en local, avec des modèles volumineux qui exigent normalement un serveur. Ils discutent, écrivent du code et fonctionnent avec tes applications et tes agents de code. Rien ne quitte ton PC.
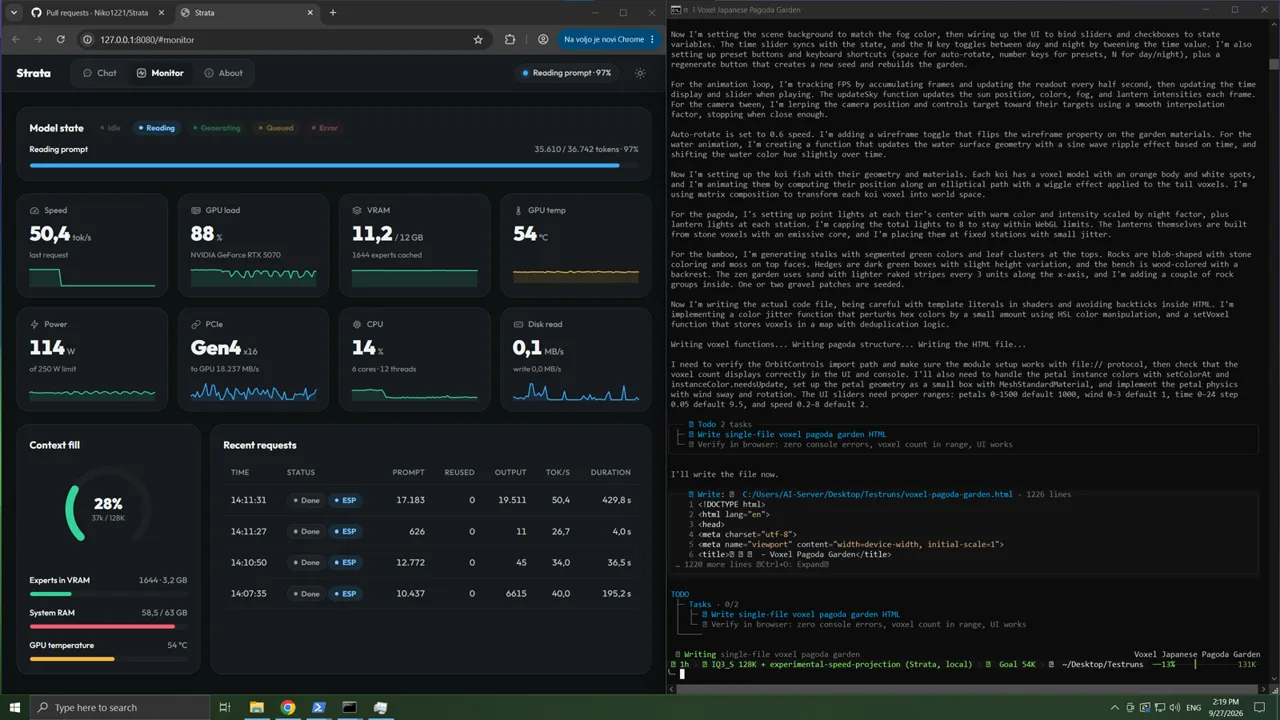
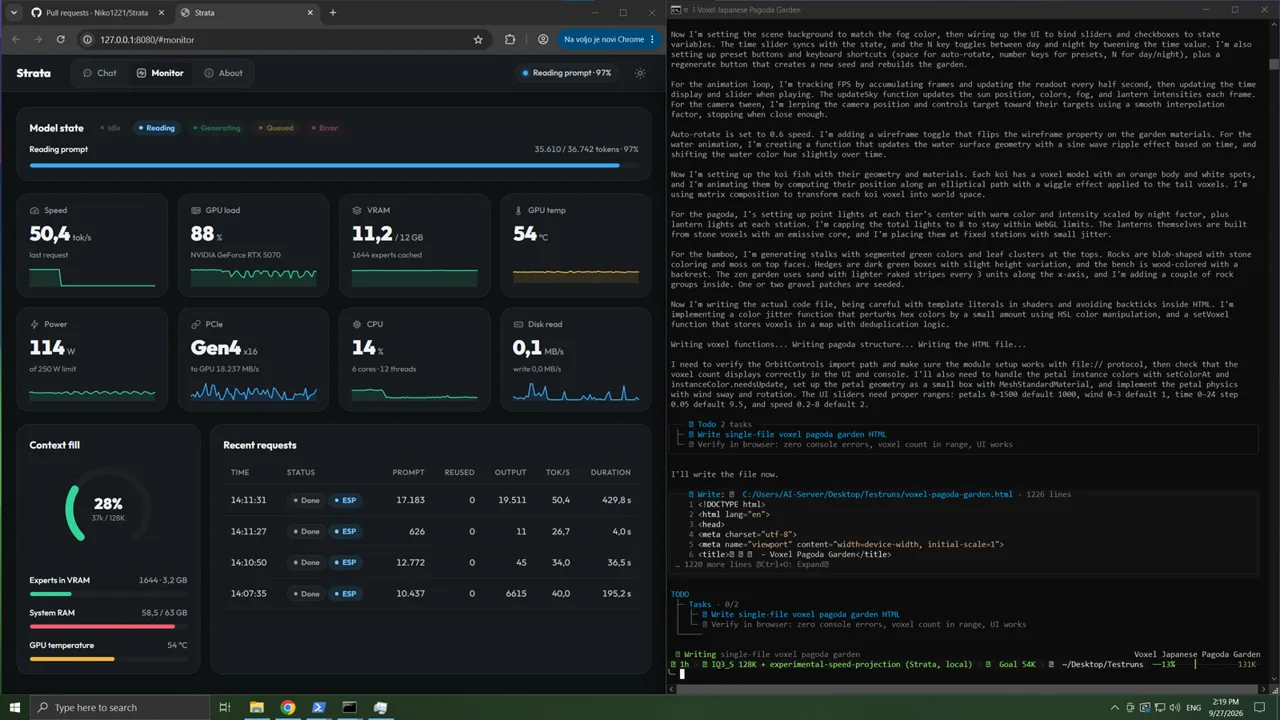
Le projet est construit sur Strata, un projet de Niko1221. Selon sa FAQ, Strata a refusé d’autres architectures de modèles (« Other MoE architectures (DeepSeek, GLM) aren’t planned »), d’où un second moteur écrit pour PolyStrata. Le dépôt garde l’historique de Strata et son moteur y figure inchangé.
Les neuf modèles et les deux moteurs
Le moteur de Strata fait tourner Qwen3.8-Flash-Next, sur une carte NVIDIA ou AMD de 12 Go ou plus, sous Windows ou Linux. Ce modèle lit aussi les images. Les huit autres passent par le moteur écrit pour PolyStrata, avec une ou deux cartes NVIDIA : sous Linux, et sous Windows pour les six plus petits. Ils sont expérimentaux : ils ont tourné sur un PC avec une carte de 32 Go, et les six plus petits aussi sur un portable avec une carte de 8 Go.
Le serveur peut passer d’un modèle installé à un autre pendant qu’il tourne.
- GLM 5.3 Flash, le plus gros : un fichier de 79 à 114 Go, surtout gardé en RAM
- DeepSeek V4 Flash : 91 Go, texte seul
- LFM2.5-24B-A2B de Liquid AI : 11 à 25 Go, texte seul
- Qwen3.6-35B-A3B, Ornith 1.5, Gemma 4 26B-A4B et Tiel Coder : lisent les images
- MiniCPM-V 4.7 35B-A3B d’OpenBMB, conçu pour lire les images : 16 à 29 Go
Quelle vitesse sur quel matériel
Un token vaut environ trois quarts de mot. Selon le README, 60 tokens par seconde en écriture dépassent la vitesse de lecture. Qwen3.6-35B-A3B écrit 94 à 100 tokens par seconde en UD-Q3_K_M sur un portable avec une RTX 4070 de 8 Go, et 394 à 395 sur une RTX 5090. Le portable lit un prompt de 30 000 tokens environ à 1 690 tokens par seconde.
Pour Qwen3.8-Flash-Next, le projet Strata annonce 94 tokens par seconde en Q2_0 sur une RTX 5070 de 12 Go, avec un prompt de 32 000 tokens. GLM 5.3 Flash est plus lent (50 à 66 tokens par seconde sur la RTX 5090), car une partie seulement de ses experts tient dans la carte.
Sur le portable, PolyStrata lit les prompts 2,7 à 3,5 fois plus vite que llama.cpp b11540 et écrit 1,5 à 1,8 fois plus vite, avec Qwen3.6 et Tiel Coder. Pour mesurer sur ton PC, le projet fournit un benchmark.
python polystrata.py benchmark --model <name> --prompt-tokens 24000Installer PolyStrata sous Windows ou Linux
Sous Windows, tu télécharges le projet, tu le décompresses et tu lances START-HERE.bat. Le programme pose quelques questions, Entrée valide le choix recommandé, puis il télécharge tout et démarre le modèle. Le navigateur ouvre l’application sur ` Pendant le chargement, le PC peut ralentir 1 à 3 minutes, car 35 à 55 Go passent en RAM.
Sous Linux, la commande est la suivante. Le pilote graphique est la seule chose à installer toi-même. Pour Qwen3.8-Flash-Next, la documentation demande 12 Go de VRAM ou plus, 32 Go de RAM ou plus et environ 80 Go de disque.
./setup.shUtiliser PolyStrata avec tes applis et Claude Code
PolyStrata expose une API compatible OpenAI et Anthropic sur ta machine. Le README montre Claude Code branché sur Qwen3.6-35B-A3B UD-Q3_K_M, sur le portable à carte de 8 Go : l’outil ajoute une option --json à un petit programme, écrit un test et le lance.
Depuis la version 0.1.44.1-poly.6, les huit modèles ajoutés peuvent répondre à plusieurs requêtes à la fois, jusqu’à 8, avec "parallel": N. Sur la RTX 5090 avec Qwen3.6, quatre conversations simultanées totalisent 428 à 430 tokens par seconde.
Où en est PolyStrata
Au 17 octobre 2026, le dépôt compte 173 étoiles, 33 copies et 15 tickets ou demandes de fusion ouverts. Il a été créé le 6 octobre 2026, et la dernière version, v0.1.44.1-poly.6, date du 16 octobre.
Les versions récentes ajoutent MiniCPM-V, une option --kv q8_0 qui réduit environ de moitié la mémoire du cache d’attention, et "preserve_thinking": true pour garder le raisonnement des tours précédents.
Ce qu’il faut savoir avant de se lancer
Les modèles du second moteur n’ont tourné que sur des cartes de 8 Go et plus, et nécessitent une carte NVIDIA RTX 20 ou plus récente. Sur AMD, sous Linux, ils sont en bêta. GLM 5.3 Flash demande 96 Go de RAM ou plus à côté d’une carte de 32 Go.
Le code est sous licence MIT. LFM2.5 a sa propre licence : l’usage commercial est réservé aux entreprises de moins de 10 millions de dollars de revenu annuel.
Quelques repères
- VRAM : C’est la mémoire de la carte graphique. Un modèle d’IA doit y tenir, au moins en partie, pour tourner vite.
- Token : Un token est un morceau de mot que le modèle lit ou écrit. Sa vitesse se mesure en tokens par seconde.
- API : Une API est une interface qui permet à un programme d’en commander un autre. Ici, tes applications peuvent ainsi envoyer des questions au modèle local.
Questions fréquentes
PolyStrata fonctionne-t-il sans connexion à un service cloud ?
Oui, selon le README, PolyStrata fait tourner les modèles sur ton PC et rien ne le quitte. Le téléchargement initial des modèles reste nécessaire.
Quelle carte graphique faut-il pour PolyStrata ?
Pour Qwen3.8-Flash-Next, une carte NVIDIA RTX 20 à 50 ou une AMD compatible, avec 12 Go de VRAM ou plus. Pour les huit autres modèles, une NVIDIA RTX 20 ou plus récente suffit, avec 8 Go minimum pour Qwen3.6.
PolyStrata peut-il faire tourner Claude Code en local ?
Oui, le README montre Claude Code sur Qwen3.6-35B-A3B UD-Q3_K_M, via l’API compatible Anthropic de PolyStrata, sur un portable à carte de 8 Go.
Quels modèles de PolyStrata lisent les images ?
Qwen3.8-Flash-Next, Qwen3.6-35B-A3B, Ornith 1.5, Gemma 4 26B-A4B, Tiel Coder et MiniCPM-V lisent les images. GLM 5.3 Flash, DeepSeek V4 Flash et LFM2.5 lisent le texte seul.
À retenir
PolyStrata permet de faire tourner en local neuf modèles d’IA, avec une API compatible OpenAI et Anthropic, sous licence MIT. Huit de ces modèles sont expérimentaux et dépendent surtout d’une carte NVIDIA et d’assez de RAM.
Sources
- VecSznREADME
- docs/INSTALL.mddocumentation officielle
- docs/FAQ.mddocumentation officielle
- GitHubnotes de version