Sommaire11 parties
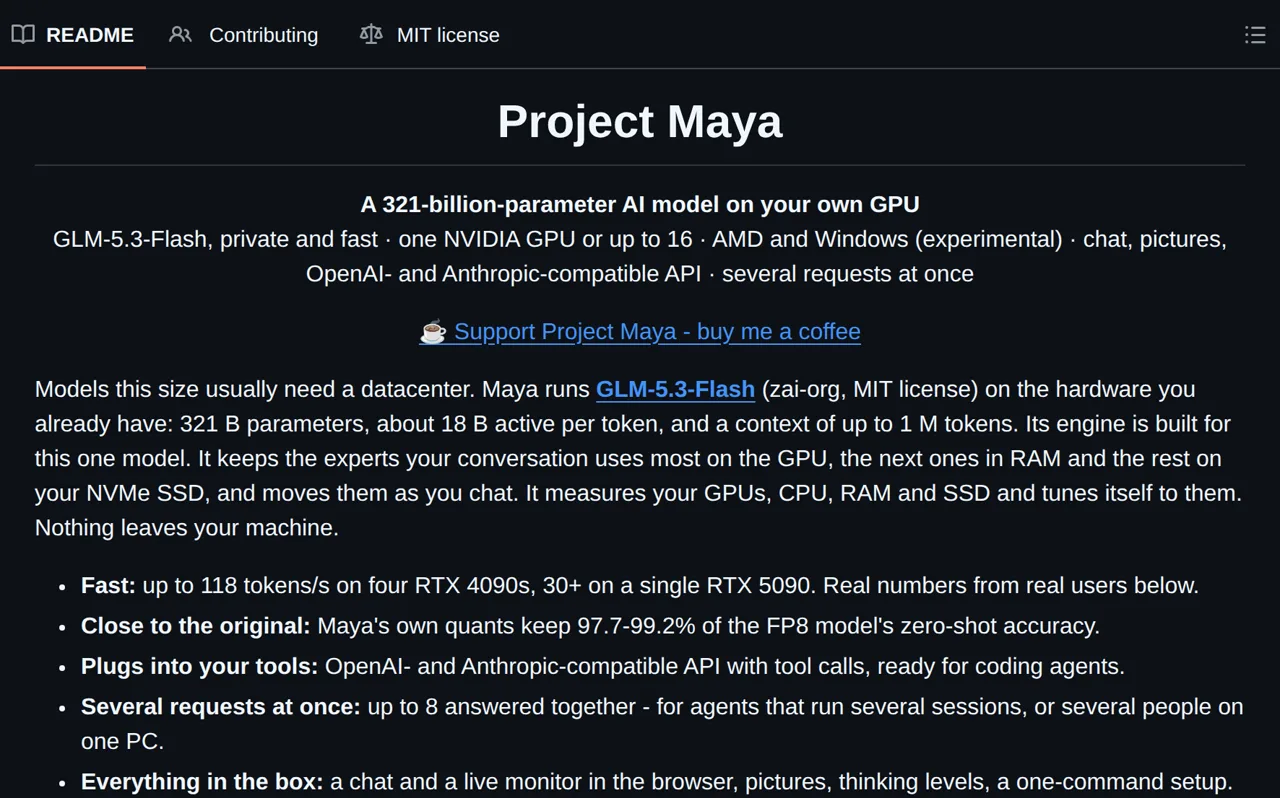
Project Maya est un moteur open source qui fait tourner GLM-5.3-Flash, un modèle de langage de 321 milliards de paramètres, sur tes propres cartes graphiques, sans que rien ne quitte ta machine. Il répartit le modèle entre la mémoire des GPU, la RAM et un SSD NVMe, puis s’ajuste à ton matériel. Il offre un chat dans le navigateur et une API compatible OpenAI et Anthropic pour les agents de code.
En bref
- Fait tourner GLM-5.3-Flash (321 milliards de paramètres) en local, sur un à seize GPU NVIDIA
- Jusqu’à 118 tokens/s sur quatre RTX 4090, plus de 30 sur une RTX 5090
- API compatible OpenAI et Anthropic, avec appels d’outils
- Installation en une commande : ./setup.sh, avec un SSD NVMe et 32 Go de RAM au minimum
- Licence MIT ; AMD et Windows sont expérimentaux
Project Maya, un modèle géant sur ton propre PC
Un modèle de cette taille demande d’ordinaire un centre de données. Project Maya vise l’inverse : faire tourner GLM-5.3-Flash, publié par zai-org sous licence MIT, sur le matériel que tu possèdes déjà. Le modèle compte 321 milliards de paramètres, dont environ 18 milliards sont actifs pour chaque token, et son contexte peut aller jusqu’à 1 million de tokens.
Le moteur est écrit pour ce seul modèle. Tout reste sur ta machine : c’est l’intérêt pour qui veut un chat d’IA sans cloud ou un assistant de code privé.
Comment fonctionne Project Maya
GLM-5.3-Flash est un modèle de type « mixture of experts » : il contient de nombreux sous-réseaux appelés experts, et seule une petite partie travaille à chaque token. Project Maya en tire parti. Il garde sur le GPU les experts que ta conversation utilise le plus, place les suivants en RAM et laisse le reste sur le SSD NVMe, puis il les déplace au fil de la discussion.
Le moteur mesure tes GPU, ton processeur, ta RAM et ton SSD, puis se règle en conséquence. La commande ./maya.sh --calibrate affine ce réglage en 10 à 15 minutes. Plus le GPU et la RAM peuvent contenir d’experts, plus le modèle répond vite.
Les quatre versions du modèle : Maya-S, S24, M et L
Project Maya fournit ses propres versions quantifiées de GLM-5.3-Flash, produites à partir de la publication FP8 de Z.ai. Chacune garde le bloc MTP du modèle, qui propose des tokens à l’avance pour accélérer l’écriture. L’installation recommande une version selon ton PC.
Face au modèle FP8, ces versions conservent entre 97,7 % et 99,2 % de la précision en zéro-shot, mesurée sur quatre tests (ARC, HellaSwag, WinoGrande, PIQA). Sur des questions à choix multiples de 400 questions, le projet précise lui-même que la différence entre elles reste dans la marge de bruit du test.
- Maya-S (96,5 Go, version par défaut) : pour une mémoire totale (RAM et VRAM) plus réduite, 97,9 %
- Maya-S24 (94,7 Go) : pour les cartes de 24 Go ou moins, décodage environ 14 % plus rapide, 97,7 %
- Maya-M (116 Go) : pour une mémoire plus large, calibrée vers les appels d’outils et le code front-end, 97,9 %
- Maya-L (156,3 Go) : pour les plus grosses mémoires, 99,2 %
- Maya-M-Derisked (116 Go) : variante expérimentale de Maya-M qui réduit les refus systématiques, non mesurée pour l’instant
Quelle vitesse sur quel matériel ?
Le README rassemble des mesures faites par des utilisateurs, la plupart avec ./maya.sh --bench. Le décodage est la vitesse d’écriture de la réponse. Sur quatre RTX 4090 de 24 Go avec Maya-S24, il atteint 118 tokens/s. Une RTX 5090 de 32 Go avec Maya-M dépasse 30 tokens/s, et une RTX 3090 seule fait 26 à 27 tokens/s selon la machine et la version.
Les machines plus modestes restent utilisables : 14,5 tokens/s sur un portable avec une RTX 5090 Laptop, et 18,3 tokens/s sur une Radeon 8060S sous Windows. Le projet note que les premières réponses après un démarrage sont les plus lentes, le temps que les caches se remplissent.
Le mode --parallel traite jusqu’à 8 requêtes à la fois. Sur une Strix Halo qui garde tous les experts en mémoire GPU, le débit total est multiplié par 2,02 avec quatre requêtes, comparé aux mêmes questions posées l’une après l’autre.
Installer Project Maya
L’installation tient en deux commandes sous Linux. Le script pose quelques questions (Entrée choisit l’option recommandée), montre chaque téléchargement avant de le lancer, compile le moteur une fois (20 à 40 minutes, plus le téléchargement) et démarre le modèle. Il n’installe rien à l’échelle du système.
Ensuite, ouvre dans ton navigateur. Sous Windows (expérimental), on lanceSTART-MAYA.batà la place de./setup.sh. Pour une mise à jour, le tableau de bord propose About › Update, ou git pullsuivi de./setup.sh` : le modèle n’est pas retéléchargé.
git clone https://github.com/mw00/project-maya.git && cd project-maya
./setup.sh
Utiliser le chat et l’API compatible OpenAI
Le navigateur donne accès à un chat (conservé dans ton navigateur, avec instructions par conversation, édition et régénération), à un moniteur en direct du modèle et du matériel, et à l’envoi d’images. Le niveau de réflexion se règle sur Off, Low, High (par défaut) ou Max.
Pour tes applications et agents de code, Project Maya expose une API compatible OpenAI à l’adresse et une API compatible Anthropic sur/v1/messages, avec appels d'outils. Pour Claude Code, la variable ANTHROPIC_BASE_URL= suffit selon le README. Pour y accéder depuis un autre appareil, le projet demande de toujours définir une clé d’API.
Prérequis, limites et état du projet
Il faut un GPU NVIDIA de capacité de calcul 7.0 ou plus (V100, RTX 20 et suivantes), de un à seize cartes. L’AMD est expérimental (RX 7900 XT/XTX, Radeon AI PRO R9700, RX 9070, Strix Halo) et limité au texte. Le projet demande 32 Go de RAM, un SSD NVMe (pas un disque dur) avec environ 100 Go libres pour Maya-S ou 160 Go pour Maya-L, ainsi que Linux, CUDA 12.x et Python 3.10 ou plus. Le moteur réserve presque toute la RAM libre, ce qui en laisse peu aux autres programmes, et le démarrage prend quelques minutes. Windows n’est pas pris en charge via WSL2.
Le projet est récent : le dépôt date du 6 octobre 2026 et la version v1.1.8 est sortie le 14 octobre 2026. Au relevé du 14 octobre 2026, il compte 769 étoiles, 23 contributeurs et 39 tickets ou demandes de fusion ouverts. Les dernières versions apportent notamment le streaming du cache d’attention en RAM pour les longs contextes et l’affichage de la progression de lecture d’un prompt. Le code est sous licence MIT ; le drafteur optionnel DFlash2, qui accélère certaines configurations, est en CC BY-NC-ND 4.0, donc non commercial.
Quelques repères
- Quantification : Technique qui réduit la précision des nombres stockés dans un modèle d’IA pour diminuer sa taille et sa consommation de mémoire. Le modèle perd un peu en fidélité, mais devient plus facile à faire tourner sur du matériel courant.
- VRAM : Mémoire intégrée à une carte graphique. Elle est plus rapide d’accès pour le GPU que la RAM de l’ordinateur, mais en général plus limitée.
- API compatible OpenAI : Interface qui reprend le format d’échange d’OpenAI. Les applications écrites pour ce format peuvent s’y connecter en changeant simplement l’adresse du serveur.
Questions fréquentes
Project Maya est-il gratuit et open source ?
Oui, Project Maya est sous licence MIT et gratuit. Le modèle GLM-5.3-Flash de zai-org est aussi sous licence MIT, et les versions quantifiées de Maya gardent cette licence. Seul le drafteur optionnel DFlash2 est non commercial (CC BY-NC-ND 4.0).
Quelle configuration faut-il pour faire tourner Project Maya ?
Il faut un GPU NVIDIA de capacité 7.0 ou plus, 32 Go de RAM et un SSD NVMe rapide avec environ 100 Go libres pour Maya-S. Le système attendu est Linux avec CUDA 12.x ; Windows et AMD sont expérimentaux.
Project Maya fonctionne-t-il avec Claude Code ou une API compatible OpenAI ?
Oui, Project Maya expose une API compatible OpenAI et une API compatible Anthropic, avec appels d’outils. Pour Claude Code, le README indique de définir ANTHROPIC_BASE_URL=
Quelle vitesse atteint Project Maya sur une seule carte ?
Sur une RTX 5090 de 32 Go avec Maya-M, Project Maya dépasse 30 tokens/s en décodage, d’après une mesure d’utilisateur. Une RTX 3090 de 24 Go seule donne 26 à 27 tokens/s selon la machine.
À retenir
Project Maya permet d’exécuter en local GLM-5.3-Flash, un modèle de 321 milliards de paramètres, en répartissant ses experts entre GPU, RAM et SSD NVMe, avec une API compatible OpenAI et Anthropic. Il demande un SSD rapide, au moins 32 Go de RAM et une carte NVIDIA, l’AMD et Windows restant expérimentaux.
Sources
- mw00README
- huggingface.codocumentation officielle
- GitHubnotes de version