Sommaire11 parties
colibri est un moteur d’inférence écrit en C, sous licence Apache-2.0, qui fait tourner de très gros modèles de langage ouverts sur une machine ordinaire. Il s’appuie sur le fait qu’un modèle de type « mixture of experts » n’utilise qu’une petite partie de lui-même à chaque token : cette partie reste en mémoire, le reste est lu sur le disque à la demande. Une carte graphique est possible, pas obligatoire.
En bref
- colibri fait tourner de gros modèles MoE en gardant l’essentiel en RAM et le reste sur le disque.
- Il faut 8 Go de RAM au minimum et 22 Go libres sur le disque pour le plus petit modèle.
- Le GPU est optionnel : CPU seul, Vulkan (tout GPU) ou CUDA (NVIDIA).
- Un serveur local compatible OpenAI et Anthropic est inclus.
- Dernière version : v2.1.0, publiée le 31 octobre 2026.
Qu’est-ce que colibri et quel problème règle-t-il ?
Les très gros modèles ouverts demandent en général des machines hors de portée du grand public. colibri part d’une observation : dans un modèle MoE, la plus grande partie des paramètres ne sert pas à chaque token. Le README prend l’exemple de GLM-5.2, qui compte 744 milliards de paramètres, en utilise environ 40 milliards par token, et dont seulement environ 11 Go changent d’un token à l’autre : les experts routés.
Le modèle n’a donc pas besoin de tenir tout entier dans une mémoire rapide, il doit être placé. La documentation décrit colibri comme un moteur d’inférence et une plateforme de recherche, pas comme un service hébergé : la vitesse dépend beaucoup du format du modèle, du placement en mémoire, du stockage et de la taille du prompt.
Comment fonctionne colibri
La partie dense du modèle (attention, experts partagés, embeddings) reste en RAM. Les experts routés restent sur le disque et sont lus quand le routeur les demande, à travers un cache qui apprend quels experts ton usage sollicite. S’il y a un GPU, il garde les experts les plus sollicités et les couches denses.
Le README insiste sur un point : l’endroit où se trouve un poids change la vitesse de la réponse, pas les poids ni les décisions du routeur qui la produisent. La politique par défaut ne modifie pas en silence la précision du modèle. Moins de mémoire rapide peut coûter de la vitesse, pas redéfinir le modèle.
Le moteur est écrit en C, avec un fichier par famille de modèles. Les trois points d’entrée sont coli chat, coli serve et coli web, communs à tous les moteurs.
Quels modèles colibri sait-il faire tourner ?
Treize moteurs sont disponibles dans la version décrite : dix pour des modèles de langage (GLM, DeepSeek, Kimi, MiMo, Qwen, Inkling, OLMoE…), un pour générer des images (Qwen-Image-2.1) et deux pour des modèles qui répondent à des décisions. Depuis la v2.1.0, coli import permet aussi de lancer des fichiers GGUF tels qu’ils sont publiés, sans nouvelle conversion.
Les vitesses citées par le README dépendent de la machine. Qwen3.6-35B-A3B atteint 6,0 tokens par seconde sur CPU et 9,9 avec Vulkan sur le GPU intégré d’un Ryzen 7 PRO 8700GE. GLM-5.2 (744 milliards de paramètres) tourne à 1,83 token par seconde sur une machine de 128 Go de RAM, et à 0,05-0,1 token par seconde à froid sur un portable de 25 Go. Pour Kimi K3 (2,8 billions de paramètres), le README note environ 9,4 secondes par token.
- Petits modèles qui tiennent en RAM : Qwen3.6-35B-A3B (23 Go à télécharger), Qwen3-Coder-30B-A3B (19 Go).
- Modèles dont les experts passent par le disque : DeepSeek V4 Flash (167 Go), GLM-5.2 (429 Go), Kimi K3 (1,56 To).
- Génération d’images : Qwen-Image-2.1, sous licence non commerciale.
- Fichiers GGUF : Mistral-Large-4, Muse Spark Open, Flint, LFM3-VL-2B.
Installer colibri en une étape
Il faut au minimum 8 Go de RAM (16 Go ou plus, c’est mieux), 22 Go libres sur le disque pour le plus petit modèle et une connexion internet. Sous Windows, tu télécharges le dépôt en ZIP et tu lances START-HERE.bat. Sous Linux (Ubuntu, Debian), voici les commandes du README :
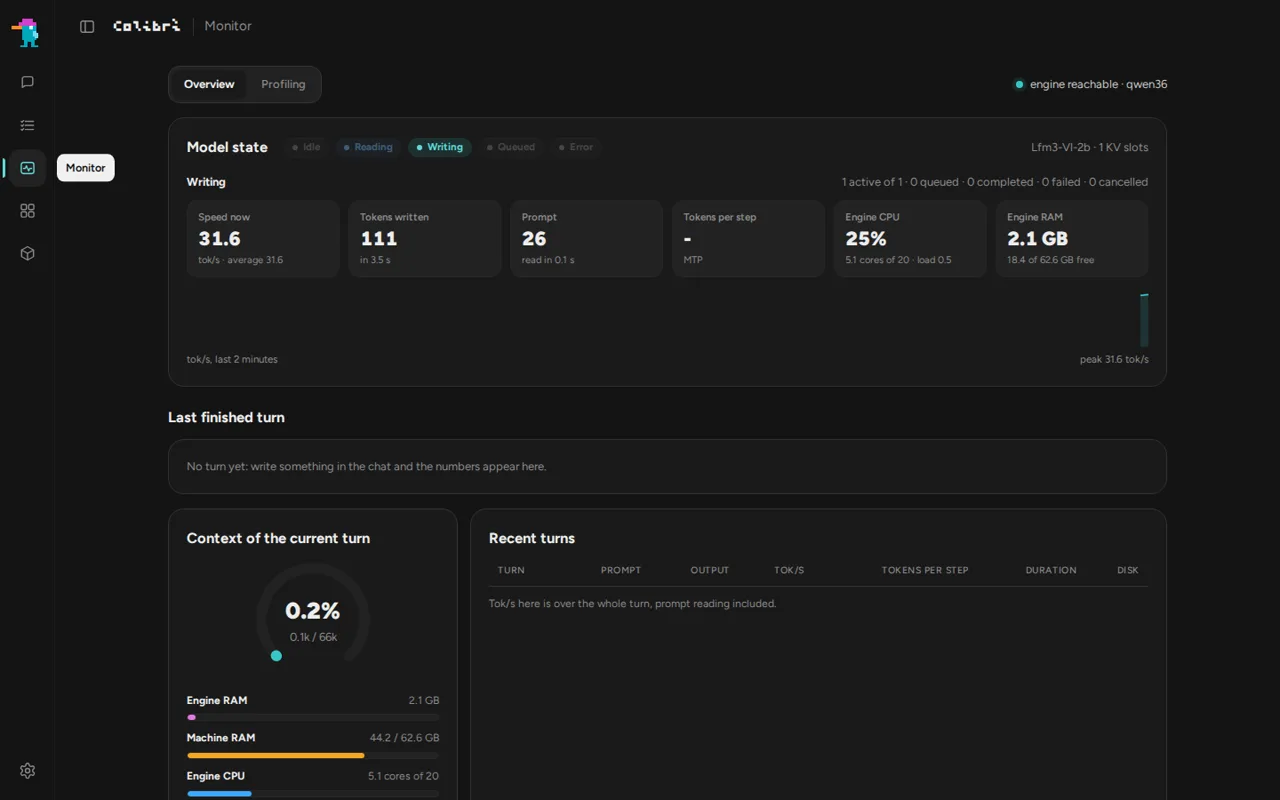
Le script regarde ta machine (RAM, disque, CPU, GPU), recommande un modèle qui convient, prépare le moteur, télécharge le modèle avec reprise possible en cas d’interruption, puis lance colibri et ouvre le tableau de bord dans le navigateur. La fois suivante, il suffit de relancer le même script : pas de nouveau téléchargement ni de nouvelle compilation. c/coli status montre ce qui est installé et c/coli stop arrête le programme.
Sur macOS, le README demande d’installer d’abord les outils de développement avec Homebrew. La documentation précise qu’il n’existe pas d’archive précompilée pour Linux ARM64 : sur cette plateforme, il faut compiler depuis les sources.
sudo apt install git python3 build-essential
git clone https://github.com/JustVugg/colibri
cd colibri
./start-here.sh
Utiliser colibri avec ou sans carte graphique, en serveur local
Chaque moteur tourne sur le CPU seul. Avec une carte graphique, colibri peut utiliser Vulkan (AMD, Intel, NVIDIA, intégrée ou dédiée) ou CUDA (cartes NVIDIA). Le GPU sert de cache pour les experts les plus sollicités. Le README précise qu’un GPU intégré partage la RAM du CPU : il aide sur Qwen3.6, mais un petit modèle comme OLMoE, dont les experts tiennent déjà en RAM, peut y perdre. Des options comme --backend vulkan, --backend cuda ou --no-gpu permettent de choisir.
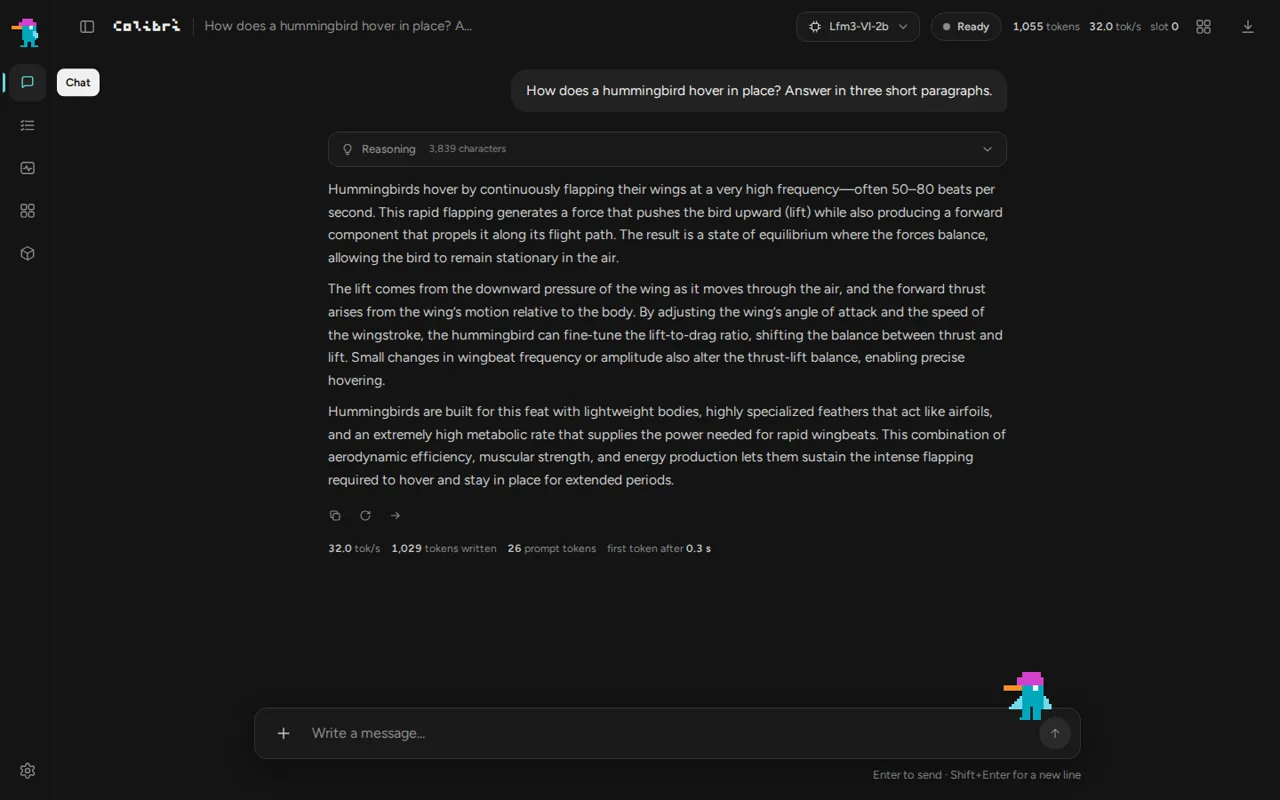
coli serve expose des adresses compatibles OpenAI et Anthropic, et coli web ajoute le tableau de bord local. De quoi brancher des applications existantes sur un modèle qui tourne chez toi. La documentation avertit : définis COLI_API_KEY avant d’ouvrir le serveur au-delà d’une machine locale de confiance.
Où en est le projet colibri
Le dépôt a été créé le 1er juillet 2026. Au 4 novembre 2026, il compte 47 495 étoiles, 5 486 copies, 221 contributeurs et 170 tickets et demandes de fusion ouverts. La dernière version, v2.1.0, date du 31 octobre 2026.
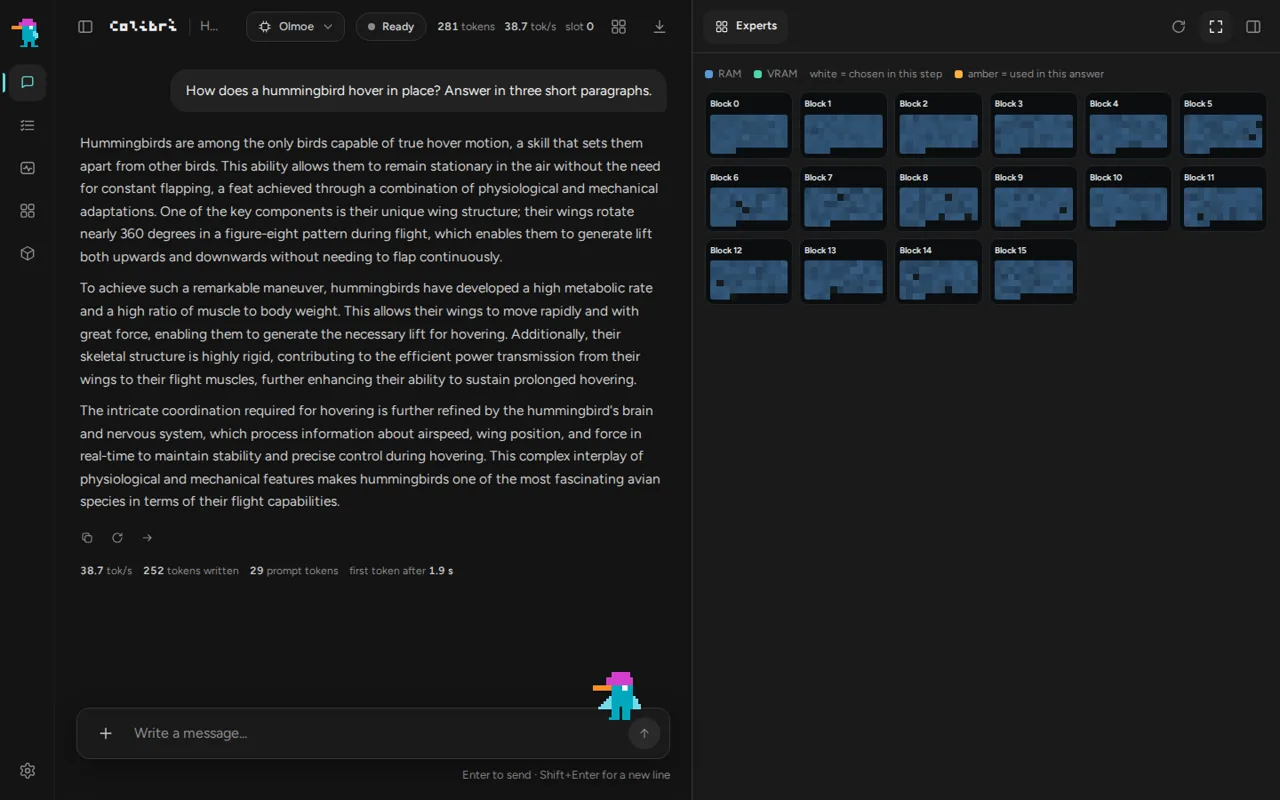
Selon ses notes, cette version regroupe 387 pull requests depuis la v2.0.0. Elle apporte le support natif des fichiers GGUF sur tous les moteurs, quatre nouveaux modèles (dont Mistral-Large-4), des chaînes CUDA propres à chaque moteur et une nouvelle interface de discussion, coli ui, avec une carte en direct des experts sollicités.
Ce qu’il faut savoir avant d’utiliser colibri
La licence du code est Apache-2.0, et le README présente colibri comme gratuit et open source. Les modèles gardent leurs propres licences : Qwen-Image-2.1 est non commercial, Muse Spark Open relève d’un accord de licence de Meta, LFM3-VL d’une licence LFM Open License.
Pour les gros modèles, c’est le disque qui fixe la vitesse : le README conseille un SSD NVMe rapide. Les débits mesurés vont de moins d’un token par seconde pour les plus gros à plusieurs dizaines pour les petits modèles GGUF. Le README indique aussi que certaines vitesses n’ont pas encore été mesurées, par exemple pour GLM-5.3.
Quelques repères
- Mixture of experts (MoE) : Architecture de modèle de langage composée de nombreux sous-réseaux appelés experts. Pour chaque token, seule une petite partie d’entre eux est activée.
- Token : Unité de texte traitée par un modèle de langage, souvent un mot ou un morceau de mot. La vitesse d’un modèle se mesure en tokens par seconde.
- API compatible OpenAI : Interface web qui reprend le format de requêtes d’un service connu, afin que les applications écrites pour lui fonctionnent avec un autre serveur en changeant seulement l’adresse.
Questions fréquentes
colibri a-t-il besoin d’une carte graphique ?
Non. Chaque moteur de colibri tourne sur le CPU seul. Un GPU (Vulkan ou CUDA) est une place plus rapide pour garder des poids, pas une obligation.
Combien de RAM et de disque faut-il pour colibri ?
Il faut au minimum 8 Go de RAM, 16 Go ou plus étant préférable, et 22 Go libres sur le disque pour le plus petit modèle. Les gros modèles demandent bien plus de disque, par exemple 429 Go pour GLM-5.2.
colibri est-il gratuit et open source ?
Oui. Le code est sous licence Apache-2.0 et le README le présente comme libre et gratuit. Chaque modèle garde cependant sa propre licence.
colibri propose-t-il un serveur compatible OpenAI ?
Oui. La commande coli serve expose des adresses compatibles OpenAI et Anthropic. Il faut définir COLI_API_KEY avant de l’ouvrir au-delà d’une machine locale de confiance.
À retenir
colibri fait tourner de très gros modèles MoE sur du matériel courant en plaçant les experts entre GPU, RAM et disque, sans changer le modèle. Le projet est actif (v2.1.0 le 31 octobre 2026), mais la vitesse reste fixée par le disque et la mémoire de la machine.
Sources
- JustVuggREADME
- docs/index.mdxdocumentation officielle
- docs/quickstart.mddocumentation officielle
- GitHubnotes de version