Sommaire11 parties
llama-swap est un routeur open source, écrit en Go, qui permet de faire tourner plusieurs modèles d’IA sur ta machine et de passer de l’un à l’autre à la demande. Il se présente sous la forme d’un seul binaire et d’un fichier de configuration, sans dépendance externe. Il fonctionne avec llama.cpp, vllm et tout serveur compatible avec les API d’OpenAI ou d’Anthropic.
En bref
- llama-swap charge le bon modèle local selon le champ
modelde chaque requête - Un binaire, un fichier de configuration YAML, aucune dépendance externe
- Compatible avec les API OpenAI et Anthropic, et avec llama.cpp, vllm, stable-diffusion.cpp, ComfyUI
- Déchargement automatique après un délai (
ttl) et interface web de test et de suivi - Licence MIT, installation par Docker, Homebrew, WinGet ou binaire
Ce que fait llama-swap
Quand on fait tourner des modèles d’IA en local, chacun est servi par un programme qu’il faut lancer, puis arrêter avant d’en démarrer un autre. llama-swap automatise ce va-et-vient : il se place devant tes serveurs d’inférence et démarre celui dont tu as besoin au moment où une requête arrive.
Le projet est écrit en Go par mostlygeek et publié sous licence MIT. Son README affirme qu’il est utilisé par des milliers de personnes pour leurs usages d’IA locale. Il accepte tout serveur compatible avec les API d’OpenAI et d’Anthropic, llama.cpp étant le mieux pris en charge.
Comment fonctionne llama-swap
Quand une requête arrive sur un point d’accès compatible OpenAI, llama-swap lit la valeur du champ model et charge la configuration du serveur correspondant. Si un autre serveur tourne à ce moment-là, il est remplacé par le bon : c’est le « swap » qui donne son nom au projet.
Dans la configuration de base, un seul modèle est chargé à la fois. Pour en garder plusieurs en mémoire en même temps, une option matrix décrit des règles de remplacement personnalisées. La version v264 y a ajouté un ensemble auto:orphans, qui regroupe automatiquement tous les modèles non cités ailleurs, utile par exemple pour garder certains modèles toujours chargés.
Les fonctions de llama-swap
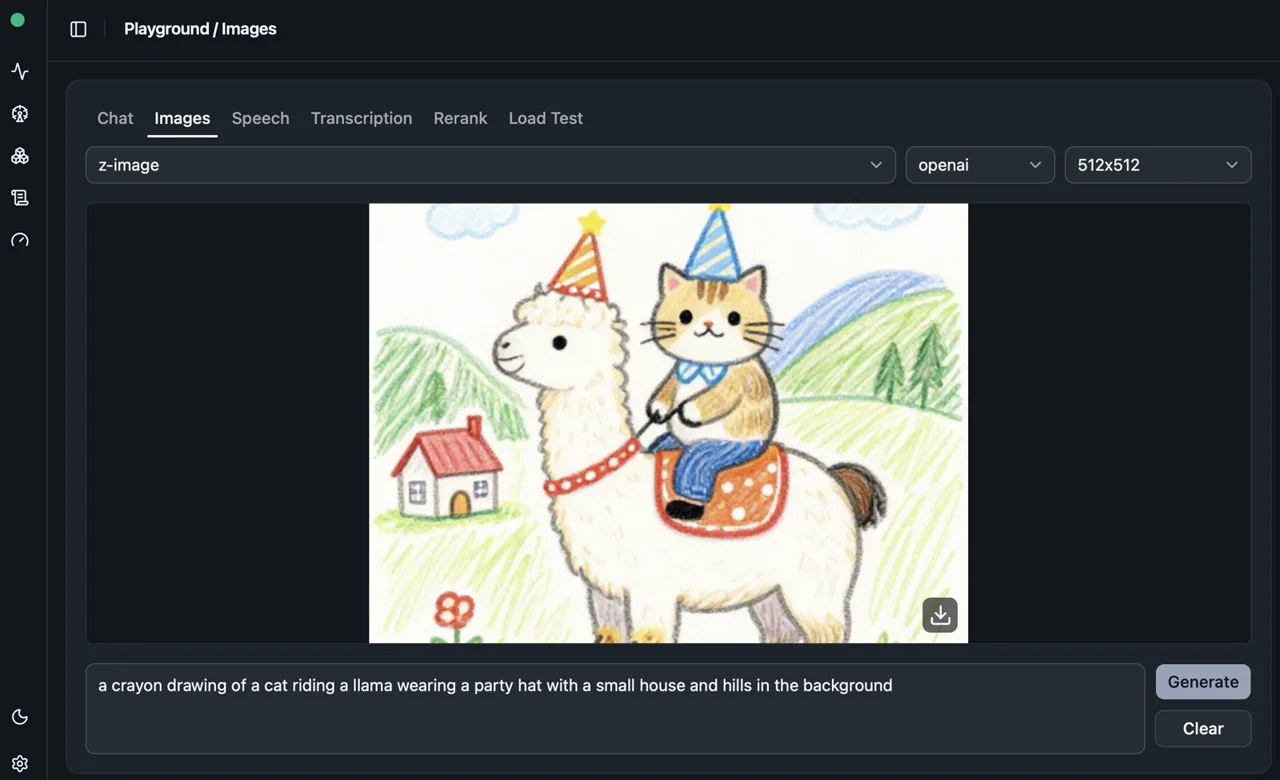
Côté API, llama-swap relaie notamment les routes de complétion, de chat, de réponses, d’embeddings, de reranking, de synthèse et de transcription audio, ainsi que la génération et la modification d’images. Pour Anthropic, il gère v1/messages et v1/messages/count_tokens. Il fonctionne aussi avec stable-diffusion.cpp, audio.cpp et ComfyUI.
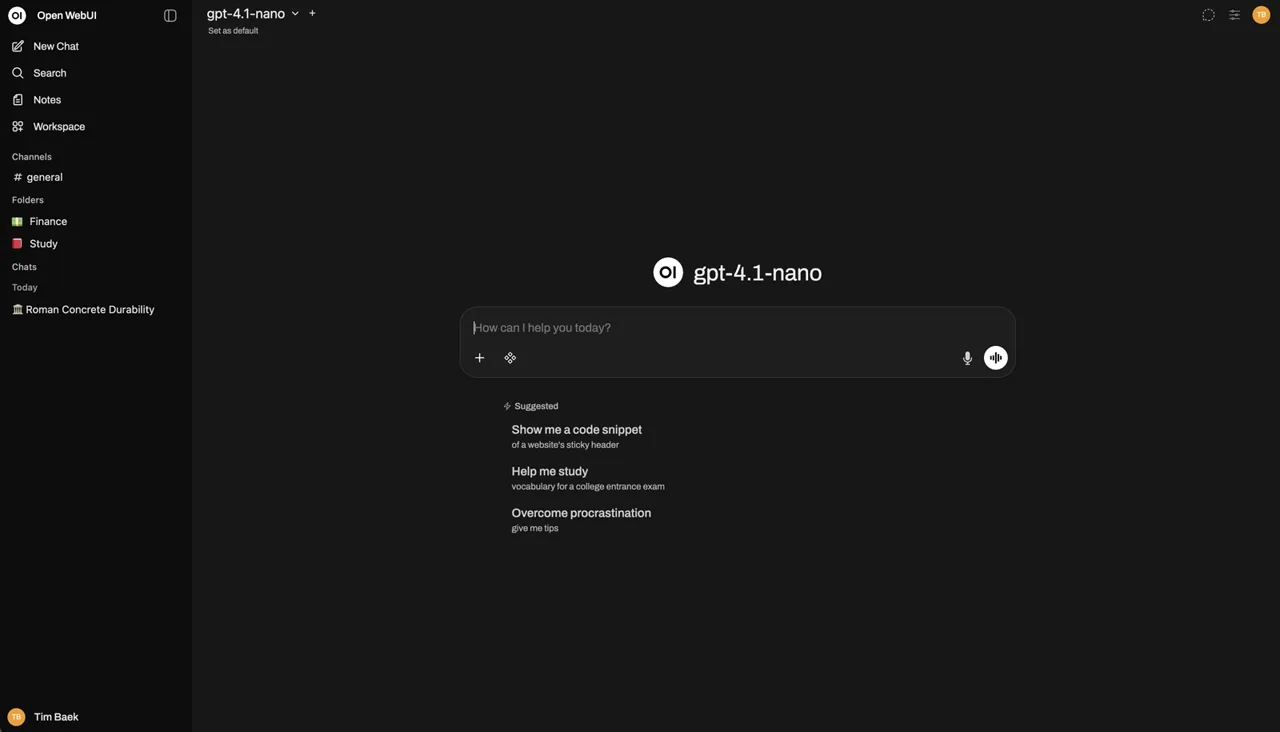
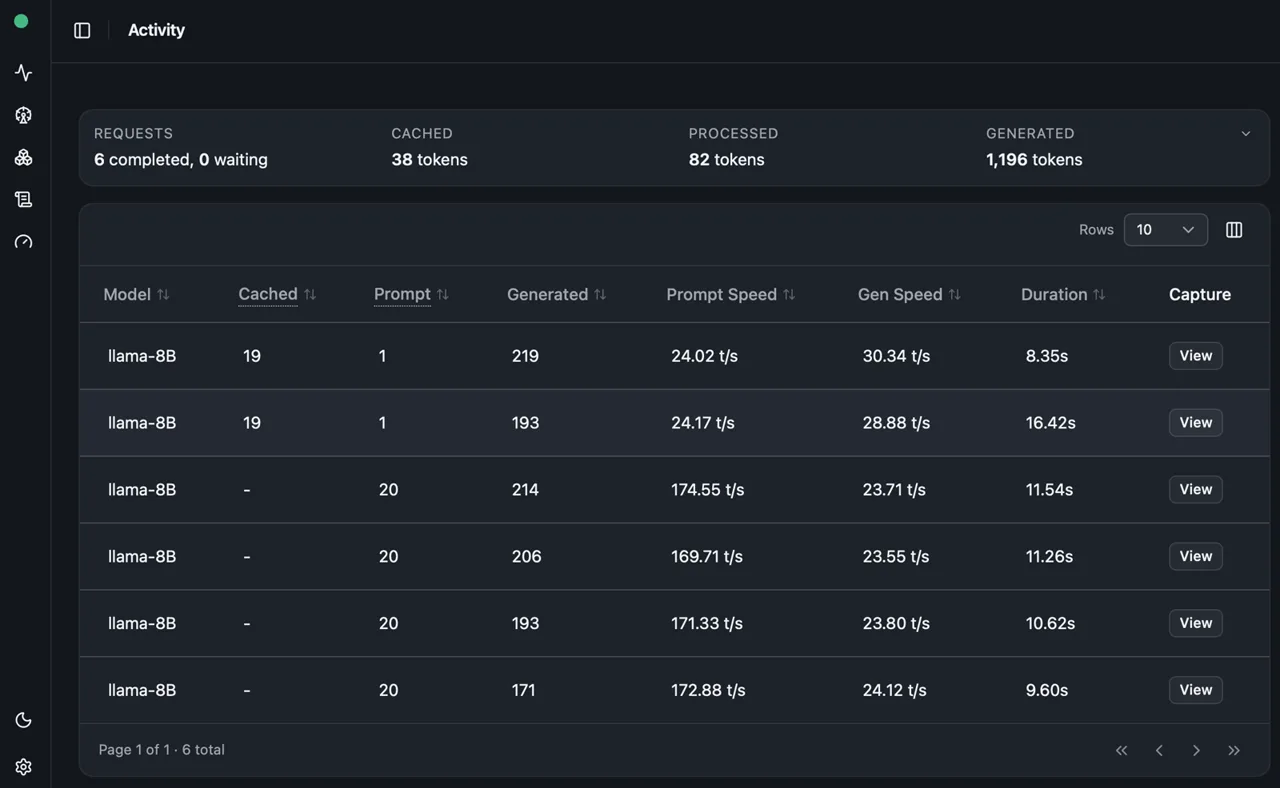
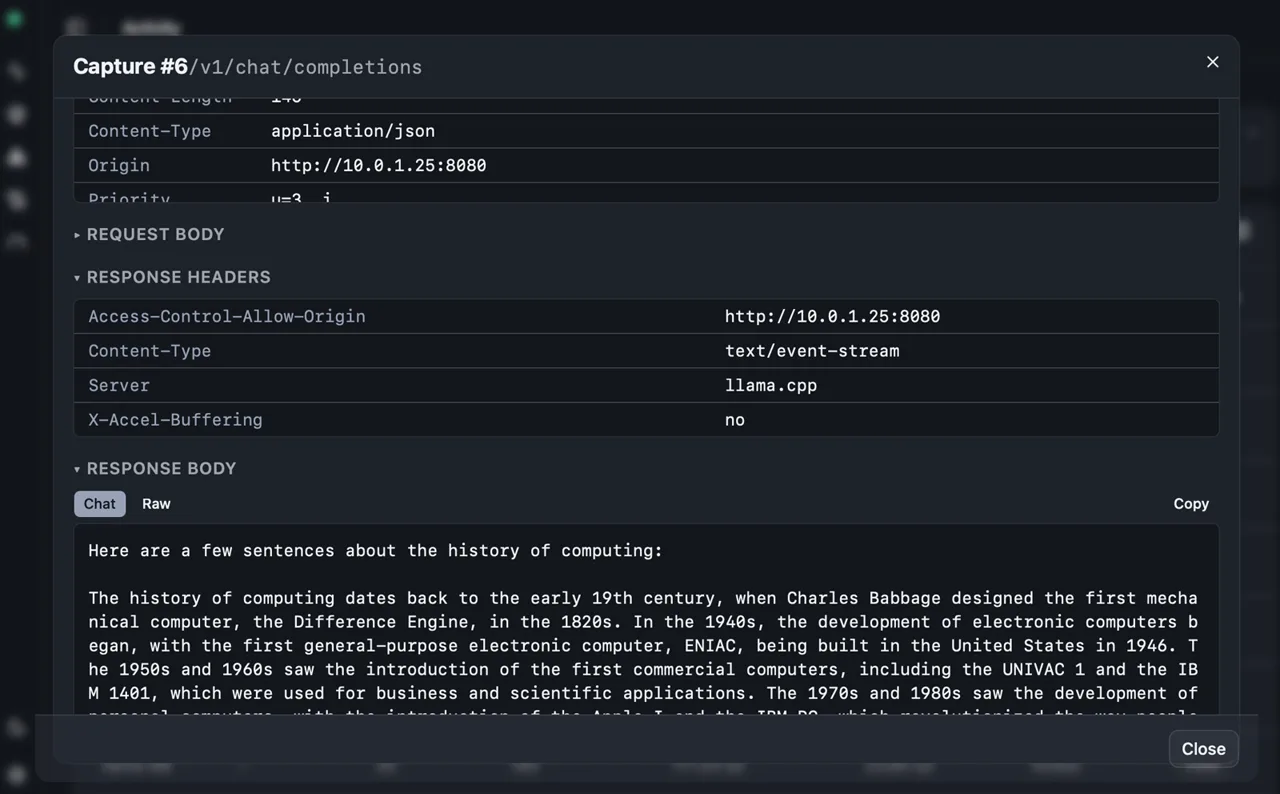
Une interface web, accessible sur /ui, offre un espace de test des modèles, des métriques de jetons, l’inspection des requêtes et réponses, le chargement et le déchargement manuels, et les logs en direct. Des clés d’API peuvent restreindre l’accès, et un point /metrics expose des métriques système et GPU pour Prometheus.
ttl: décharge un modèle après un délai d’inactivitéaliases: permet d’utiliser un nom familier comme « gpt-4o-mini »filters: retire ou impose des paramètres de requête avant l’envoi au serveurhooks: précharge des modèles au démarragecmdStop: arrête proprement les conteneurs Docker ou Podman
Installer llama-swap
Plusieurs voies existent : Docker, Homebrew (macOS et Linux), MacPorts, WinGet, binaires précompilés (Linux, Mac, Windows, FreeBSD) ou compilation depuis les sources, qui demande Go et Node.js. MacPorts et WinGet sont maintenus par la communauté et ne font pas partie du projet officiel.
Pour Docker, le README recommande l’image « unified », qui réunit llama-server, stable-diffusion.cpp, whisper.cpp, audio.cpp et llama-swap. Elle existe en trois variantes : unified-cuda13 pour les cartes NVIDIA d’Ampere à Blackwell, unified-cuda pour les cartes plus anciennes, unified-vulkan pour AMD et autres GPU compatibles Vulkan.
docker pull ghcr.io/mostlygeek/llama-swap:unified-cuda13
docker run -it --rm --runtime nvidia -p 9292:8080 \
 -v /path/to/models:/models \
 -v /path/to/custom/config.yaml:/etc/llama-swap/config/config.yaml \
 ghcr.io/mostlygeek/llama-swap:unified-cuda13
Écrire la première configuration
La configuration minimale tient en trois lignes : sous models, un identifiant (celui que tu utiliseras dans les appels d’API) et une commande cmd qui lance le serveur. La variable ${PORT} est remplacée par un numéro de port attribué automatiquement. Le reste est optionnel et s’ajoute au fil des besoins.
Une fois le fichier prêt, avec Homebrew par exemple, on lance llama-swap en indiquant le fichier et l’adresse d’écoute. Le README précise aussi que les serveurs en Python comme vllm ou tabbyAPI sont mieux lancés via Podman ou Docker, pour isoler l’environnement et réagir correctement au signal SIGTERM à l’arrêt.
models:
  model1:
    cmd: llama-server --port ${PORT} --model /path/to/model.gguf
llama-swap --config path/to/config.yaml --listen localhost:8080
Où en est le projet
Selon les chiffres relevés sur GitHub le 14 octobre 2026, le dépôt compte 5950 étoiles, 500 forks et 84 contributeurs, avec 98 tickets et demandes de fusion ouverts. Il a été créé le 4 octobre 2024, et la dernière version, v265, date du 14 octobre 2026.
Les versions récentes apportent des améliorations ciblées : la v265 permet de servir llama-swap derrière un chemin d’un reverse proxy (un guide nginx et Caddy est inclus) et de déclarer manuellement des voix pour les modèles de synthèse vocale. La v263 affiche la progression du chargement d’un modèle et ajoute une option disableKeepAlives contre certaines erreurs 502.
Ce qu’il faut savoir avant de se lancer
Derrière nginx, il faut désactiver la mise en tampon des réponses pour les routes en streaming, sans quoi le flux de la discussion est cassé. Le README fournit les extraits de configuration à ajouter.
La documentation officielle indique que le projet n’a pas de documentation classique : un agent d’aide intégré, qui tourne sur un modèle local, répond aux questions à partir de la base de connaissances. Certaines pages de ce guide de démarrage, comme l’installation de llama-server, sont encore marquées « à écrire ». Le projet ne donne pas de configuration matérielle minimale.
Quelques repères
- Inférence : C’est l’étape où un modèle d’IA déjà entraîné est utilisé pour produire une réponse à partir d’une requête. Un serveur d’inférence est le programme qui charge le modèle et répond aux demandes.
- Reverse proxy : Un reverse proxy est un serveur placé devant une application, qui reçoit les requêtes des utilisateurs et les transmet à l’application. Il sert à répartir le trafic, sécuriser l’accès ou publier le service sous une adresse donnée.
Questions fréquentes
llama-swap est-il gratuit ?
Oui, llama-swap est open source et publié sous licence MIT. Le README et les notes de version ne mentionnent aucune offre payante.
Quels serveurs fonctionnent avec llama-swap ?
llama-swap fonctionne avec tout serveur compatible avec les API OpenAI ou Anthropic, dont llama.cpp, vllm, stable-diffusion.cpp, audio.cpp et ComfyUI. Il a été conçu à l’origine pour llama-server, qui reste le mieux pris en charge.
Comment décharger automatiquement un modèle avec llama-swap ?
Il suffit de définir l’option ttl pour un modèle : il est alors déchargé automatiquement après le délai indiqué. Un déchargement manuel est aussi possible depuis l’interface web ou via l’API.
Peut-on faire tourner llama.cpp avec llama-swap dans Docker ?
Oui, le projet publie des images Docker. L’image « unified » recommandée inclut llama-server (llama.cpp) et llama-swap, en variantes CUDA 13, CUDA 12 et Vulkan.
À retenir
llama-swap sert de routeur devant des serveurs d’IA locaux : il charge le modèle demandé par chaque requête et décharge les autres, avec un binaire, un fichier YAML et une interface web. Le projet est sous licence MIT et reçoit de nouvelles versions à un rythme soutenu, la dernière datant du 14 octobre 2026.
Sources
- mostlygeekREADME
- docs/README.mddocumentation officielle
- GitHubnotes de version