Sommaire11 parties
llama.cpp est un moteur open source, écrit en C/C++ sans dépendance, qui fait tourner des modèles de langage directement sur ta machine. Il vise une installation minimale et couvre un large éventail de matériels : processeurs, cartes graphiques NVIDIA et AMD, puces Apple. Il embarque aussi un serveur compatible avec l’API d’OpenAI, ce qui permet d’y brancher d’autres applications.
En bref
- Moteur d’inférence en C/C++ pur, sans dépendance, sous licence MIT
- Installation en une ligne, par Docker, par gestionnaire de paquets ou en binaires prêts à l’emploi
- Quantization de 1,5 à 8 bits pour réduire la mémoire, et mode hybride CPU+GPU
- Serveur compatible OpenAI et modèles téléchargés directement depuis Hugging Face
- Application de bureau Llama, développée avec Hugging Face, pour Mac et Windows
Qu’est-ce que llama.cpp ?
llama.cpp est un projet publié par l’organisation ggml-org. Son but, selon son README, est de permettre l’inférence de LLM (et de modèles qui comprennent aussi les images) avec un minimum de configuration, sur une grande variété de matériels, en local comme dans le cloud. L’inférence, c’est l’étape où un modèle déjà entraîné produit une réponse à partir de ton texte.
Le problème réglé est simple à énoncer : faire tourner un modèle de langage sans passer par un service distant. Le projet est écrit en C/C++ pur, sans dépendance, et repose sur la bibliothèque ggml, développée par la même organisation.
Comment fonctionne llama.cpp
Le moteur s’adapte au matériel présent. Sur Apple silicon, que le README range parmi les cibles prioritaires, il s’appuie sur ARM NEON, Accelerate et Metal. Sur les processeurs x86, il gère AVX, AVX2, AVX512 et AMX, et sur RISC-V plusieurs jeux d’instructions dédiés.
Deux mécanismes aident à faire tenir de gros modèles sur des machines modestes. La quantization en entiers de 1,5, 2, 3, 4, 5, 6 ou 8 bits accélère l’inférence et réduit la mémoire utilisée. Et l’inférence hybride CPU+GPU accélère en partie un modèle plus gros que la mémoire vidéo disponible.
- Apple silicon : ARM NEON, Accelerate, Metal
- x86 : AVX, AVX2, AVX512, AMX
- NVIDIA : noyaux CUDA maison, avec HIP pour AMD et MUSA pour Moore Threads
- Vulkan et SYCL comme autres backends graphiques
Quels matériels llama.cpp prend-il en charge ?
Le README dresse un tableau de backends, c’est-à-dire les couches qui parlent à chaque type de puce. Certains ciblent un matériel précis, d’autres sont généralistes.
Le tableau mentionne aussi OpenVINO pour les puces Intel, signalé comme en cours de développement. La documentation du projet détaille la compilation de chacun de ces backends.
- CUDA pour les GPU Nvidia, HIP pour les GPU AMD
- Metal pour Apple Silicon
- SYCL pour les GPU Intel, OpenCL pour les GPU Adreno
- Hexagon pour Snapdragon, CANN pour les NPU Huawei Ascend
- Vulkan, WebGPU, BLAS et RPC pour un usage plus général
Installer llama.cpp
Le README propose plusieurs voies : un script d’installation, Docker, les binaires précompilés de la page des versions, ou la compilation depuis les sources avec le guide de build. Les deux commandes du script sont les suivantes.
La documentation d’installation liste aussi des gestionnaires de paquets : conda-forge sur Windows, Mac et Linux, Winget sur Windows, Homebrew sur Mac et Linux, MacPorts sur Mac et Nix sur Mac et Linux. Winget et Homebrew sont mis à jour automatiquement à chaque nouvelle version.
curl -LsSf https://llama.app/install.sh | sh
irm https://llama.app/install.ps1 | iex
winget install llama.cpp
brew install llama.cpp
Utiliser un modèle Hugging Face et l’API compatible OpenAI
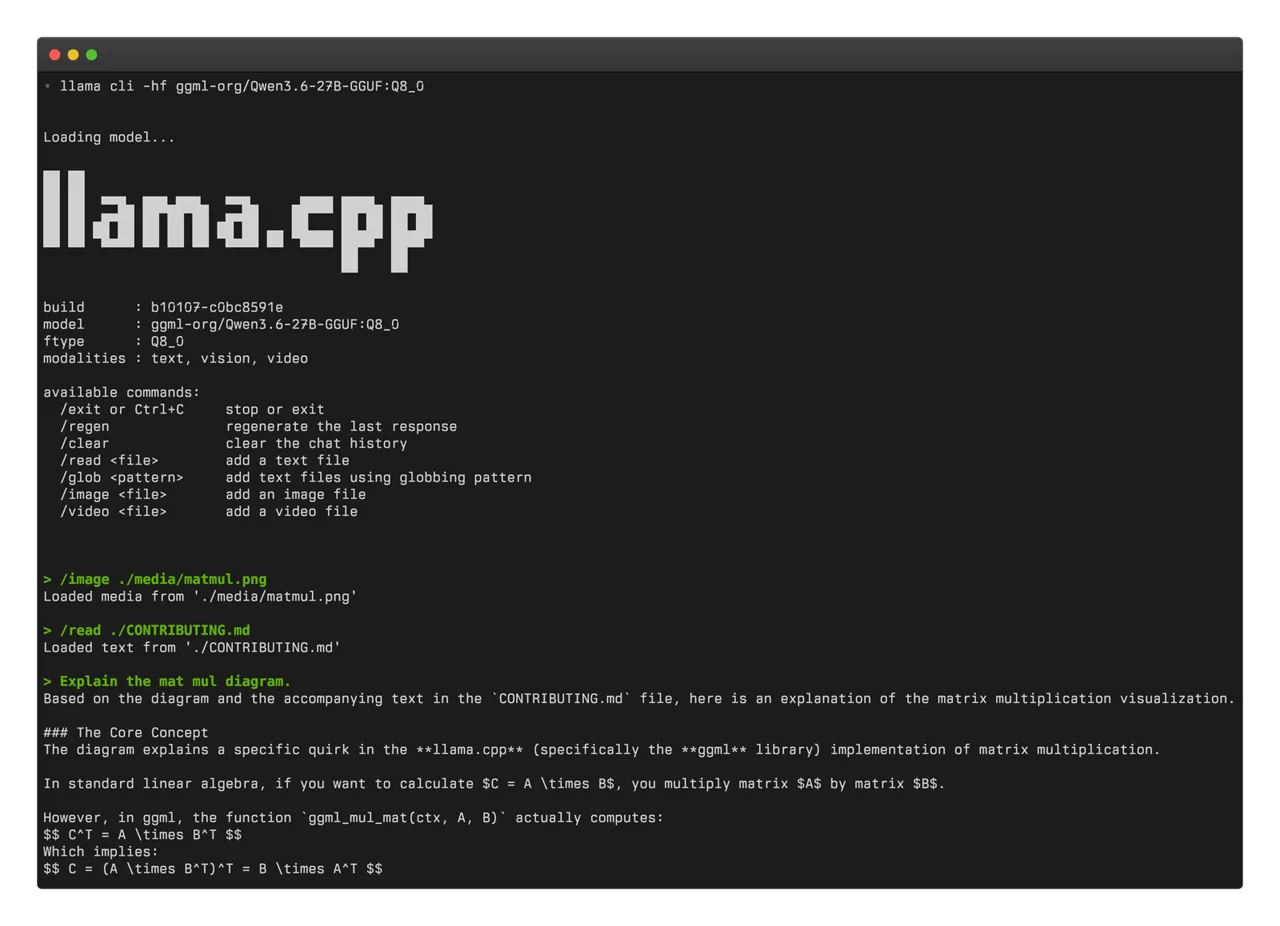
Une fois llama.cpp installé, la commande llama cli télécharge et lance un modèle directement depuis Hugging Face, la plateforme où sont publiés de nombreux modèles. La commande llama serve démarre pour sa part un serveur compatible avec l’API d’OpenAI, doté d’une interface web intégrée.
Les deux exemples du README utilisent un petit modèle, Qwen3.5-0.8B au format GGUF. Le README ne précise pas la mémoire ou la configuration minimale requise pour d’autres modèles.
llama cli -hf ggml-org/Qwen3.5-0.8B-GGUF
llama serve -hf ggml-org/Qwen3.5-0.8B-GGUF
Llama, l’application pour Mac et Windows
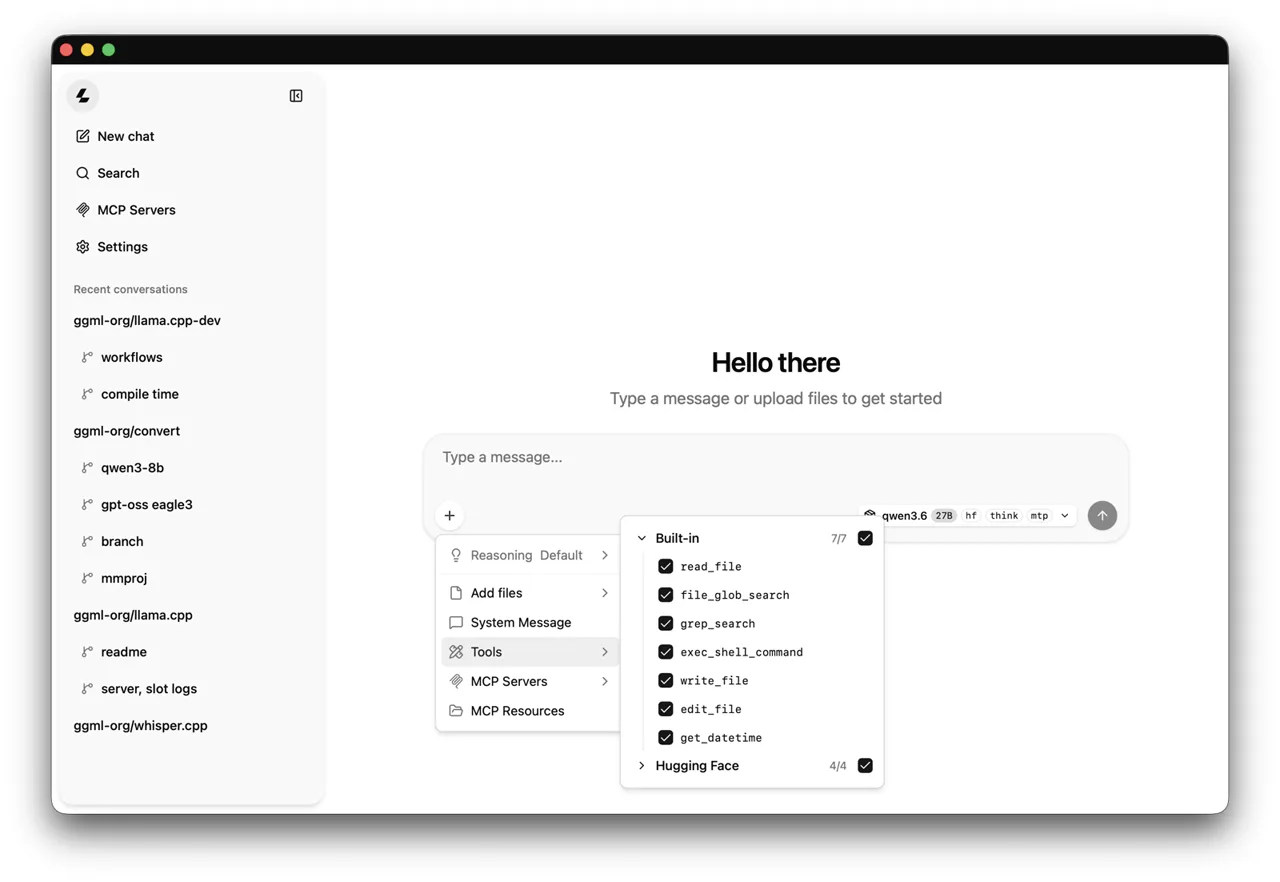
Le projet a une vitrine grand public, llama.app, réalisée par l’équipe de llama.cpp avec Hugging Face. Il s’agit d’une petite application de barre de menus (Mac) ou de zone de notification (Windows) qui fait tourner des modèles ouverts sur l’ordinateur. Elle est présentée comme gratuite, open source et fonctionnelle hors ligne, avec un téléchargement d’environ 1 Mo.
Elle ouvre une discussion dans le navigateur et expose une API locale, qui accepte les requêtes au format OpenAI ; le site mentionne aussi des points d’accès compatibles Anthropic, le streaming, les appels d’outils, les sorties structurées et la vision. Elle choisit elle-même les réglages de chaque modèle selon la machine, mais tous les réglages de llama.cpp restent accessibles dans un fichier texte. Les modèles se chargent à la demande et se déchargent après 5 minutes d’inactivité, et ils sont conservés une seule fois dans le cache de Hugging Face, partagé avec llama.cpp.
Où en est le projet
Au 17 novembre 2026, le dépôt compte 135 401 étoiles, 25 673 forks, 2 256 contributeurs et 2 625 tickets et demandes de fusion ouverts. Il a été créé le 10 mars 2023, et son code a été modifié pour la dernière fois le jour du relevé. Le code est écrit à 56 % en C++, 16 % en C, 8 % en Python et 5 % en Cuda.
Les versions se succèdent à un rythme soutenu : trois préversions (b12463, b12464 et b12465) sont parues le 17 novembre 2026. La dernière corrige notamment des noyaux SYCL. Sur le plan juridique, le projet est sous licence MIT. Le README précise que les contributeurs peuvent ouvrir des demandes de fusion, et que l’aide à la gestion des tickets est bienvenue.
Quelques repères
- Modèle de langage (LLM) : Un programme entraîné sur de grandes quantités de texte, capable de produire des réponses, de résumer ou de rédiger à partir d’une consigne écrite.
- Quantization : Technique qui stocke les nombres d’un modèle avec moins de précision. Le modèle occupe moins de mémoire et s’exécute plus vite, au prix d’une légère perte de précision.
- API : Interface qui permet à un logiciel d’en utiliser un autre en lui envoyant des requêtes dans un format convenu, sans passer par une fenêtre ou un bouton.
Questions fréquentes
llama.cpp est-il gratuit ?
Oui. llama.cpp est sous licence MIT et son code est ouvert. L’application Llama de llama.app est elle aussi présentée comme gratuite et open source.
Comment installer llama.cpp sur Mac ou Windows ?
Sur Mac, la commande brew install llama.cpp fonctionne avec Homebrew. Sur Windows, winget install llama.cpp ou le script PowerShell du README conviennent. Des binaires précompilés sont aussi disponibles sur la page des versions.
llama.cpp peut-il tourner sans carte graphique ?
Oui, le moteur gère les processeurs x86 et ARM, avec AVX, AVX2, AVX512, AMX ou ARM NEON. Il propose aussi un mode hybride CPU+GPU pour les modèles plus gros que la mémoire vidéo. Le projet ne donne pas de configuration minimale.
llama.cpp propose-t-il un serveur compatible OpenAI ?
Oui, la commande llama serve lance un serveur compatible OpenAI, avec une interface web intégrée. Le README en donne un exemple avec un modèle Hugging Face.
À retenir
llama.cpp est un moteur C/C++ sous licence MIT qui fait tourner des modèles de langage en local, sur de nombreux matériels, avec quantization et serveur compatible OpenAI. Le dépôt est très actif au 17 novembre 2026, avec plusieurs versions publiées le même jour.
Sources
- ggml-orgREADME
- llama.appdocumentation officielle
- docs/install.mddocumentation officielle
- GitHubnotes de version