Sommaire11 parties
llmfit est un outil open source en ligne de commande qui détecte ton matériel (processeur, mémoire, carte graphique) et indique quels modèles de langage ta machine peut faire tourner en local. Il note chaque modèle sur la qualité, la vitesse, l’adéquation mémoire et la taille de contexte. Il s’utilise dans le terminal, avec une sortie JSON pour les scripts, ou via un serveur HTTP et une interface web.
En bref
- Détecte CPU, RAM, GPU et VRAM (NVIDIA CUDA, Apple Silicon, AMD ROCm, Intel OneAPI)
- Note chaque modèle sur la qualité, la vitesse, l’adéquation et le contexte
- Interface terminal interactive, mode CLI avec sortie JSON, serveur HTTP avec llmfit serve
- Mesure les tokens par seconde réels avec llmfit bench et planifie l’espace disque
- Écrit en Rust, licence MIT, disponible sur Windows, macOS et Linux
À quoi sert llmfit
Faire tourner un modèle de langage sur sa propre machine soulève vite la même question : est-ce que ça va suivre ? Selon la taille du modèle et son format de compression, la mémoire nécessaire change beaucoup, et le choix se fait souvent à tâtons. llmfit règle ce problème en inspectant ton CPU, ta RAM, ton ou tes GPU et leur VRAM, puis en recommandant des modèles parmi les quantifications courantes.
Le projet est écrit par AlexsJones, en Rust, et publié sous licence MIT. Sa description tient en une phrase : des centaines de modèles et de fournisseurs, et une seule commande pour trouver ce qui tourne sur ton matériel.
Comment fonctionne llmfit
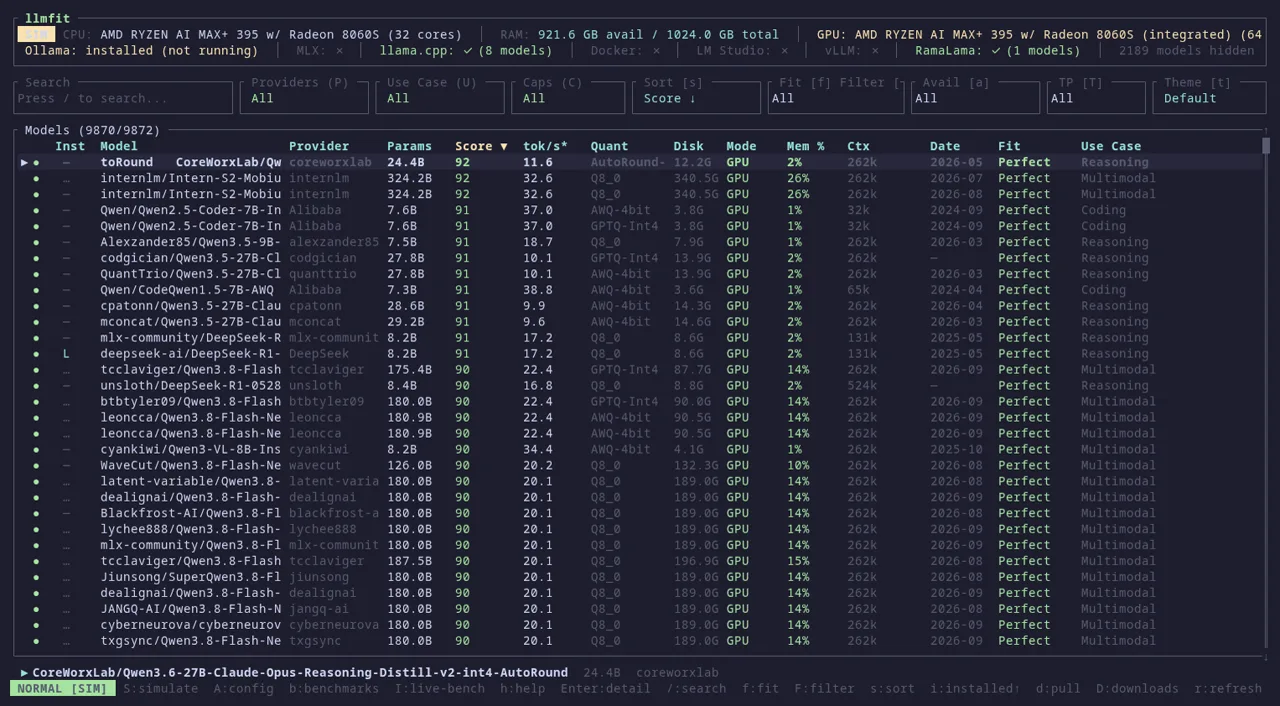
llmfit commence par détecter ton matériel : RAM, CPU, GPU et VRAM, ainsi que le backend (la technologie de calcul utilisée, par exemple CUDA ou ROCm). Il note ensuite chaque modèle de son catalogue sur quatre dimensions : l’adéquation mémoire, la vitesse estimée, la qualité et le contexte. Pour cela, il analyse le nombre de paramètres, la longueur de contexte et le format de quantification (GGUF, AWQ, GPTQ, EXL2) afin de projeter l’empreinte mémoire et le nombre de tokens par seconde.
Les estimations de vitesse reposent sur un modèle de bande passante mémoire, appuyé sur des échantillonnages de runtimes et des mesures réalisées par la communauté. Chaque estimation affiche ses hypothèses : la commande llmfit info montre ce qu’un chiffre suppose et comment le vérifier sur ta machine. Le projet gère aussi les configurations à plusieurs GPU et les architectures MoE (Mixture-of-Experts).
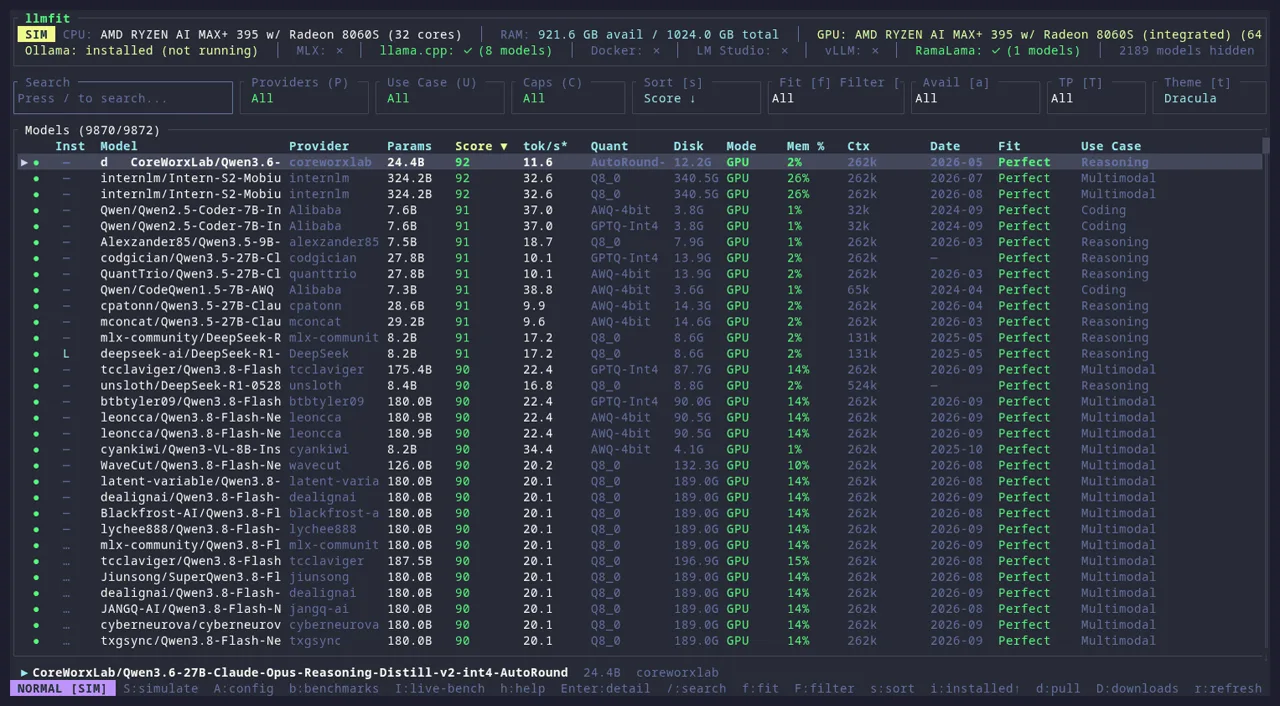
Ce que llmfit sait faire
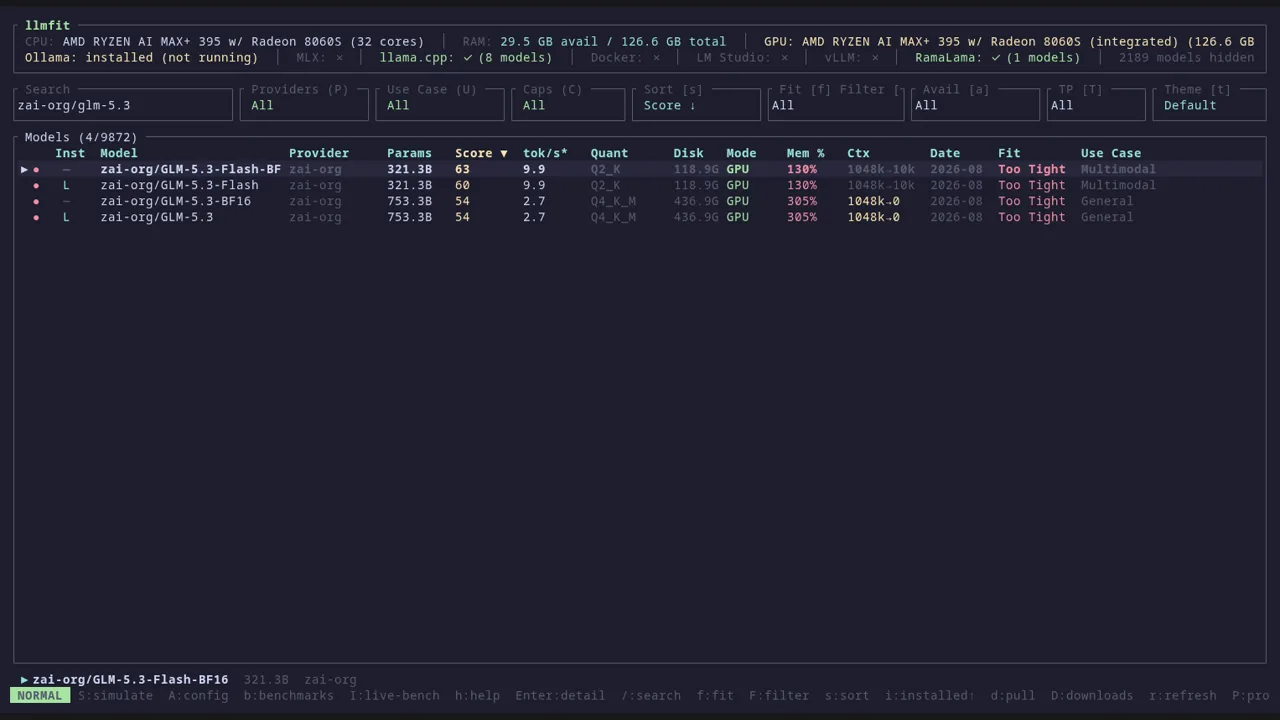
L’outil se lance par défaut en interface interactive dans le terminal : tes caractéristiques détectées s’affichent en haut, et tous les modèles sont classés en dessous. Une touche / permet de filtrer par nom, par famille ou par quantification. Un mode CLI classique existe pour les scripts et les agents.
- Détection du matériel sur NVIDIA CUDA, Apple Silicon, AMD ROCm et Intel OneAPI, y compris la mémoire unifiée
- Tableau de tous les modèles classés par adéquation avec
llmfit fit, fiche détaillée d’un modèle avecllmfit info - Sortie JSON des meilleures recommandations avec
llmfit recommend --json - Serveur HTTP et interface web, avec les points d’accès
/api/v1/systemet/api/v1/models - Prise en charge des fournisseurs locaux Ollama, llama.cpp, MLX, Docker Model Runner et LM Studio
- Rapport de détection matérielle avec
llmfit doctor, utile pour joindre un signalement de bug
Installer llmfit sur Windows, macOS et Linux
llmfit fonctionne sur macOS (Apple Silicon et Intel), Linux (x86_64 et ARM64) et Windows (x86_64). Sous Windows, le README indique Scoop ; sous macOS et Linux, Homebrew ; dans tous les cas, uv permet aussi de l’installer. Des binaires précompilés sont disponibles sur la page des versions du dépôt GitHub.
Une fois installé, lancer llmfit sans option ouvre l’interface interactive, et llmfit recommend affiche le matériel détecté et les modèles recommandés. Le serveur HTTP se démarre avec llmfit serve --host 0.0.0.0 --port 8787. Une image Docker multi-architecture existe aussi, pour l’interface interactive comme pour le serveur.
scoop install llmfit
brew install AlexsJones/llmfit/llmfit
uv tool install -U llmfit
llmfit
llmfit recommend
docker run -it --rm ghcr.io/alexsjones/llmfit --tui
Mesurer les tokens par seconde et l’espace disque
Une estimation reste une estimation. La commande llmfit bench mesure les tokens par seconde et le délai avant le premier token (TTFT) sur le fournisseur que tu fais tourner. Avec l’option --share, tu peux partager tes résultats avec la communauté. Le README décrit aussi un parcours depuis l’interface : télécharger un modèle, le servir, mesurer, puis proposer les résultats au projet sous forme de PR, sans CLI gh ni compte tiers.
Chaque mesure est d’abord enregistrée en local, et tes propres chiffres remplacent les estimations dans le tableau. Les contributions fusionnées sont livrées dans la version suivante : une personne qui a un matériel identique voit alors des chiffres mesurés avant même de lancer un test. Pour le disque, llmfit storage estime la capacité de SSD nécessaire pour garder un nombre donné de modèles exécutables.
llmfit bench --share
llmfit storage --keep 3 --selection largest --json
Où en est le projet
Au 8 octobre 2026, le dépôt compte 37 701 étoiles, 2 419 copies (forks) et 154 contributeurs, avec 80 tickets et demandes de fusion ouverts. Il a été créé le 15 février 2026, et son code a été modifié pour la dernière fois le 7 octobre 2026. Le code est écrit à 84 % en Rust, avec du Python (10 %), du JavaScript (4 %) et du CSS (1 %).
La dernière version publiée, la v1.1.16 du 19 septembre 2026, ajoute un estimateur de capacité de sessions simultanées, la planification d’espace disque pour les bibliothèques de modèles et la reconnaissance des modèles ternaires natifs (1,58 bit). Elle intègre aussi une mise à jour du catalogue de septembre 2026 (GLM-5.3, Qwen3.8-Flash-Next, DeepSeek-V4.1, Kimi-K3, entre autres) et plusieurs corrections : mémoire unifiée des puces Apple de série A, évaluation des chemins GPU selon la VRAM libre, et fiabilité des mesures de llmfit bench. La v1.1.15 du 10 septembre 2026 avait surtout apporté des corrections de benchmark, un affichage plus léger des lignes dans l’interface, et des résultats communautaires pour plusieurs matériels.
Ce qu’il faut savoir avant de se lancer
Les chiffres de vitesse et de mémoire que donne llmfit sont des estimations, calculées à partir de tes caractéristiques et de mesures de la communauté. Pour obtenir des chiffres réels, il faut passer par llmfit bench. Le README cite d’ailleurs llm-checker comme alternative : un outil Node.js qui exécute réellement les modèles via Ollama au lieu de les estimer, mais qui, selon le README de llmfit, traite tous les modèles comme denses et ne gère donc pas les architectures MoE.
Côté Windows, le README précise que les binaires sont signés seulement si l’étape de signature de la version a réussi en entier : une version peut donc sortir avec un exécutable non signé, et il est conseillé de vérifier la signature. Côté confidentialité, le projet indique que llmfit ne contacte des services externes que lorsque tu utilises une fonction qui l’exige, comme les téléchargements de modèles, les requêtes aux fournisseurs ou le classement communautaire. Le projet ne donne pas de configuration minimale pour l’outil lui-même.
Quelques repères
- Quantification : Technique qui réduit la précision des nombres stockés dans un modèle pour qu’il occupe moins de mémoire. Le modèle devient plus léger à faire tourner, avec une perte de qualité possible.
- VRAM : Mémoire propre à la carte graphique. Un modèle de langage doit en grande partie y tenir pour tourner rapidement sur le GPU.
- API : Interface qui permet à un programme d’en interroger un autre par des requêtes, sans passer par un écran. Elle sert à brancher un outil sur des scripts ou d’autres logiciels.
Questions fréquentes
llmfit est-il gratuit et open source ?
llmfit est publié sous licence MIT, et son code est ouvert sur GitHub. Le README ne mentionne aucun prix ni offre payante.
Comment installer llmfit ?
Sous Windows, scoop install llmfit. Sous macOS et Linux, brew install AlexsJones/llmfit/llmfit, ou uv tool install -U llmfit sur toutes les plateformes. Des binaires précompilés et une image Docker sont aussi proposés.
llmfit mesure-t-il vraiment la vitesse des modèles ou l’estime-t-il ?
Par défaut, llmfit estime la vitesse avec un modèle de bande passante mémoire. Pour obtenir des tokens par seconde mesurés sur ta machine, il faut lancer llmfit bench avec un fournisseur en marche.
llmfit fonctionne-t-il avec une carte graphique AMD ou un Mac ?
Oui, llmfit détecte NVIDIA CUDA, Apple Silicon, AMD ROCm et Intel OneAPI. Il fonctionne sur macOS (Apple Silicon et Intel), Linux (x86_64 et ARM64) et Windows (x86_64).
À retenir
llmfit détecte ton matériel et classe les modèles de langage selon ce qu’il peut vraiment faire tourner, avec des estimations dont les hypothèses sont affichées. Pour passer de l’estimation à la mesure, llmfit bench relève les tokens par seconde réels sur ta machine.
Sources
- AlexsJonesREADME
- GitHubnotes de version