Sommaire11 parties
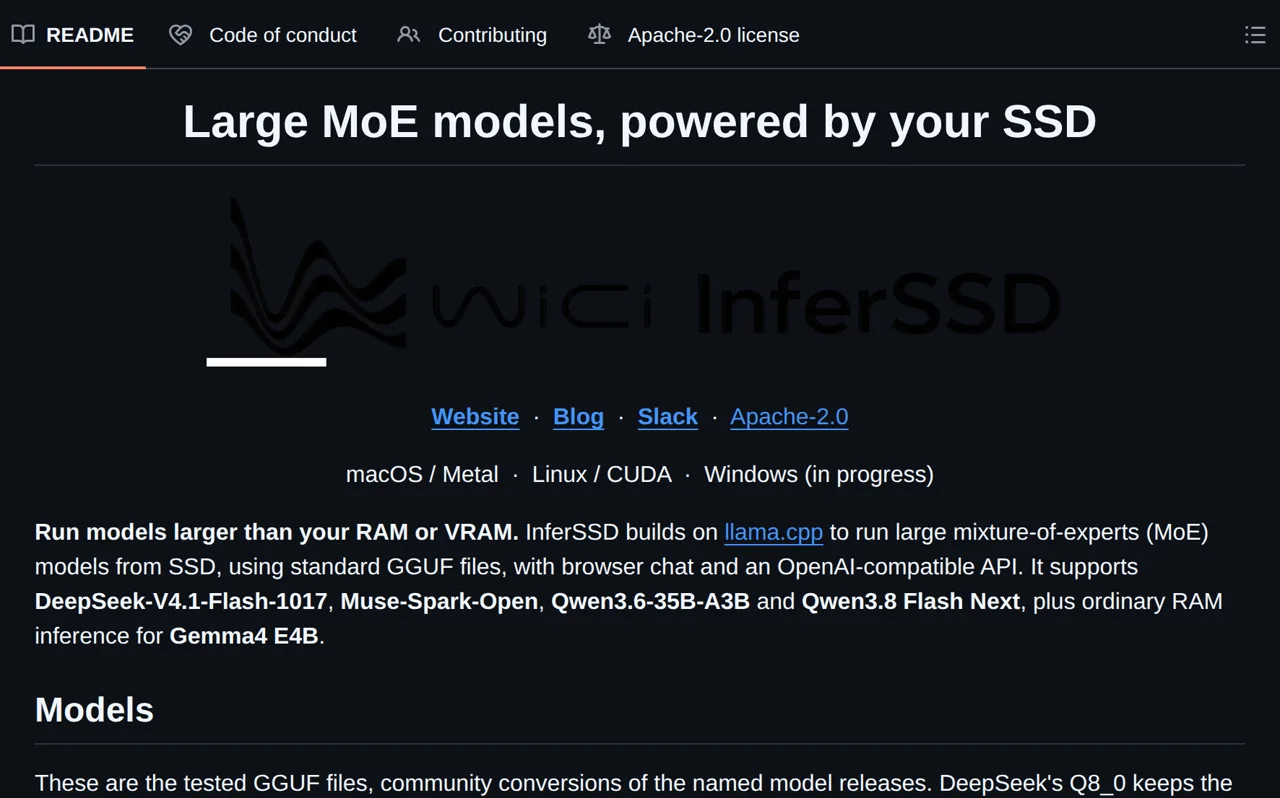
InferSSD est un moteur d’inférence open source qui fait tourner des modèles « mixture of experts » (MoE) plus gros que la mémoire de ta machine, en allant lire les experts sur le SSD. Il s’appuie sur llama.cpp et sur des fichiers GGUF classiques. Tu peux discuter avec le modèle dans le terminal ou dans le navigateur, ou le brancher à un outil via une API compatible OpenAI, le tout en local.
En bref
- Fait tourner des modèles MoE plus gros que la RAM ou la VRAM, en lisant les experts sur le SSD
- Construit sur llama.cpp, avec des fichiers GGUF standard
- Modèles testés : DeepSeek-V4.1-Flash-1017, Muse-Spark-Open, Qwen3.6-35B-A3B, Qwen3.8 Flash Next
- Installation en une ligne ; chat web et API compatible OpenAI en local
- Licence Apache-2.0
Pourquoi faire tourner un modèle plus gros que sa RAM
Les plus gros modèles de langage dépassent largement la mémoire d’un ordinateur personnel. Le DeepSeek-V4.1-Flash-1017 testé par le projet compte 763 milliards de paramètres au total, et son fichier GGUF pèse environ 470 GiB. Il ne tient donc ni dans la RAM ni dans la VRAM (la mémoire de la carte graphique) d’une machine de bureau.
InferSSD vise ce cas : il lit les modèles de type MoE directement depuis le SSD, au lieu de tout charger en mémoire. Le projet est publié par wici-ai sous licence Apache-2.0, et son code est surtout en C++.
Comment fonctionne InferSSD
Un modèle MoE est découpé en nombreux « experts », et seuls quelques-uns servent pour chaque mot produit. C’est pour cela que DeepSeek-V4.1-Flash-1017 est décrit avec 8 à 16 milliards de paramètres actifs sur 763 milliards au total. InferSSD garde en mémoire ce qui sert tout le temps et va chercher les experts sur le SSD quand le modèle en a besoin.
La documentation décrit des caches d’experts en RAM et, sur GPU NVIDIA, dans la VRAM. Pendant la génération, chaque couche du modèle prédit les experts de la couche suivante, et le moteur commence à les lire pendant que le disque serait sinon en attente. Un réglage, prefetch.depth, fixe le nombre d’experts prédits à lire à l’avance ; sa valeur par défaut est 64.
Côté mémoire, tu n’as rien à régler : le README explique que le moteur utilise la mémoire disponible et garde sa propre marge pour le système. Au premier lancement, il mesure aussi ta machine.
Les modèles pris en charge par InferSSD
Le projet ne prend pas n’importe quel fichier : il liste des fichiers GGUF testés, des conversions de la communauté. Pour DeepSeek, le Q8_0 garde les largeurs de bits officielles : les experts restent en MXFP4 (4 bits) et les tenseurs FP8 passent en Q8_0 (8 bits).
Gemma 4 E4B passe par le chargeur ordinaire, sans lecture des experts sur SSD. Avant le chargement, le lanceur vérifie que les poids, le cache de contexte et la mémoire de travail tiennent dans la RAM disponible, et refuse sinon.
- DeepSeek-V4.1-Flash-1017 : 763 milliards de paramètres au total, Q8_0
- Muse-Spark-Open : 816 milliards au total, 42 milliards actifs, UD-Q4_K_XL
- Qwen3.6-35B-A3B : 35 milliards au total, 3 milliards actifs, UD-Q4_K_XL
- Qwen3.8 Flash Next : 177 milliards au total, IQ4_XS
- Gemma 4 E4B : inférence classique en RAM, QAT Q4_0
Quelle vitesse sur un Mac ou une carte NVIDIA
Les mesures du README portent sur un prompt de 4K tokens et 256 tokens générés. La vitesse de génération (decode) est mesurée sur les tokens 129 à 256, et le traitement du prompt (prefill) est mesuré à part. Le projet compare InferSSD à llama.cpp seul, sur le même matériel.
Sur un MacBook Pro M5 Max avec 48 Go de mémoire unifiée, DeepSeek passe de 0,873 à 2,874 token/s en decode, et de 5,929 à 28,766 token/s en prefill. Sur une RTX 5090, le decode passe de 0,867 à 7,270 token/s ; sur un DGX Spark, de 1,608 à 7,260. Ce sont des vitesses de lecture lente, mais le README les présente comme un gain de 3,29 à 10,54 fois selon la machine pour DeepSeek.
Installer InferSSD et lancer un premier modèle
Une ligne suffit sur macOS (Apple Silicon) ou Linux avec une carte NVIDIA. L’installateur travaille dans un environnement privé et n’utilise pas sudo. Sur Linux, il compile le moteur depuis les sources, ce qui prend environ 2 à 12 minutes selon le README.
Ensuite, inferssd cli ouvre un chat dans le terminal et inferssd serve démarre l’interface web et l’API compatible OpenAI sur le port 8080 de ta machine. Le premier lancement télécharge les fichiers du modèle dans ~/.local/share/inferssd/models ; --model-dir permet de choisir un autre disque et -m de pointer vers des fichiers déjà présents. Pour sortir, Ctrl+C ou /exit dans le chat.
curl -fsSL https://github.com/wici-ai/inferssd/releases/latest/download/install.sh | sh
inferssd cli -hf mrfakename/DeepSeek-V4.1-Flash-1017-GGUF
inferssd serve -hf mrfakename/DeepSeek-V4.1-Flash-1017-GGUF
Où en est le projet
Le dépôt a été créé le 22 octobre 2026 et la dernière version, la v0.1.4, date du 9 novembre 2026. Elle ajoute Qwen3.8 Flash Next et Gemma 4 E4B, et publie ensemble des paquets précompilés pour macOS et Windows, qui s’installent sans compilateur. Les versions précédentes ont apporté Qwen3.6-35B-A3B, une estimation de la vitesse de chaque modèle sur ta machine avec inferssd profile, et des réglages du niveau de raisonnement selon le modèle.
Au 13 novembre 2026, le dépôt compte 1 038 étoiles, 77 forks, 8 contributeurs et 21 tickets et demandes de fusion ouverts.
Ce qu’il faut savoir avant de se lancer
Prévois d’abord l’espace disque : environ 470 GiB pour DeepSeek ou Muse, 21 GiB pour Qwen3.6. Le README ne donne pas de mémoire minimale ; il indique seulement que le lanceur refuse un modèle qui ne tient pas.
Avec serve --host 0.0.0.0, l’API devient accessible depuis le réseau, sans authentification : toute personne qui atteint le port peut l’utiliser. Quand le GPU participe au calcul des experts, une réponse peut varier d’une exécution à l’autre sur le même prompt, selon les notes de la v0.1.3. Enfin, les poids des modèles restent soumis aux licences de leurs éditeurs, et le README affiche encore Windows comme « en cours » alors que les notes de la v0.1.4 publient un paquet Windows 11 x64.
Quelques repères
- Mixture of experts (MoE) : Type de modèle de langage composé de nombreux sous-réseaux appelés experts. Pour chaque mot produit, seuls quelques experts sont sollicités, ce qui limite le calcul nécessaire.
- GGUF : Format de fichier qui regroupe les poids d’un modèle de langage, souvent compressés par quantification, pour les faire tourner en local.
- API compatible OpenAI : Interface qui reprend la forme des requêtes d’OpenAI. Les outils conçus pour ce service peuvent alors se brancher sur un autre serveur, ici ta propre machine.
Questions fréquentes
InferSSD peut-il faire tourner un modèle plus gros que ma RAM ?
Oui, pour les modèles MoE de sa liste. InferSSD lit les experts sur le SSD au lieu de tout charger en mémoire, à partir de fichiers GGUF standard.
Comment lancer DeepSeek en local avec InferSSD ?
Installe InferSSD avec la commande en une ligne, puis lance inferssd cli -hf mrfakename/DeepSeek-V4.1-Flash-1017-GGUF pour chatter dans le terminal. Le premier lancement télécharge environ 470 GiB de fichiers.
InferSSD propose-t-il une API compatible OpenAI ?
Oui. inferssd serve démarre l’interface web et une API compatible OpenAI sur le port 8080 de ta machine. Elle n’a pas d’authentification.
InferSSD est-il gratuit ?
Le code d’InferSSD est publié sous licence Apache-2.0. Les poids des modèles restent soumis aux licences de leurs éditeurs.
À retenir
InferSSD permet de lancer en local des modèles MoE plus gros que la RAM, en lisant les experts sur le SSD, avec un chat web et une API compatible OpenAI. Sur le MacBook Pro M5 Max mesuré par le projet, DeepSeek-V4.1-Flash-1017 génère à 2,874 token/s, contre 0,873 pour llama.cpp seul.
Sources
- wici-aiREADME
- docs/README.mddocumentation officielle
- docs/quickstart.mddocumentation officielle
- docs/configuration.mddocumentation officielle
- GitHubnotes de version