Sommaire11 parties
FreeToken est un moteur d’inférence open source conçu pour faire tourner de très gros modèles de type MoE (Mixture-of-Experts) sur du matériel grand public, comme un PC de jeu équipé d’une carte NVIDIA RTX. Son README annonce des modèles de plus de 290 milliards de paramètres en local. Il répartit le travail entre le GPU, le processeur et la mémoire de la machine, et expose des API compatibles OpenAI et Anthropic.
En bref
- Moteur open source (Apache-2.0) pour modèles MoE sur PC grand public
- Utilise ensemble GPU, CPU et mémoire de la machine
- API compatibles OpenAI et Anthropic, lancement d’agents comme Claude Code ou Codex
- Appli de bureau (Windows, Linux) et ligne de commande (Linux x86_64, NVIDIA)
- Version v0.2.2 publiée le 9 novembre 2026
Qu’est-ce que FreeToken ?
FreeToken est un moteur qui sert des modèles de langage sur ta propre machine, à la manière d’un serveur que tu installerais chez toi plutôt que d’appeler une API dans le cloud. Il cible les modèles à architecture MoE, dont les « experts » sont nombreux mais ne sont pas tous sollicités à chaque mot produit.
Le projet part d’un constat : un modèle de cette taille ne tient pas dans la mémoire d’une carte graphique grand public. FreeToken traite donc les ressources d’un PC (GPU, CPU, mémoire vive, liens entre les deux) comme une seule plateforme d’inférence, au lieu de tout exiger de la carte graphique.
Comment fonctionne FreeToken
Selon le README, le moteur combine plusieurs techniques. Une politique d’exécution adaptée à la bande passante répartit le calcul entre CPU et GPU, un cache global de type LRU garde en mémoire les experts utilisés récemment, et le chargement des couches pendant la phase de lecture du prompt se fait en double tampon, en flux continu. Le projet a aussi son propre format de poids, nommé FTW.
Deux autres idées visent l’usage avec des agents de code. Des points de contrôle « sémantiques » conservent l’état du contexte pour qu’une modification (appel d’outil, bloc de réflexion) n’oblige pas à tout recalculer. Et la mémoire vidéo peut être réallouée en cours de route entre le cache des experts et le cache de contexte (KV), sans redémarrer le moteur ni recharger les poids.
- Exécution partagée entre CPU et GPU selon la bande passante
- Cache LRU global des experts
- Points de contrôle pour éviter de recalculer le contexte
- Réallocation de la VRAM à chaud entre experts et contexte
Installer FreeToken
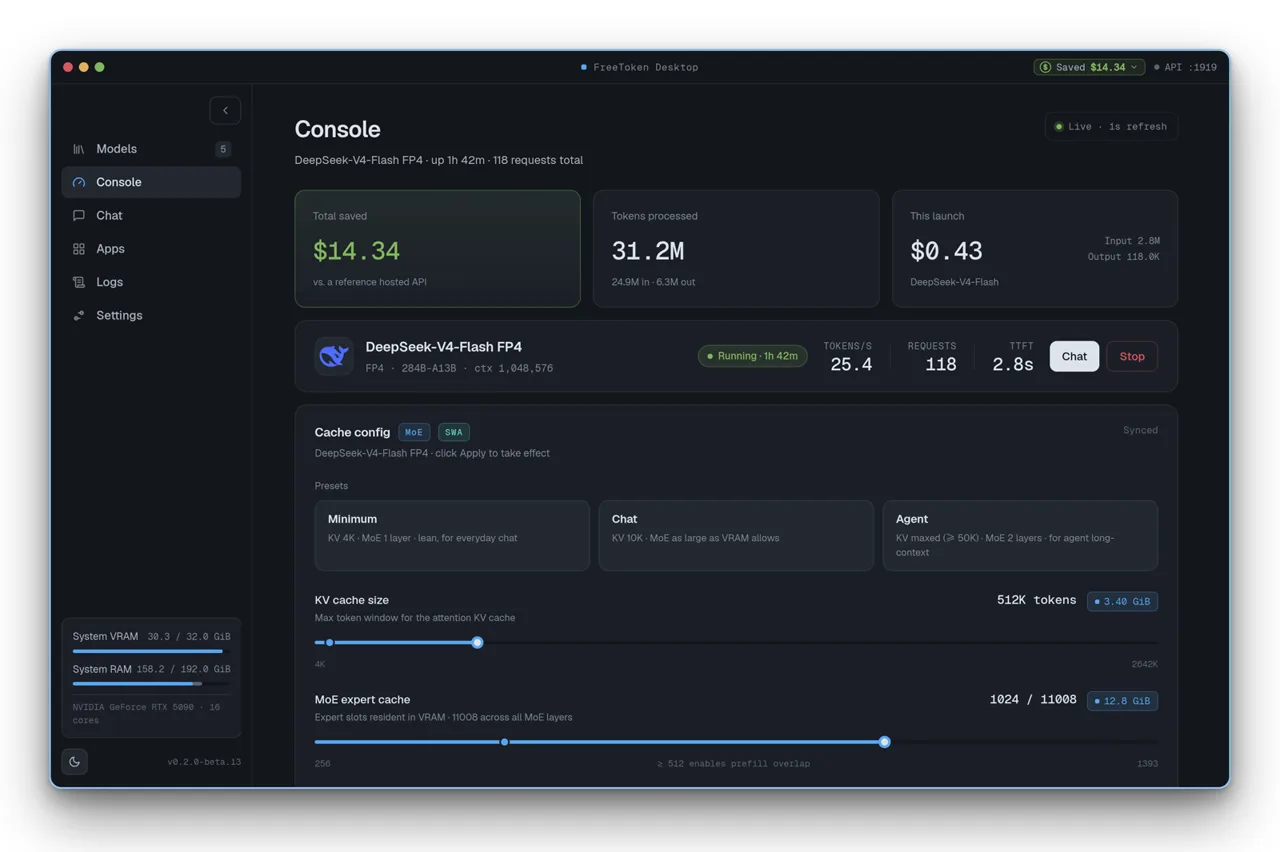
Deux voies existent. L’appli de bureau, téléchargeable sur flashml.ai pour Windows ou Linux, installe le moteur à ta place et offre une interface pour lancer des modèles, discuter et régler le moteur.
La ligne de commande demande Linux x86_64, une carte NVIDIA avec un pilote r580 ou plus récent (CUDA 13) et Python 3.10 ou plus. Les noyaux CUDA sont compilés à la volée au premier usage, ce qui exige un kit CUDA 13 avec nvcc dans le PATH. L’installation recommandée passe par uv :
uv pip install "freetoken[accel]"Lancer un modèle et connecter Claude Code ou un autre agent
Le serveur se démarre avec ft serve, en pointant un dossier de modèle, un identifiant Hugging Face ou un fichier .gguf. Les réglages (type de données, caches, analyseurs d’appels d’outils) sont déduits du modèle et de la carte graphique. Le serveur est prêt quand le journal affiche son adresse locale, sur le port 1919.
FreeToken sert les API OpenAI (/v1/chat/completions, /v1/responses) et Anthropic (/v1/messages) : une bibliothèque cliente de l’un ou l’autre fonctionne en changeant l’adresse de base. Pour un agent de code, la commande ft launch écrit la configuration du fournisseur, installe l’outil s’il manque et le lance contre ton serveur. L’option --dry-run montre les changements avant de les appliquer.
ft serve --model ~/models/Qwen3.6-35B-A3B
curl http://127.0.0.1:1919/v1/models
ft launch claude   # claude / codex / dsh / hermes / openclaw / opencode
Modèles et matériel pris en charge
Le README cite DeepSeek-V4-Flash, Qwen3.6-35B-A3B et GLM-5.2, dans plusieurs formats de quantification (MXFP4, NVFP4, FP8, BF16). Les notes de version ajoutent la lecture de fichiers GGUF et, depuis la v0.2.1, l’entrée d’images pour certaines familles quand un fichier mmproj accompagne le modèle. La v0.2.2 ajoute Ripple-65B Preview.
Côté matériel, le projet annonce une prise en charge native des cartes NVIDIA RTX 30, 40 et 50, des portables aux stations de travail. Pour AMD, la documentation renvoie à un guide d’installation ROCm encore en cours d’écriture.
Où en est FreeToken
Le dépôt a été créé le 20 juillet 2026. Au 9 novembre 2026, il compte 16 872 étoiles, 1 665 copies, 24 contributeurs et 465 tickets et demandes de fusion ouverts. La dernière version, v0.2.2, date du même jour.
Cette version ajoute le décodage spéculatif : le moteur propose plusieurs mots à l’avance puis les vérifie en une passe, sans changer la distribution des réponses avec échantillonnage. Il est désactivé par défaut et occupe de la place en cache. Sur une carte H100 (pas un PC de jeu), avec Qwen3.6-35B-A3B en BF16, le débit passe de 193,1 à 359,6 tokens par seconde avec MTP et à 475,7 avec DFlash 2, selon les notes de version. Le projet ne publie pas, dans ces documents, de mesures sur carte grand public.
Ce qu’il faut savoir avant de se lancer
Le README et la documentation d’installation ne donnent pas de configuration minimale en VRAM ou en mémoire vive : impossible de dire d’après eux quel modèle tient sur quelle machine. La liste des modèles pris en charge se trouve dans la documentation du projet.
Le décodage spéculatif ne gère pas encore le parallélisme de tenseurs au-delà de 1, ni certains types de cache. Un build nocturne existe pour Linux, mais il est écrasé chaque nuit. Le code est sous licence Apache-2.0.
Quelques repères
- MoE (Mixture-of-Experts) : Architecture de modèle de langage composée de nombreux sous-réseaux appelés experts. Pour chaque mot produit, seule une partie d’entre eux est activée, ce qui limite le calcul.
- Inférence : Phase où un modèle déjà entraîné est utilisé pour produire des réponses à partir d’un texte donné.
- VRAM : Mémoire intégrée à la carte graphique. Sa taille limite en général la taille des modèles qu’on peut y charger.
Questions fréquentes
FreeToken est-il gratuit et open source ?
Oui, le code de FreeToken est publié sous licence Apache-2.0. Le projet ne mentionne pas de prix dans son README ni dans sa documentation.
Quelle carte graphique faut-il pour utiliser FreeToken ?
Il faut une carte NVIDIA : le projet annonce une prise en charge native des séries RTX 30, 40 et 50. Il ne donne pas de VRAM minimale, et le support d’AMD est encore en cours de rédaction.
Peut-on connecter Claude Code à FreeToken ?
Oui, FreeToken propose une API compatible Anthropic, et la commande ft launch claude configure et démarre Claude Code contre le serveur local. Codex, OpenCode et OpenClaw sont aussi cités.
FreeToken fonctionne-t-il sous Windows ?
Oui, via l’appli de bureau, proposée pour Windows et Linux. La ligne de commande, elle, est documentée pour Linux x86_64 uniquement.
À retenir
FreeToken sert des modèles MoE volumineux sur un PC NVIDIA en répartissant le travail entre GPU, CPU et mémoire, avec des API compatibles OpenAI et Anthropic. Le projet est récent (créé en juillet 2026, v0.2.2 en novembre) et ne précise pas de configuration minimale.
Sources
- FlashML-orgREADME
- docs/quickstart.mddocumentation officielle
- docs/install.mddocumentation officielle
- GitHubnotes de version