Sommaire11 parties
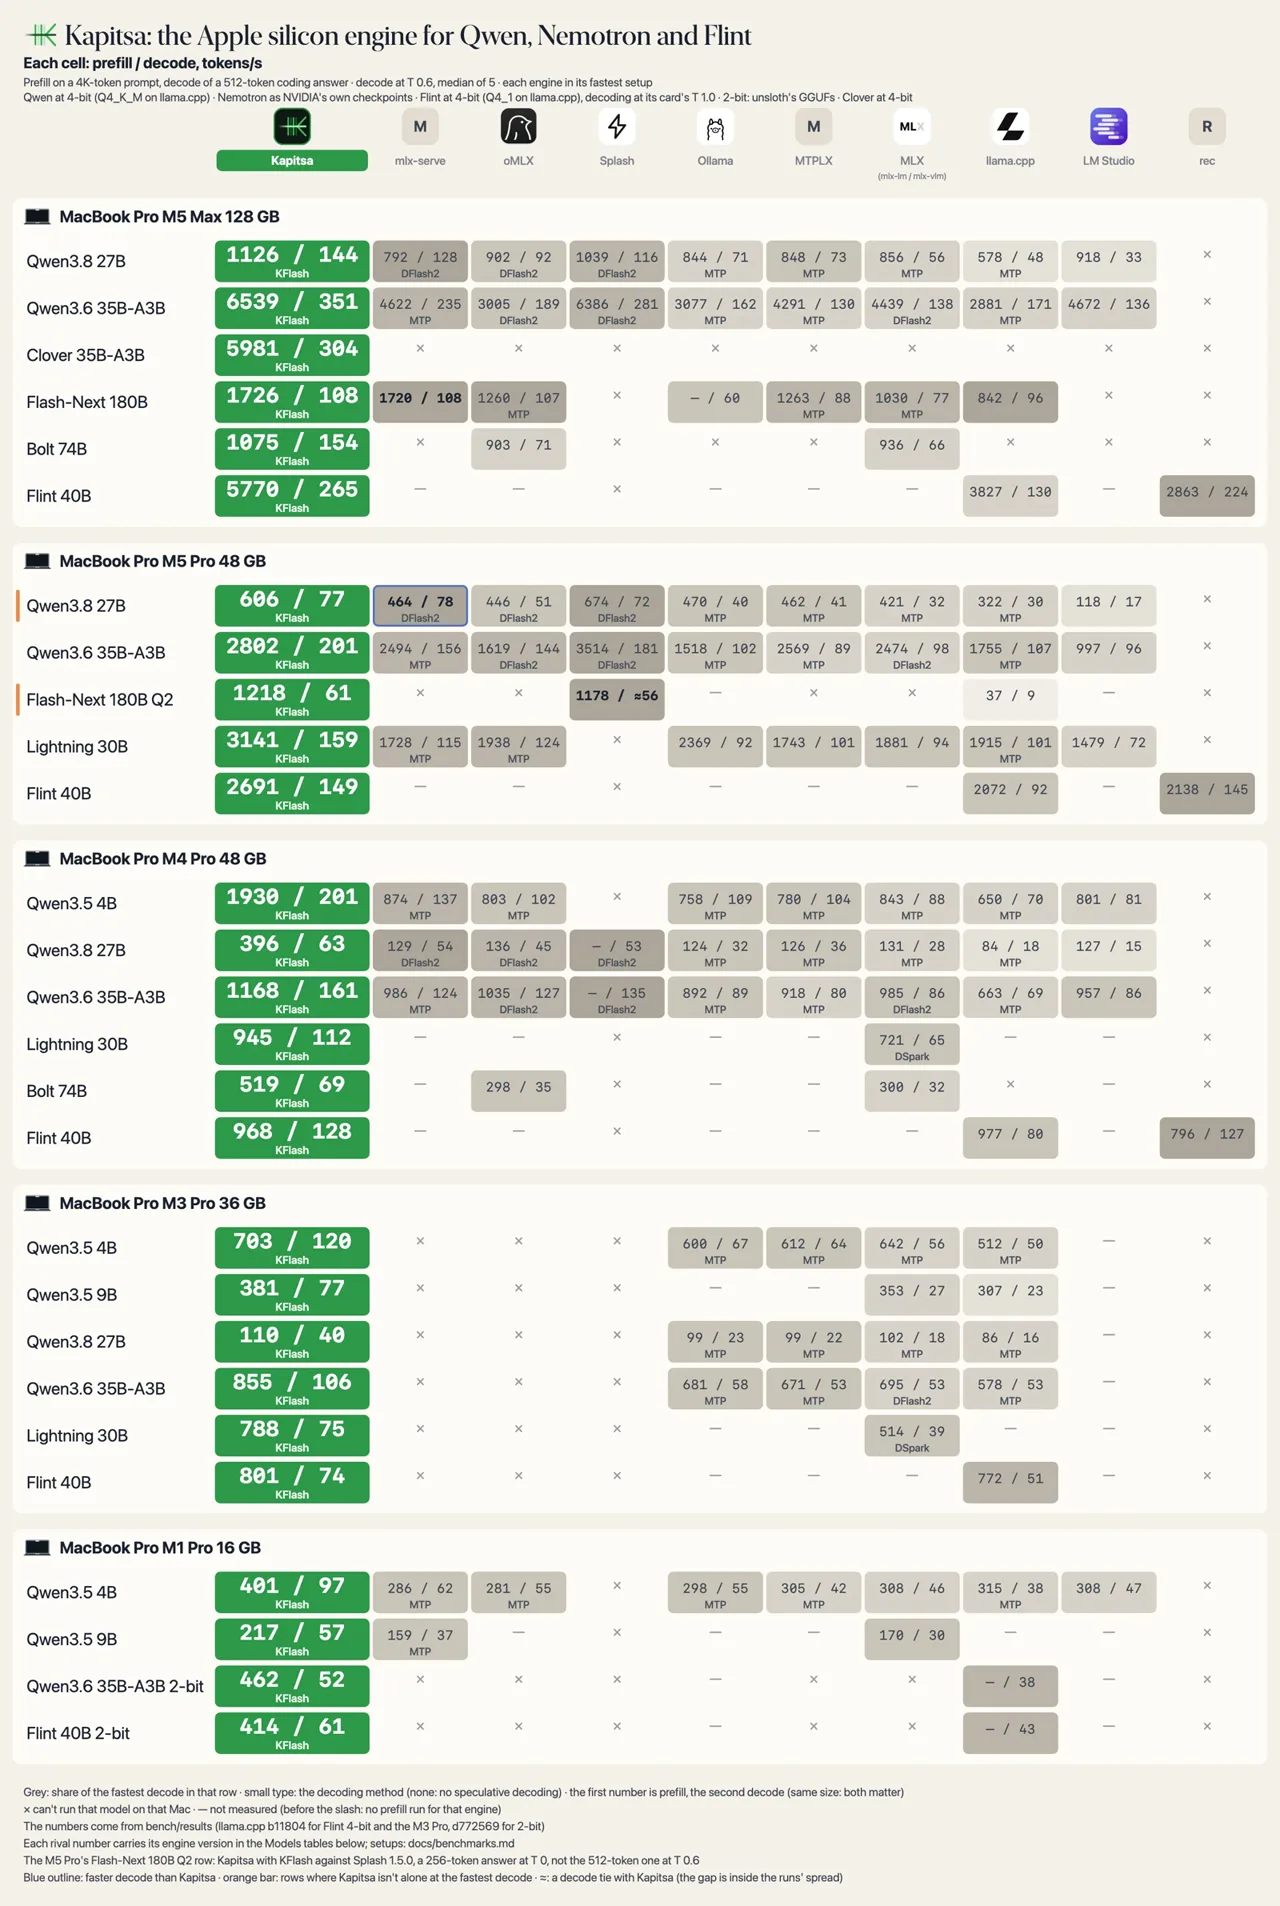
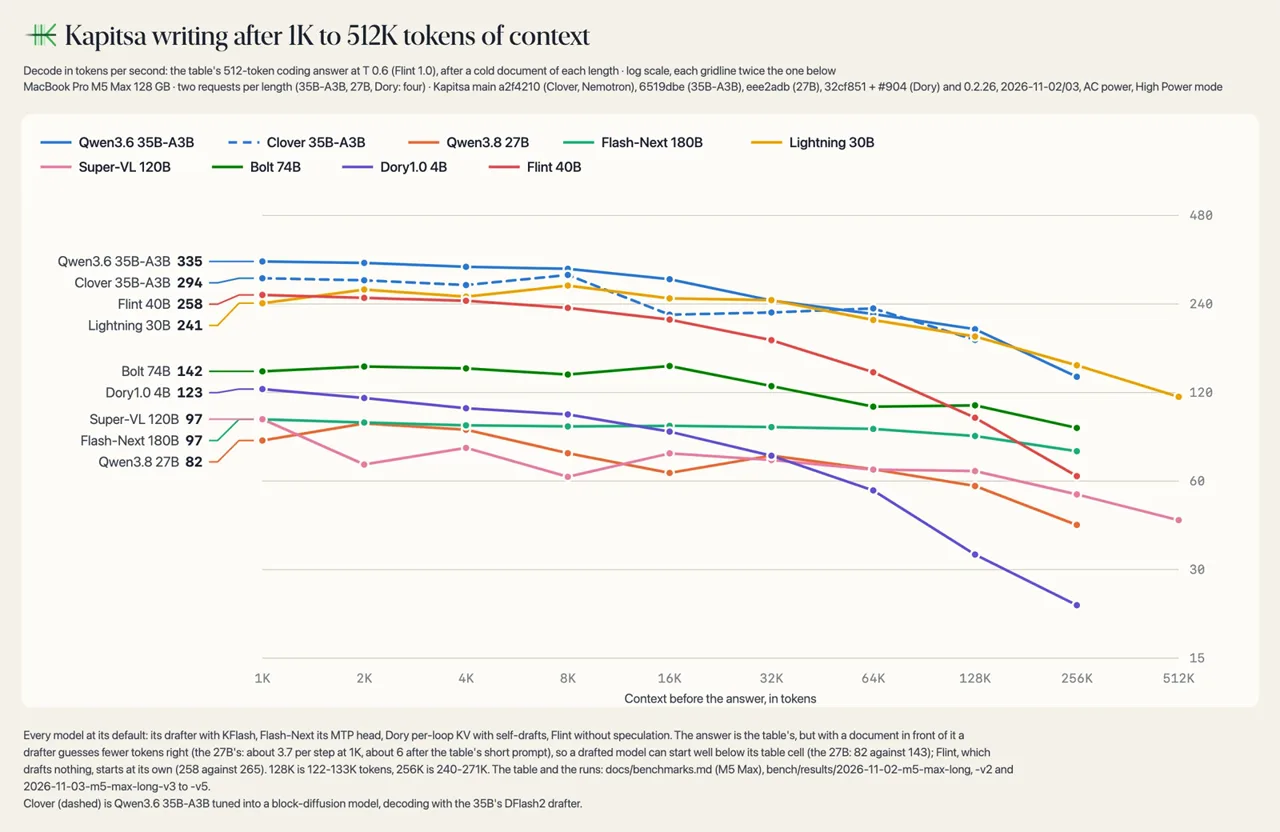
Kapitsa est un moteur d’inférence open source pour les Mac à puce Apple silicon, conçu pour les agents de code. Il fait tourner en local des modèles Qwen, Nemotron et Flint, et lance opencode, Claude Code, Codex ou pi dessus en une commande. Son README annonce 351 tokens par seconde sur Qwen3.6 35B-A3B avec un M5 Max.
En bref
- Moteur d’inférence local pour Mac Apple silicon (M1 ou plus récent, macOS 14 minimum)
- Lance opencode, Claude Code, Codex ou pi sur un modèle local
- Sert des API compatibles OpenAI et Anthropic sur 127.0.0.1:8000
- 351 tok/s sur Qwen3.6 35B-A3B avec un M5 Max, selon le README
- Licence Apache-2.0, Apple silicon uniquement
Kapitsa, un moteur pour agents de code sur Mac
Un moteur d’inférence est le programme qui fait réellement fonctionner un modèle de langage sur ta machine : il charge le modèle et produit le texte. Kapitsa remplit ce rôle pour les Mac équipés d’une puce Apple silicon, avec les modèles Qwen, Nemotron et Flint de Recursive. Le projet est publié par nace-ai sous licence Apache-2.0.
Son but est de faire tourner un agent de code, c’est-à-dire un assistant qui lit et modifie du code, sur un modèle local plutôt que sur un service distant. La commande kapitsa opencode --model 35b démarre l’agent opencode sur un modèle local. Claude Code, Codex et pi se lancent de la même manière.
Comment fonctionne kapitsa
Pour écrire vite, kapitsa s’appuie sur KFlash, une méthode de décodage spéculatif en arbre. Un petit modèle auxiliaire, le drafter, devine plusieurs suites possibles. Le modèle principal vérifie ensuite tout cet arbre d’un seul passage. Le README précise qu’un drafter accompagne chaque modèle qui en propose un.
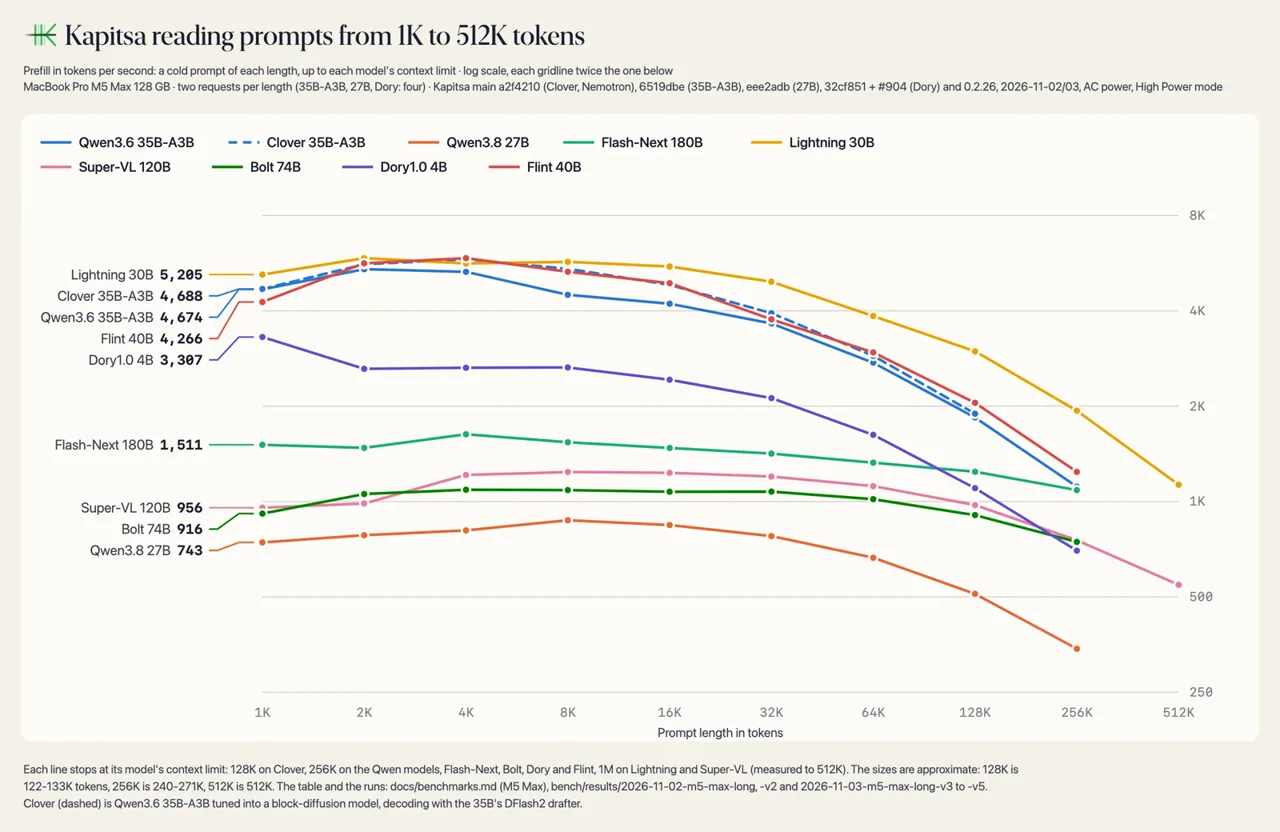
Pour la lecture du prompt (le prefill), le moteur confie une partie du travail au Neural Engine de la puce, en plus du GPU. Selon les notes de la version 0.2.36, cette répartition est active par défaut sur les Mac M1, M2 et M6 ou plus récents.
Ce que kapitsa sait faire
Kapitsa sert des API compatibles OpenAI et Anthropic sur ` avec streaming, appels d’outils et sortie en schéma JSON, ainsi qu’une page de discussion. Tes outils habituels peuvent donc pointer vers ton Mac sans changement.
Le README décrit aussi des fonctions moins courantes : la lecture d’images sur la plupart des modèles du catalogue, plusieurs Macs qui se partagent un modèle, et un cache disque (--disk-cache) qui garde les conversations sur le SSD.
- Un modèle de 180B (Qwen3.8-Flash-Next) sur un Mac de 48 Go, dont les experts sont lus depuis le SSD : 61 tok/s sur un M5 Pro
- Une suite de 16K tokens après un redémarrage qui démarre en 0,16 s au lieu de 17 s grâce au cache disque
- Les commandes
kapitsa claude,kapitsa codex,kapitsa opencodeetkapitsa pi kapitsa-systemone, qui sert Drex 2.0 et Drex Max v1 : une probabilité par option à partir d’un état et de questions
Installer kapitsa et le lancer
Il faut un Mac Apple silicon (M1 ou plus récent) sous macOS 14 Sonoma ou plus. L’installation passe par Homebrew, ou par un script d’installation proposé dans le README.
Ensuite, une commande démarre l’agent de ton choix sur le modèle voulu. Sur un Mac de 16 à 24 Go, le README conseille --model 9b, ou 4b pour les réponses les plus rapides. La commande kapitsa doctor indique quels modèles tiennent sur ton Mac.
brew install nace-ai/tap/kapitsa
curl -fsSL https://raw.githubusercontent.com/nace-ai/kapitsa/main/install.sh | bash
kapitsa opencode --model 35b
Quels modèles faire tourner sur quel Mac
Le catalogue couvre Qwen3.5 (4B, 9B), Qwen3.8-27B, Qwen3.6-35B-A3B, Qwen3.8-Flash-Next 180B, plusieurs modèles Nemotron, Recursive Flint et Clover. Le README indique, pour chaque taille de mémoire de 16 à 128 Go, la variante la plus précise qui démarre. Le Qwen3.6 35B-A3B passe par exemple de 2-bit sur 24 Go à 4-bit sur 32 Go, puis 8-bit sur 64 Go.
Quelques commandes utiles : kapitsa pull 27b télécharge un modèle sans le lancer, kapitsa list liste ceux qui sont présents, et kapitsa import model.gguf réutilise un fichier GGUF de LM Studio, Ollama ou llama.cpp.
Où en est le projet
Le dépôt a été créé le 16 octobre 2026. Au relevé du 18 novembre 2026, il compte 823 étoiles, 113 copies, 67 contributeurs et 44 tickets et demandes de fusion ouverts. Le code est écrit à 56 % en C++, 23 % en Python et 16 % en Metal.
La version 0.2.37 est sortie le 18 novembre 2026. Elle allonge les conversations d’agent acceptées avec le 27B sur un budget de 24 Go (13 274 tokens au lieu de 9 475) et corrige un affichage corrompu de Nemotron 3.5 Super VL sur M5 Ultra. Les chiffres de vitesse du README viennent des mesures du projet lui-même.
Limites à connaître avant de se lancer
Kapitsa ne fonctionne que sur Apple silicon : ni Linux ni Windows. Flint, les quatre Nemotron en texte seul et la version 16gb du 35B ne lisent pas les images.
La feuille de route du README ne mentionne qu’un chantier ouvert, la quantification du cache KV. Les 351 tok/s annoncés valent pour un M5 Max avec 128 Go : les autres Mac vont moins vite, comme le montrent les tableaux du projet, par exemple 201 tok/s pour le même modèle sur un M5 Pro.
Quelques repères
- Inférence : C’est l’étape où un modèle d’IA déjà entraîné est utilisé pour produire une réponse. Elle s’oppose à l’entraînement, qui sert à construire le modèle.
- API : Une API est une interface qui permet à un programme d’en appeler un autre selon des règles communes. Les outils compatibles avec une même API peuvent ainsi être branchés sur différents services.
Questions fréquentes
Kapitsa est-il gratuit et open source ?
Oui, kapitsa est publié sous licence Apache-2.0 sur GitHub par nace-ai. Le README ne mentionne aucun prix.
Kapitsa fonctionne-t-il sur Linux ou Windows ?
Non. Le README précise que kapitsa ne tourne que sur les Mac Apple silicon (M1 ou plus récent) avec macOS 14 Sonoma ou plus.
Peut-on utiliser Claude Code en local avec kapitsa ?
Oui, la commande kapitsa claude lance Claude Code sur un modèle local. Kapitsa démarre de la même façon opencode, Codex et pi.
Quel Mac faut-il pour faire tourner Qwen avec kapitsa ?
Un Mac Apple silicon de 16 Go suffit pour les petits modèles : le README conseille 9b ou 4b sur 16 à 24 Go. Le projet ne donne pas de configuration minimale unique : kapitsa doctor indique les modèles adaptés à ton Mac.
À retenir
Kapitsa fait tourner des modèles Qwen, Nemotron et Flint sur Mac Apple silicon et y branche des agents de code comme Claude Code, Codex ou opencode. Il est gratuit sous licence Apache-2.0, mais réservé à Apple silicon, et ses vitesses annoncées dépendent du Mac utilisé.
Sources
- nace-aiREADME
- kapitsa.vercel.appdocumentation officielle
- GitHubnotes de version