Sommaire11 parties
oMLX est un serveur d’inférence open source qui fait tourner des modèles de langage en local sur un Mac Apple Silicon, piloté depuis la barre des menus de macOS. Son idée centrale : garder le cache de la conversation en mémoire vive puis sur le SSD, pour éviter de tout recalculer quand le contexte change. Tout client compatible OpenAI peut s’y connecter.
En bref
- Un serveur de LLM local pour Mac Apple Silicon, géré depuis la barre des menus
- Un cache KV à deux niveaux : RAM pour le chaud, SSD pour le froid, même après un redémarrage
- Une API compatible OpenAI et Anthropic sur localhost:8000
- Texte, vision, OCR, embeddings et reranking dans un même serveur
- Licence Apache-2.0, macOS 15 ou plus
Qu’est-ce qu’oMLX et quel problème règle-t-il ?
oMLX est un serveur qui sert des modèles de langage (LLM) depuis ton Mac. Son auteur, jundot, explique dans le README qu’aucun serveur essayé ne lui laissait à la fois le confort et le contrôle : il voulait garder ses modèles du quotidien en mémoire, décharger automatiquement les plus lourds à la demande, fixer des limites de contexte, et tout gérer depuis la barre des menus.
Le point de départ est le cache KV, la mémoire intermédiaire du modèle. Selon le site du projet, les outils de codage par agent invalident ce cache des dizaines de fois par session, et d’autres outils comme Ollama ou LM Studio le recalculent alors entièrement. oMLX enregistre les blocs de cache sur le SSD pour les restaurer au lieu de les recalculer.
Comment fonctionne oMLX
Le cache fonctionne sur deux niveaux, avec une gestion par blocs inspirée de vLLM. Les blocs fréquemment utilisés restent en mémoire vive (niveau chaud). Quand elle se remplit, les blocs partent sur le SSD au format safetensors (niveau froid).
À la requête suivante qui partage le même début de texte, ils sont relus depuis le disque plutôt que recalculés, y compris après un redémarrage du serveur. Les requêtes simultanées passent par le BatchGenerator de mlx-lm, avec un nombre maximal configurable. Le site annonce jusqu’à 4,14 fois plus de vitesse de génération avec 8 requêtes en parallèle, sur un M3 Ultra 512 Go avec Qwen3-Coder-Next 8 bits, sans réutilisation du cache.
- Niveau chaud : la RAM, pour les blocs souvent sollicités
- Niveau froid : le SSD, en safetensors, conservé entre les redémarrages
- Compression optionnelle du cache KV en 4 ou 8 bits (Affine4, Affine8), réglable dans les réglages du modèle
Ce que sait faire oMLX
Le serveur charge plusieurs types de modèles en même temps : LLM, modèles de vision, OCR (DeepSeek-OCR, DOTS-OCR, GLM-OCR), embeddings et rerankers. Les modèles de vision acceptent plusieurs images (base64, URL ou fichier) et l’appel d’outils. Certains modèles Qwen acceptent aussi la vidéo, qui demande OpenCV.
La gestion de la mémoire combine plusieurs règles : éviction du modèle le moins récemment utilisé, chargement manuel, épinglage des modèles favoris et délai d’inactivité par modèle. Une limite de mémoire totale, par défaut la RAM du système moins 8 Go, évite de saturer la machine.
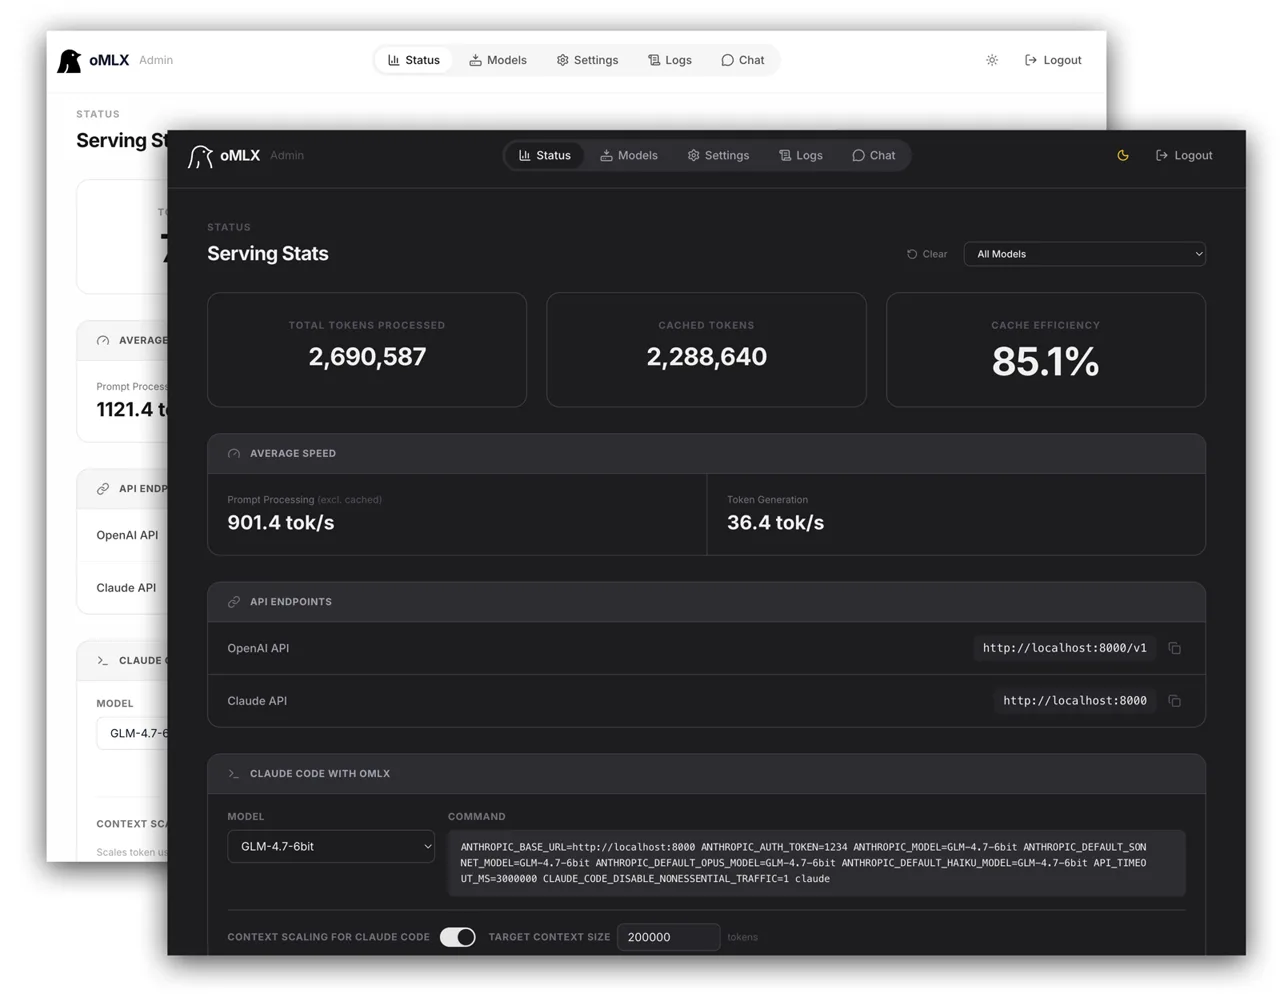
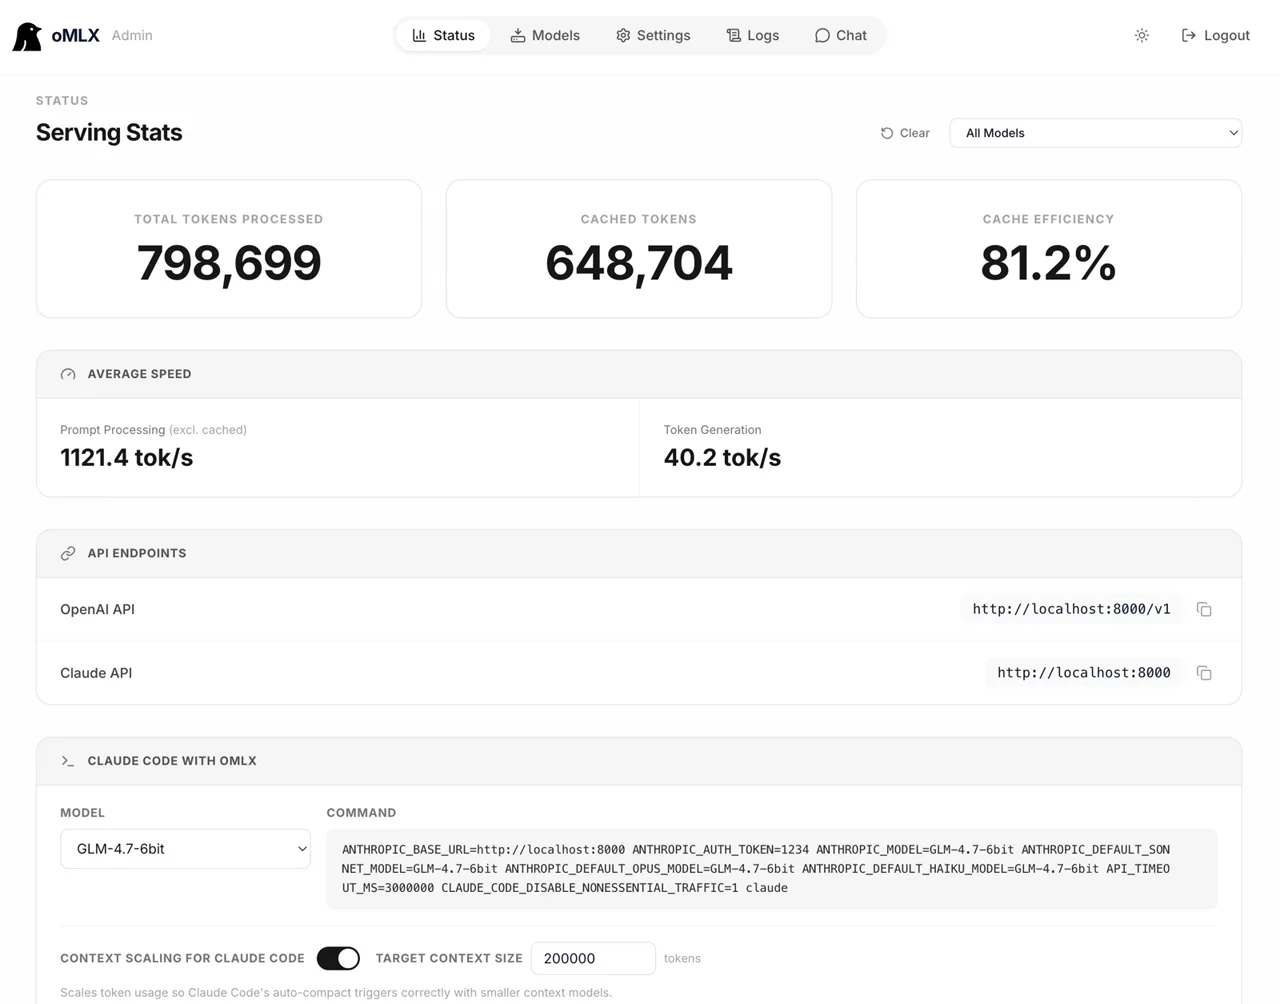
Un tableau de bord web, accessible sur /admin, regroupe suivi en direct, réglages par modèle, chat intégré, benchmark en un clic et téléchargement depuis HuggingFace. Il existe en huit langues, dont le français, et fonctionne hors ligne.
- Réglages par modèle appliqués sans redémarrer, avec alias et profils
- Appel d’outils dans de nombreux formats (Llama, Qwen, Gemma, GLM, MiniMax, Mistral, Kimi…) et prise en charge de MCP
- Intégrations en un clic pour OpenClaw, OpenCode, Codex, Copilot et d’autres
- Inférence répartie entre plusieurs Mac, signalée comme expérimentale et réservée aux builds depuis les sources
Installer oMLX sur un Mac
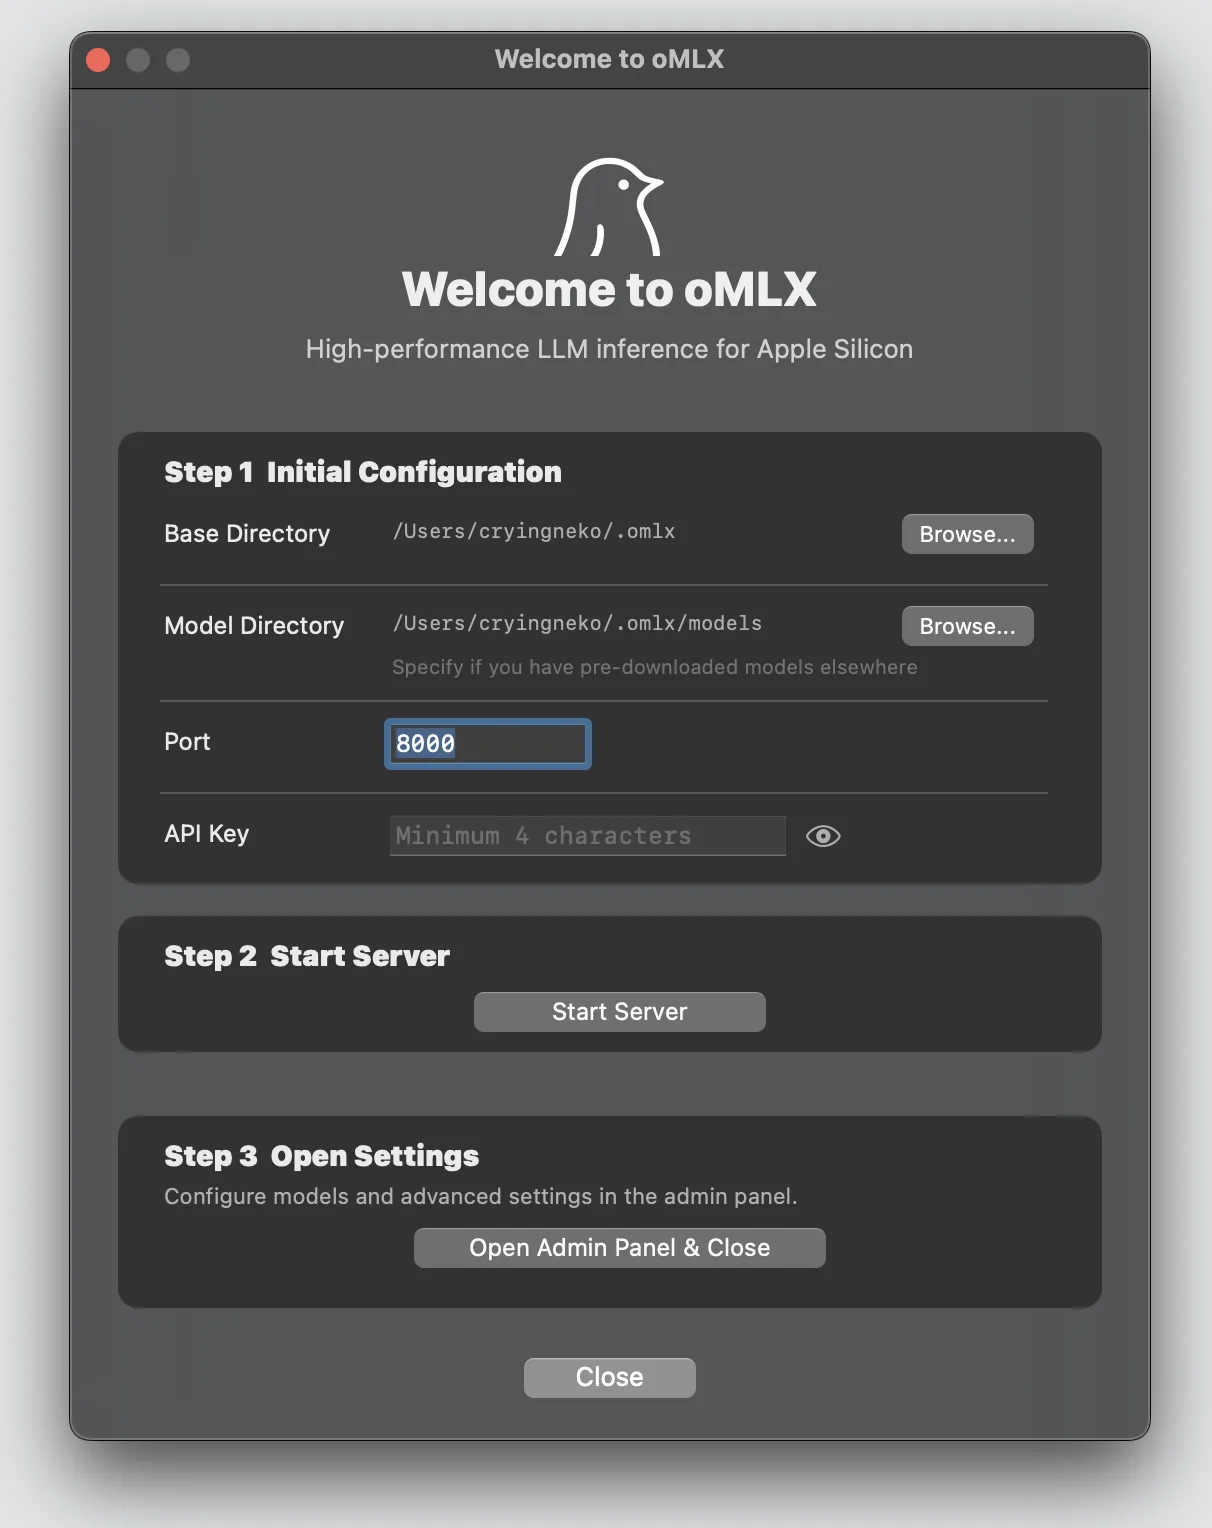
La voie recommandée est l’application macOS : télécharger le fichier .dmg dans les Releases GitHub et le glisser dans Applications. L’application se met à jour d’elle-même et installe un petit outil en ligne de commande. Au premier lancement, un écran d’accueil guide en trois étapes : dossier des modèles, démarrage du serveur, premier téléchargement.
Avec Homebrew, le README donne ces commandes. L’option des noyaux natifs demande Xcode complet, sinon le README indique d’installer sans elle.
Le dossier de modèles est ensuite passé au serveur. Tout client OpenAI se connecte alors à et un chat est disponible sur
brew tap jundot/omlx https://github.com/jundot/omlx
brew install jundot/omlx/omlx --with-custom-kernel
omlx start
omlx serve --model-dir ~/models
Pour qui et pour quels usages
oMLX vise surtout celles et ceux qui veulent héberger leurs modèles sur leur Mac pour du travail réel, en particulier le codage avec des agents. Il propose des points d’accès OpenAI (/v1/chat/completions) et Anthropic (/v1/messages), et le README décrit une optimisation pour Claude Code. Le site cite aussi OpenClaw et Cursor.
Côté modèles, il lit le cache Hugging Face standard et le dossier de LM Studio, d’après le site : pas besoin de retélécharger ce que tu as déjà. Pour l’exposer au réseau, une clé d’API est obligatoire : oMLX refuse de démarrer sur une adresse autre que locale sans clé principale.
Où en est le projet oMLX
Au 26 octobre 2026, le dépôt compte 23 074 étoiles, 2 065 copies et 344 contributeurs, avec 589 tickets et demandes de fusion ouverts. Il a été créé le 13 février 2026 et son code a été modifié pour la dernière fois le 26 octobre 2026. Il est écrit à 81 % en Python et à 7 % en Swift.
La dernière version publiée, v0.7.3.dev2 (25 octobre 2026), est une version de développement : elle corrige un hotfix lié à MiniMax M3.1 et ajoute des accélérations pour les Mac M1 et M5. Pour une version stable, les notes renvoient à la 0.7.2, sortie le 21 octobre 2026.
Prérequis et limites à connaître
oMLX demande macOS 15 (Sequoia) ou plus, Python 3.11 à 3.13 pour l’installation depuis les sources, et un Mac Apple Silicon (M1 à M5). Selon le site, 16 Go de RAM sont un minimum et 64 Go ou plus sont recommandés pour de gros modèles.
Pour certaines familles (GLM-5.2, MiniMax M3, Qwen3.5), les noyaux natifs sont nécessaires. Sans eux, le README prévient d’un retour silencieux à des chemins bien plus lents. Ils exigent Xcode complet, ou l’application officielle qui les embarque. Le projet est sous licence Apache-2.0.
Quelques repères
- Cache KV : Mémoire où un modèle de langage garde les calculs déjà faits sur le texte de la conversation. Elle évite de relire tout le contexte à chaque nouvelle réponse.
- Inférence : Étape où un modèle déjà entraîné produit une réponse à partir d’une question. Un serveur d’inférence expose cette capacité à d’autres programmes.
- Modèle de vision-langage : Modèle d’IA capable de traiter à la fois du texte et des images. On peut lui poser des questions sur une photo ou un document.
Questions fréquentes
oMLX fonctionne-t-il sur un Mac Intel ?
Non. oMLX demande un Mac Apple Silicon (M1 à M5) et macOS 15 ou plus. Le README ne mentionne aucune prise en charge des Mac Intel.
oMLX est-il compatible avec l’API d’OpenAI ?
Oui. Tout client compatible OpenAI se connecte à oMLX propose aussi un point d’accès Anthropic (/v1/messages).
Quelle configuration faut-il pour utiliser oMLX ?
Il faut un Mac Apple Silicon sous macOS 15 ou plus. Le site indique 16 Go de RAM au minimum et recommande 64 Go ou plus pour de gros modèles.
oMLX est-il gratuit et open source ?
Oui, oMLX est publié sous licence Apache-2.0. Le README et le site ne mentionnent aucun prix.
À retenir
oMLX regroupe sur un Mac Apple Silicon un serveur de modèles, un cache KV à deux niveaux (RAM et SSD) et une API compatible OpenAI, pilotés depuis la barre des menus. Il demande macOS 15 ou plus, et la version la plus récente est une version de développement, la 0.7.2 étant citée comme stable.