Sommaire11 parties
XERJ est un moteur de recherche local, open source, livré en un seul binaire Rust, qui indexe un dossier de code, de documents ou de logs pour qu’un agent IA y retrouve le bon passage. Au lieu de lire des fichiers entiers, l’agent interroge l’index, ce qui réduit les tokens consommés. Il parle l’API d’Elasticsearch et se branche à Claude Code, Cursor ou tout client MCP.
En bref
- Un binaire Rust, sans JVM, qui indexe code, PDF, logs, CSV et bien d’autres formats.
- Dans l’étude du projet : 2,7 fois moins de tokens de sortie qu’un agent qui utilise grep, avec 16 tâches résolues sur 16.
- Recherche BM25, vectorielle ou hybride, via une API compatible Elasticsearch.
- Mémoire pour agent intégrée, et serveur MCP exposant dix-sept outils.
- Licence Apache-2.0 ; le mode de démarrage –insecure est réservé à une machine de développement.
Qu’est-ce que XERJ et quel problème règle-t-il ?
Un agent de code qui explore un projet avec grep sait seulement où regarder. Il doit ensuite charger les fichiers dans son contexte pour les lire, et chaque lecture consomme des tokens. Face à une bibliothèque qu’il ne connaît pas, il peut aussi inventer des noms de méthodes, échouer à compiler et recommencer.
XERJ propose une autre approche : indexer les sources une fois, puis laisser l’agent poser des questions à l’index. Il reçoit le passage utile, avec son fichier et sa ligne, plutôt qu’un fichier entier. Le projet l’appelle « reference coding » : cloner les dépôts open source les plus proches de ce que tu construis, les indexer, puis chercher comment ils ont résolu le problème avant d’écrire du code.
Comment fonctionne XERJ
Tout passe par un seul binaire. Il démarre un nœud qui écoute en local et expose l’API d’Elasticsearch : les clients, tableaux de bord et outils existants s’y connectent sans changement. Le projet précise qu’il s’agit d’un pont de migration plutôt que d’un clone, le moteur étant conçu pour les agents.
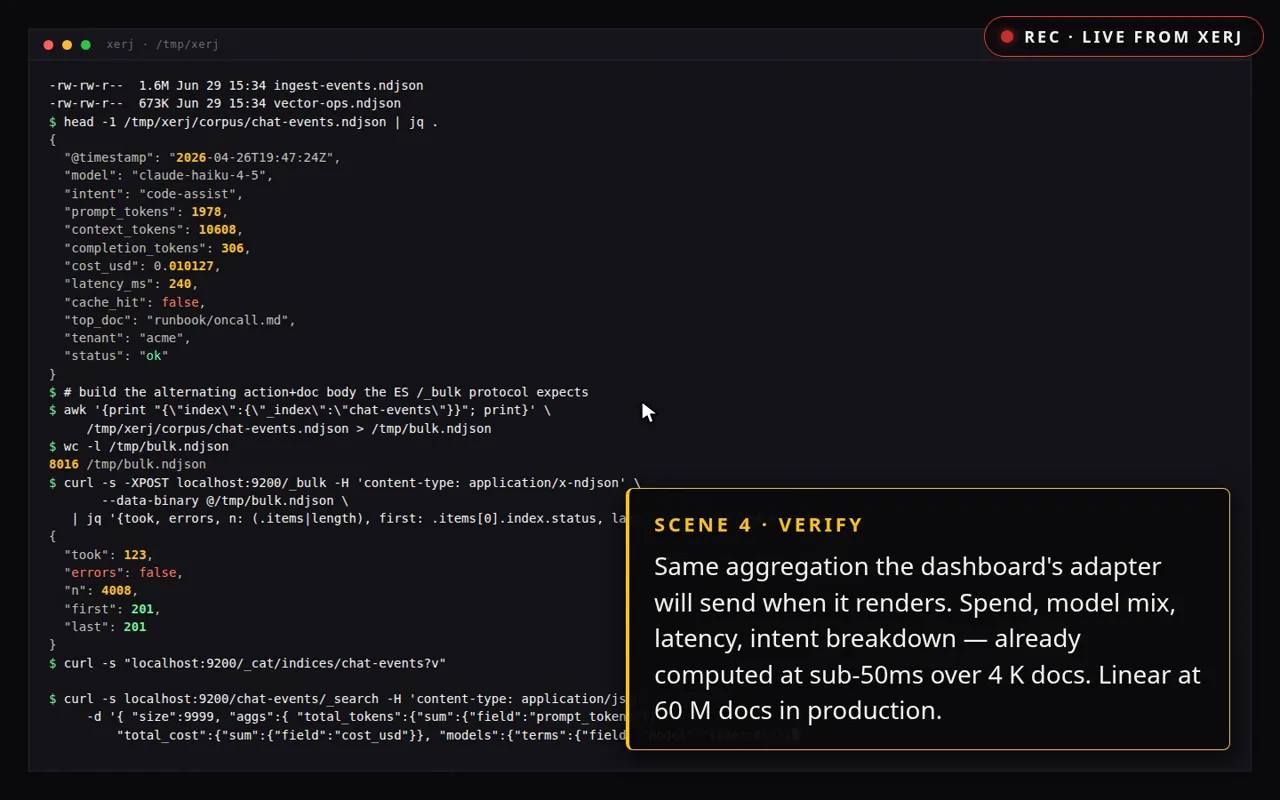
La commande xerj autoindex parcourt un dossier et identifie chaque fichier par son contenu, pas par son extension. Elle déduit les types de champs, crée un index par jeu de données trouvé et range les fichiers inutilisables à part au lieu de s’arrêter. Le code source passe par tree-sitter, un analyseur syntaxique : les symboles et leurs numéros de ligne sont indexés, pas seulement du texte brut.
Pour le code, xerj search pose une question en langage courant et renvoie la fonction, son fichier et sa ligne. xerj def répond à une question plus précise : où est défini ce nom, et avec quelle signature. Sur un banc de quatre-vingts tâches entre fichiers, la documentation du projet annonce le bon fichier en tête dans 94 % des cas, contre 38 % pour une recherche ordinaire dans le corps du texte.
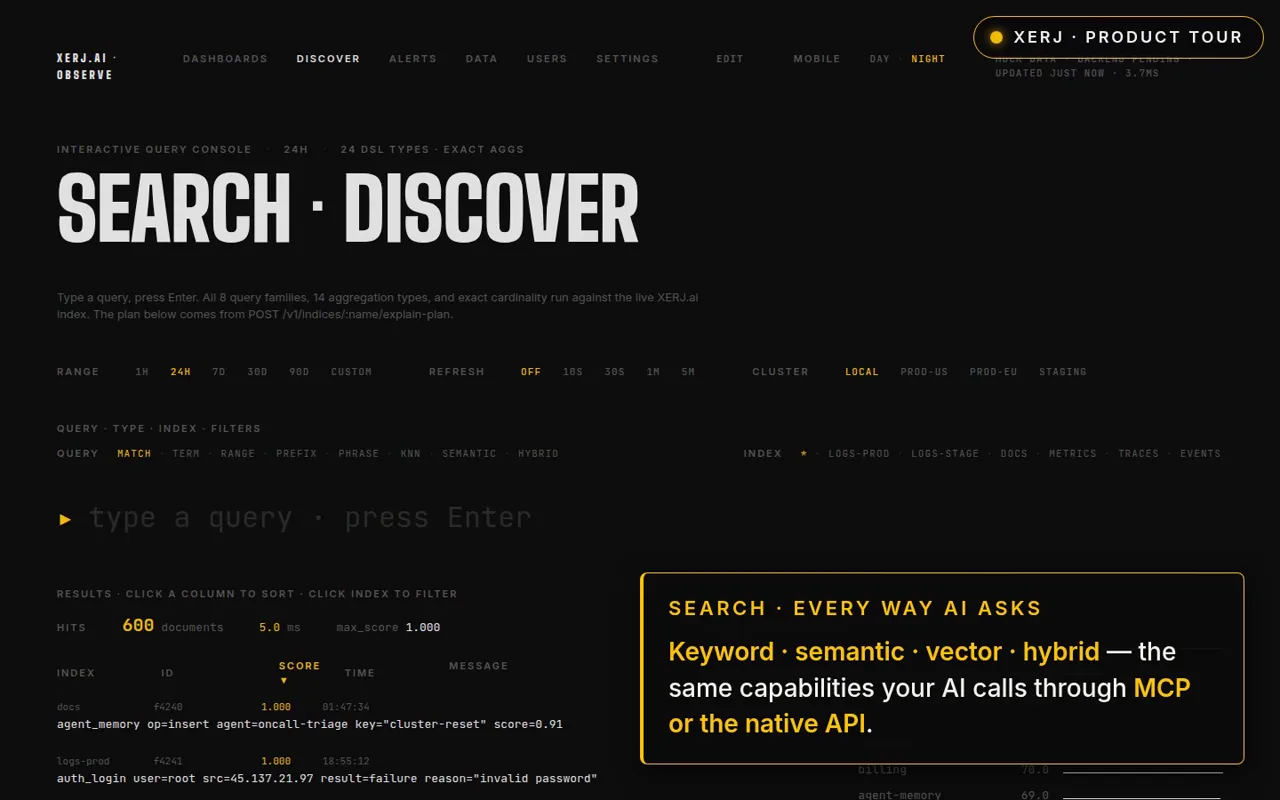
Chercher dans le code, les PDF et les logs sans configuration
L’indexation ne demande ni schéma ni pipeline. Le README cite notamment CSV, JSON, JSONL, XML, YAML, SQLite, PDF, DOCX, PowerPoint, Excel, EPUB, notebooks Jupyter, HTML, courriers électroniques et formats de logs courants. Les projets Unity ont un traitement dédié.
Une fois indexé, le contenu se cherche en texte intégral (BM25), en vectoriel (kNN) ou en hybride, avec la même syntaxe qu’Elasticsearch. Les agrégations habituelles, comme les comptages par statut, fonctionnent aussi, ce qui sert à analyser des logs.
- Réutiliser des dépôts proches de son problème avant d’écrire du code.
- Poser des questions à une base de code et obtenir le passage avec
file:line. - Auditer un arbre de fichiers à la recherche de motifs dangereux ou de secrets.
- Analyser des logs de formats mélangés.
- Donner à un agent une mémoire à long terme.
Installer XERJ et indexer un premier dossier
L’installation tient en une ligne. Le programme est prébuilt pour Linux, macOS et Windows, en x86-64 et arm64, sans JVM ni dépendance. Sous Windows, une commande PowerShell existe, et une compilation depuis les sources reste possible.
Ensuite, on démarre le nœud, puis on indexe un dossier. xerj init branche XERJ à Claude Code ou Cursor. Garde le dossier de données en dehors du dossier à indexer, sinon le nœud indexe son propre stockage.
curl -fsSL https://xerj.org/get | sh
xerj --insecure --data-dir ~/xerj-data &
xerj init
xerj autoindex ~/my-project
Mémoire d’agent et connexion MCP
XERJ propose une API de mémoire sous /_memory/{namespace}. Un agent y stocke ce qu’il apprend et le retrouve à la session suivante par le sens, par mot-clé ou par vecteur. Chaque espace de noms est isolé physiquement, donc un agent ne lit pas les souvenirs d’un autre.
Pour les assistants qui n’exécutent pas de commandes shell, xerj mcp lance un serveur MCP (Model Context Protocol) en entrée-sortie standard. Il relaie les requêtes vers le nœud, qu’il ne démarre pas lui-même. Dix-sept outils sont exposés : recherche, recherche sémantique, vectorielle et hybride, mémoire, et une couche de liens entre éléments.
Les résultats mesurés, et leurs limites
Dans l’étude du projet (8 tâches, 4 langages, 16 exécutions par groupe), l’agent qui interroge XERJ résout 16 tâches sur 16, comme l’agent guidé par grep, avec 2,7 fois moins de tokens de sortie. L’agent qui travaille de mémoire seule en résout 11 sur 16. Sur une bibliothèque Rust inconnue du modèle, la recherche donne 9 réussites sur 9 contre aucune de mémoire. Ces mesures viennent du projet lui-même.
Le README en fixe la portée : l’intérêt dépend de ce que le modèle ne connaît pas déjà. Il gagne sur du code privé, interne, de niche ou postérieur à l’entraînement, et il est neutre, voire défavorable, sur les bibliothèques publiques très répandues. Le projet publie aussi un examen d’indexation où l’agent appuyé sur XERJ obtient neuf bonnes réponses et une partielle, contre dix sur dix pour une base grep et Python : un match nul en exactitude, dit-il.
Où en est XERJ, et ce qu’il faut savoir avant de se lancer
D’après les chiffres relevés sur GitHub le 23 octobre 2026, le dépôt, créé le 30 juin 2026, compte 13 211 étoiles, 950 copies, 73 contributeurs et 65 tickets ou demandes de fusion ouverts. La dernière version, publiée le 22 octobre 2026, est numérotée comme une version candidate (rc). Le projet publie aussi des paquets de corpus pré-indexés et signés, le Corpus Hub, récupérables avec xerj hub pull.
Plusieurs points de vigilance. Le mode --insecure coupe TLS et l’authentification : tout appelant qui atteint le port devient superutilisateur, ce qui convient à une machine de développement seulement. L’embedder par défaut est lexical (hachage de vocabulaire), hors ligne, et non neuronal ; le mode neuronal est optionnel et télécharge environ 90 Mo. Le reclassement optionnel avec le service Jev envoie le texte des résultats aux serveurs de TypeSafe AI et reste désactivé tant qu’aucune clé n’est fournie. Le code est sous licence Apache-2.0.
Quelques repères
- Token : Unité de texte, souvent un fragment de mot, que traite un modèle de langage. Les offres d’IA facturent généralement selon le nombre de tokens lus et produits.
- MCP : Protocole qui permet à un assistant IA d’appeler des outils externes de façon standardisée. Un serveur MCP expose ces outils à tout client compatible.
Questions fréquentes
XERJ est-il gratuit et open source ?
Oui. XERJ est publié sous licence Apache-2.0. Le README demande seulement, en retour, un court rapport d’usage sous forme de commit ou de demande de fusion.
XERJ peut-il remplacer grep pour chercher dans le code ?
Pour un agent, oui dans certains cas : XERJ renvoie le passage utile avec son fichier et sa ligne, et xerj def donne la définition d’un symbole. Le projet précise que le gain est net sur du code que le modèle ne connaît pas, et neutre voire défavorable sur les bibliothèques publiques très répandues.
XERJ est-il une alternative à Elasticsearch ?
Pas exactement : XERJ parle l’API d’Elasticsearch, donc les clients existants s’y connectent sans changement, mais le projet le décrit comme un pont de migration plutôt qu’un clone. C’est un binaire unique sans JVM, conçu pour les agents.
Comment indexer un dossier automatiquement avec XERJ ?
Lance le nœud avec xerj --insecure --data-dir ~/xerj-data &, puis xerj autoindex ~/my-project. XERJ détecte les formats par le contenu et crée un index par jeu de données, sans schéma à écrire.
À retenir
XERJ indexe en local un dossier de code, de documents ou de logs pour qu’un agent IA en tire le bon passage plutôt que des fichiers entiers. Dans l’étude du projet, cela réduit de 2,7 fois les tokens de sortie par rapport à grep, surtout sur du code que le modèle ne connaît pas.