Sommaire11 parties
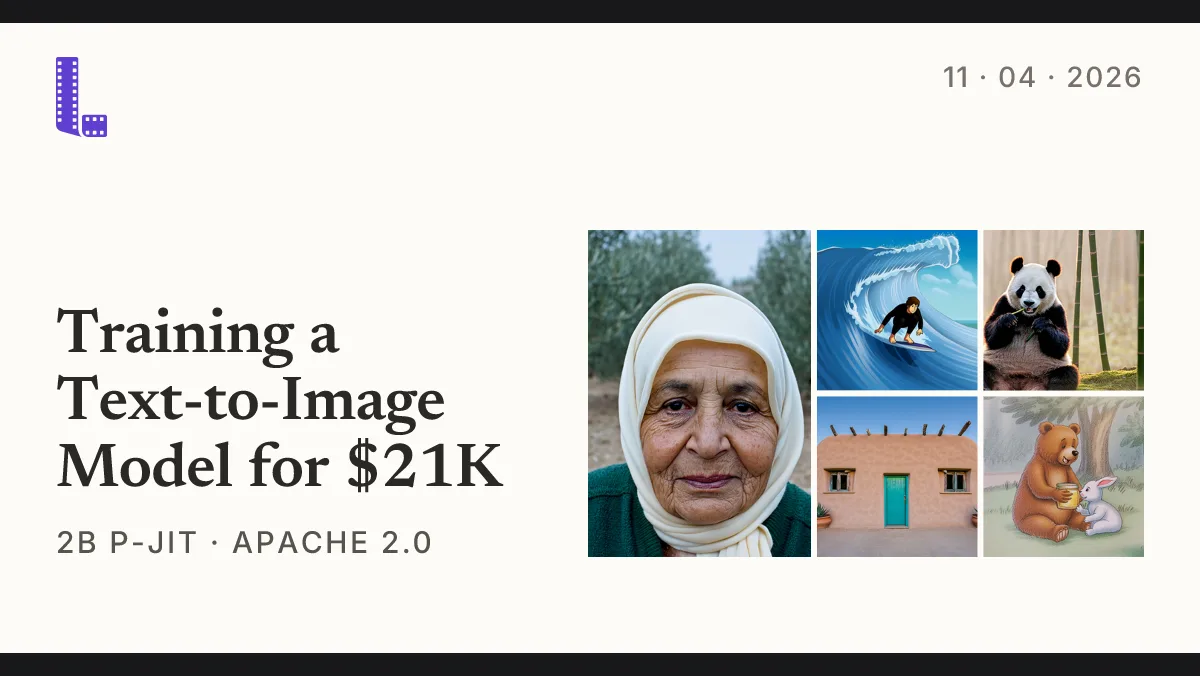
Pyramid-JiT (P-JiT) est un modèle de génération d’images à partir de texte publié par Linum, un laboratoire de deux personnes. Il travaille directement sur les pixels, sans le module de compression habituel, et son entraînement complet a coûté 21 038 dollars de calcul. Ses poids sont sous licence Apache 2.0 et Linum le présente comme une étape vers son prochain modèle vidéo.
En bref
- Modèle texte-image de 2,18 milliards de paramètres à l’échantillonnage, poids en Apache 2.0
- Architecture dans l’espace des pixels, sans VAE
- Entraîné sur 64 H100 jusqu’à la résolution 1024², pour 21 038 dollars de calcul
- Ne sait pas écrire de texte dans les images et peine sur les foules ou les corps entiers
Pyramid-JiT, le modèle d’images de Linum
Linum se décrit comme un laboratoire de deux personnes qui entraîne ses propres modèles de vidéo générative entièrement depuis zéro. Son ambition est de proposer des outils créatifs qui rendent l’animation plus accessible. Pyramid-JiT est un modèle d’images publié en version expérimentale, présenté comme une preuve de concept avant le prochain modèle vidéo.
Linum rappelle qu’un modèle vidéo commence presque toujours comme un modèle d’images : il faut apprendre les noms (personnes, lieux, objets) avant les verbes (actions, mouvements). Le laboratoire dit avoir été surpris par la qualité des résultats compte tenu de la taille du modèle, d’où sa décision de le partager.
Comment fonctionne Pyramid-JiT sans VAE
Pour la vidéo, Linum identifie un goulot d’étranglement : l’attention, dont le coût croît avec le carré du nombre d’éléments à traiter. Compresser davantage l’image réduit ce nombre et donc le coût de l’entraînement comme de la génération. D’ordinaire, cette compression est confiée à un VAE, un modèle séparé, mais Linum estime que les VAE atteignent un plafond empirique et qu’améliorer leur reconstruction peut dégrader les images produites ensuite.
Pyramid-JiT supprime donc le VAE et travaille dans l’espace des pixels : le modèle de diffusion apprend lui-même la représentation dont il a besoin. Selon Linum, il converge en 11 fois moins d’échantillons que son précédent modèle, Linum v2, avec une réduction de jetons (les unités traitées par le modèle) quatre fois plus agressive. Une image de 512² y occupe autant de jetons qu’une image de 256² dans Linum v2.
Deux ingrédients sont cités : un calendrier de bruit adapté aux modèles en pixels, qui aide à apprendre les détails fins, et des sorties intermédiaires le long du réseau. Comme chaque bloc prédit une version de l’image finale, ces sorties à basse résolution renforcent le signal d’apprentissage dans les premières couches.
L’architecture de Pyramid-JiT en détail
Le texte et l’image passent chacun par deux blocs de raffinage, puis fusionnent dans un flux unique de 22 blocs identiques. Le texte est lu par un modèle Qwen3.5-4B figé, dont Linum prélève trois couches. L’image est découpée en patchs de 32×32 pixels, soit 3 072 valeurs, projetés dans un espace de 1024 dimensions.
Le modèle compte 2,18 milliards de paramètres à l’échantillonnage. Des têtes supplémentaires, utilisées seulement pendant l’entraînement, portent le total à environ 2,42 milliards.
- Une tête alignée sur DINOv3-L au bloc 5 (PixelREPA)
- Deux têtes de lecture après les blocs 10 et 16, qui prédisent l’image à un quart puis à la moitié de la résolution
- Des pertes perceptuelles (LPIPS et P-DINO) sur l’image en pleine résolution
- Un conditionnement par le pas de temps via AdaLN à faible rang
Entraîner un modèle d’images pour 21 038 dollars
L’entraînement s’est déroulé en deux temps sur 64 GPU H100 : 610 millions d’échantillons en 512², puis 50 millions en 1024². Linum chiffre le pré-entraînement à 20 348 dollars et le post-entraînement à 690 dollars, soit 21 038 dollars au total. Le calcul est valorisé à 2,50 dollars par heure de H100, redémarrages inclus.
Pendant les 80 premiers millions d’échantillons, le bruit se concentre sur les niveaux élevés pour apprendre la structure de base. La distribution s’élargit ensuite pour affiner les détails. Au passage à 1024², l’optimiseur repart à zéro à partir des poids moyennés du stade 512².
Le post-entraînement, une discipline encore jeune
Pour le post-entraînement, Linum a utilisé une variante de Finite Difference Flow Optimization (FDFO), avec JEV-Image et des juges humains. Le laboratoire juge cette discipline très récente pour la diffusion : DPO tend à surajuster certains choix esthétiques, et il attribue la difficulté à l’absence d’estimations de vraisemblance solides.
Linum annonce détailler sa méthode complète dans les semaines à venir.
Limites de Pyramid-JiT
Le modèle n’a vu aucune image de texte rendu (infographies, PDF, pages de livres, diapositives). Il ne peut donc pas écrire de texte ni produire d’affiches. Linum a retiré ces données de son jeu d’entraînement parce qu’elles ne servent pas son objectif d’outils d’animation.
S’agissant d’un petit modèle, Linum signale aussi des faiblesses : corps entiers, scènes avec de nombreux éléments (six voitures, foules), interactions entre personnes et connaissance du monde. Il réussit parfois ces images. Selon Linum, un modèle plus grand, par exemple de 7 milliards de paramètres, et davantage de post-entraînement atténueraient probablement ces défauts.
Licence et disponibilité de Pyramid-JiT
Les poids sont publiés sous licence Apache 2.0. Linum précise que la fiche du modèle sur Hugging Face et le dépôt GitHub ont été rédigés automatiquement par Claude Opus 5.5, à partir de son dépôt interne d’expériences. Le laboratoire ajoute avoir écrit lui-même le texte de la page.
Linum ne donne pas de configuration minimale pour faire tourner le modèle chez soi.
Quelques repères
- VAE : Un autoencodeur variationnel est un modèle qui compresse une image en une représentation plus petite, puis la reconstruit. Il sert souvent d’étape préalable aux modèles de génération d’images.
- Modèle de diffusion : Un modèle de diffusion génère une image en partant de bruit aléatoire qu’il nettoie progressivement, étape après étape, jusqu’à obtenir une image cohérente.
- Poids d’un modèle : Les poids sont les valeurs numériques apprises pendant l’entraînement. Les publier permet à d’autres personnes de faire fonctionner le modèle sur leur propre machine.
Questions fréquentes
Pyramid-JiT est-il open source ?
Oui, les poids de Pyramid-JiT sont publiés sous licence Apache 2.0. Linum propose aussi un dépôt GitHub et une fiche de modèle sur Hugging Face.
Combien a coûté l’entraînement de Pyramid-JiT ?
Environ 21 038 dollars de calcul, selon Linum : 20 348 dollars de pré-entraînement et 690 dollars de post-entraînement, avec des H100 comptées 2,50 dollars de l’heure.
Pyramid-JiT peut-il écrire du texte dans une image ?
Non. Le modèle n’a pas été entraîné avec des images de texte rendu, donc il ne peut ni écrire de texte ni générer d’affiches.
Pourquoi Pyramid-JiT n’utilise-t-il pas de VAE ?
Parce que Linum estime que les VAE plafonnent en compression et que les améliorer peut dégrader les générations. Pyramid-JiT travaille donc directement sur les pixels et apprend sa propre représentation.
À retenir
Pyramid-JiT est un modèle texte-image de 2,18 milliards de paramètres, sans VAE, entraîné pour 21 038 dollars de calcul et publié en Apache 2.0. Linum le décrit comme expérimental : il écrit mal le texte et reste limité sur les foules, les corps entiers et les interactions.
Sources
- linum.aipage citée sur Hacker News