Sommaire11 parties
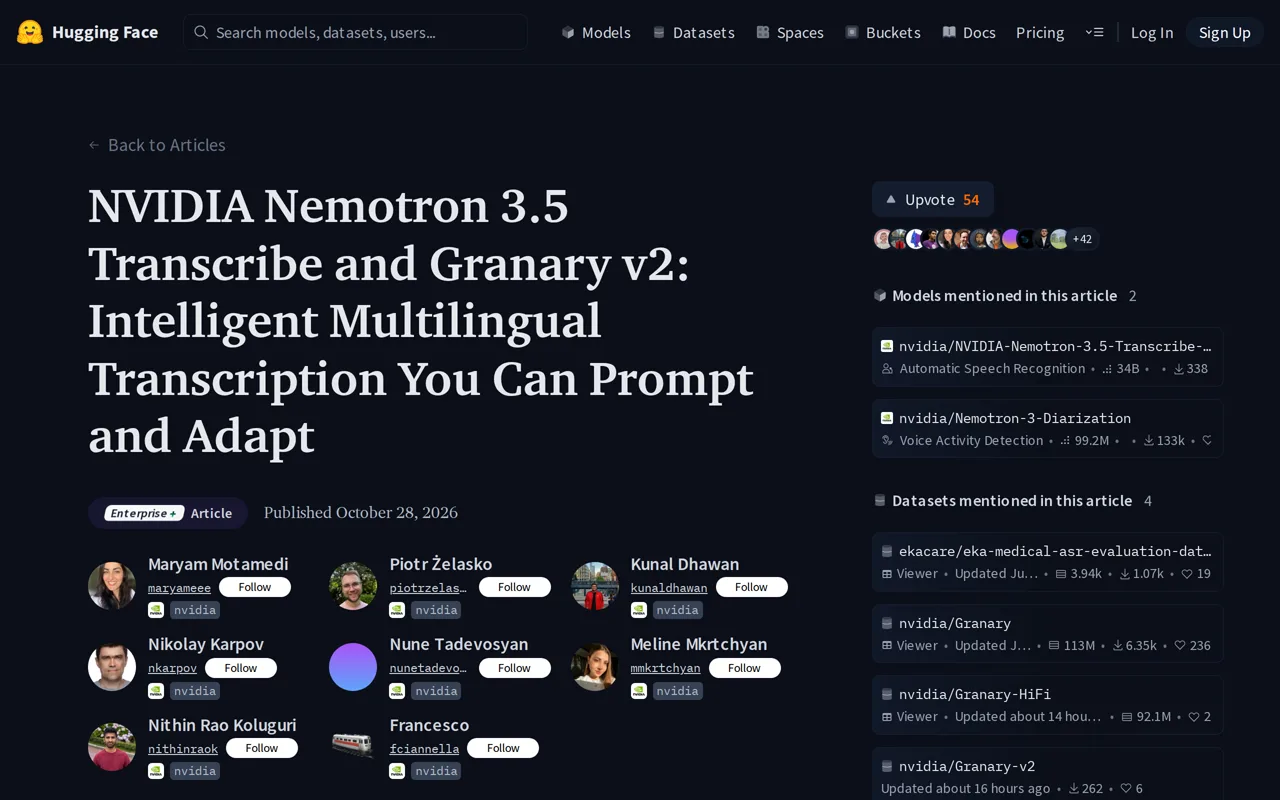
Nemotron 3.5 Transcribe est un modèle ouvert de NVIDIA qui transforme des enregistrements audio en texte, en indiquant aussi qui parle, en traduisant ou en répondant à des questions sur le contenu. Il se pilote avec des instructions en langage naturel et tient sur un seul GPU. NVIDIA l’a publié le 28 octobre 2026, avec un jeu de données ouvert, Granary v2, et des outils pour l’adapter à un métier précis.
En bref
- Un seul modèle ouvert : transcription en 40 langues, traduction de 31 d’entre elles vers ou depuis l’anglais.
- Identification des locuteurs dans 13 langues, enregistrements d’une heure et jusqu’à 8 voix.
- Fonctionne sur un seul GPU NVIDIA, du DGX Spark aux puces Blackwell de data center.
- Granary v2 et des recettes d’affinage permettent de l’adapter à un domaine, par exemple médical.
- Limite : il traite des enregistrements, pas du direct.
Ce que fait Nemotron 3.5 Transcribe
Une transcription classique restitue les mots prononcés, mais laisse souvent de côté qui a parlé, comment traduire ou comment écrire un terme spécialisé. Nemotron 3.5 Transcribe réunit dans un même modèle la transcription, l’attribution des locuteurs (la diarisation), la traduction et les questions-réponses sur un enregistrement.
Selon l’annonce publiée sur Hugging Face, le modèle transcrit 40 langues, en traduit 31 vers ou depuis l’anglais et attribue les paroles aux locuteurs dans 13 langues. Il accepte des enregistrements allant jusqu’à une heure et distingue jusqu’à huit personnes. Les horodatages mot à mot sont aussi pris en charge.
Piloter la transcription avec des phrases
Le modèle est « promptable » : on lui donne une consigne en langage courant, et la même réunion enregistrée peut produire des résultats différents. La fiche du modèle fournit des préréglages recommandés, un guide complet des consignes et un tableau des tâches par langue.
Pour les termes inconnus, l’annonce conseille d’essayer d’abord le contexte avant tout entraînement. On peut par exemple fournir une liste de termes médicaux possibles, en précisant de ne les utiliser que si l’audio les confirme.
- « Transcribe this recording and label each speaker » : transcription avec étiquette par locuteur.
- « Translate this audio into English » : traduction vers l’anglais.
- « What decisions were made in this meeting? » : question sur le contenu de la réunion.
Résultats sur les classements publics
Sur l’Open ASR Leaderboard de Hugging Face, Nemotron 3.5 Transcribe arrive premier des modèles à poids ouverts en anglais, avec un taux d’erreur de mots moyen de 5,33 %. Les deux autres pistes donnent 4,62 % en multilingue (sept langues) et 10,98 % sur les enregistrements longs, les plus bas parmi les modèles ouverts comparés dans la fiche du modèle.
Chez Artificial Analysis, il fait jeu égal avec le meilleur modèle ouvert, à 2,8 % d’erreur, avec environ 4 milliards de paramètres actifs sur 30 milliards au total, contre 24 milliards pour le modèle auquel il est à égalité. Pour savoir qui parle, il obtient la plus faible erreur de diarisation sur le classement de David AI (18,26 % sur 21 langues) et se classe premier des 14 systèmes testés par VoiceArena (32,4 % de cpWER).
Installer et faire tourner Nemotron 3.5 Transcribe
Le modèle fonctionne sur un seul GPU NVIDIA, du Jetson AGX Thor et du DGX Spark jusqu’aux GPU Blackwell de data center. Sur une RTX PRO 6000 Blackwell Server Edition en précision NVFP4, il traite 100 heures d’audio en moins de trois minutes, mesuré sur des extraits de 30 secondes à forte concurrence.
Le point de contrôle se télécharge sur Hugging Face ou ModelScope. Il se sert avec vLLM ou s’exécute en local avec NeMo-Speech.cpp. Pour éviter l’auto-hébergement, des points d’accès hébergés existent chez Baseten, DeepInfra et Simplismart ; leurs tarifs ne figurent pas dans l’annonce. Une démo est aussi disponible sur Hugging Face.
Granary v2, le jeu de données ouvert
Granary v2 fait partie de la collection Nemotron speech. Construit avec NVIDIA NeMo Curator, son manifeste public couvre 463 062 heures dans 48 langues et 16 corpus sources, contre 25 langues pour la première version. NVIDIA précise que ces chiffres décrivent le jeu publié, pas l’ensemble des données d’entraînement du modèle.
Chaque enregistrement existe en trois formes de transcription : une version littérale (« I paid, uh, twenty-five euros »), une version mise en forme avec hésitations (« I paid, uh, €25 ») et une version propre (« I paid €25 »). Le pipeline produit aussi des légendes courtes, des paires de questions-réponses, des termes de contexte et des traductions notées automatiquement. L’audio source se télécharge séparément, selon la licence de chaque corpus.
Adapter le modèle à un domaine : l’exemple médical
NVIDIA illustre l’adaptation sur un banc d’essai de 3 619 extraits de médecins et d’étudiants en médecine indiens. Simplement préciser l’anglais et l’alphabet latin dans la consigne fait passer le taux d’erreur de 30,8 % à 23,8 %. L’affinage le ramène à 11,8 % sur l’ensemble du test.
Le résultat le plus solide porte sur des locuteurs jamais vus : l’erreur passe de 22,44 % avec la meilleure consigne à 12,17 % après affinage, soit 45,8 % de moins. Le modèle adapté devance un modèle médical ouvert (13,79 %) et un modèle généraliste courant (14,92 %). L’ensemble de l’adaptation a pris environ 14 heures de GPU sur un NVIDIA GB300, avec surtout de la parole synthétique complétée par des enregistrements réels.
Limites de Nemotron 3.5 Transcribe
Le modèle est conçu pour de l’audio enregistré, pas pour du flux en direct. Les fonctions varient selon la langue, et les questions-réponses sur l’audio sont entraînées en anglais. NVIDIA recommande de vérifier à l’oreille les noms, les changements de locuteur et les réponses.
L’affinage a un coût : sur l’anglais général, l’erreur de LibriSpeech test-clean monte légèrement de 1,54 % à 1,69 %, et le spécialiste médical reste meilleur sur les noms de marques de médicaments. Pour son propre domaine, l’annonce conseille de garder au moins 100 extraits réels annotés pour choisir les points de contrôle.
Quelques repères
- Diarisation : Technique qui découpe un enregistrement en tours de parole et indique quelle personne parle à quel moment.
- Taux d’erreur de mots (WER) : Mesure de la part de mots mal transcrits par rapport à un texte de référence. Plus il est bas, meilleure est la transcription.
- Affinage (fine-tuning) : Réentraînement complémentaire d’un modèle existant sur des données spécifiques, pour qu’il se comporte mieux dans un domaine précis.
Questions fréquentes
Nemotron 3.5 Transcribe est-il gratuit et open source ?
Nemotron 3.5 Transcribe est un modèle à poids ouverts, décrit comme gratuit par TechCrunch. Il se télécharge sur Hugging Face et ModelScope.
Nemotron 3.5 Transcribe peut-il savoir qui parle dans une réunion ?
Oui, il attribue les paroles aux locuteurs dans 13 langues, jusqu’à huit personnes par enregistrement. Il se classe premier des 14 systèmes testés par VoiceArena sur des conversations en anglais où l’on se coupe la parole.
Nemotron 3.5 Transcribe fonctionne-t-il en direct ?
Non, il est conçu pour des enregistrements, pas pour du streaming en direct. Il accepte des fichiers allant jusqu’à une heure.
Quel matériel faut-il pour faire tourner Nemotron 3.5 Transcribe ?
Un seul GPU NVIDIA suffit, du DGX Spark aux GPU Blackwell de data center. L’annonce ne donne pas de configuration minimale plus précise.
À retenir
Nemotron 3.5 Transcribe réunit transcription en 40 langues, traduction, identification des locuteurs et questions sur l’audio dans un modèle ouvert qui tient sur un seul GPU. Il ne traite que des enregistrements, et son adaptation à un domaine s’appuie sur Granary v2 et sur des recettes d’affinage publiées par NVIDIA.
Sources
- Hugging Faceannonce officielle
- The Decoderarticle de presse
- TechCruncharticle de presse