Sommaire10 parties
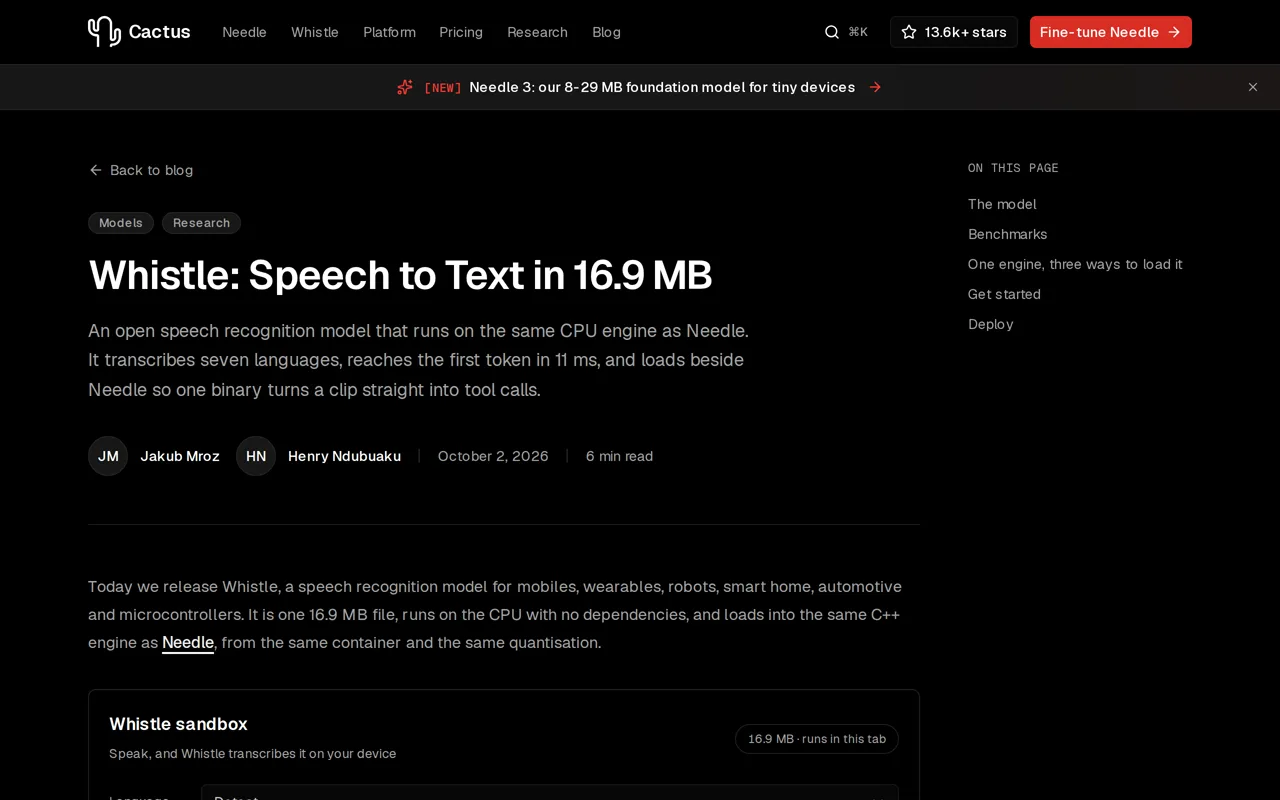
Whistle est un modèle de reconnaissance vocale publié par Cactus Compute, conçu pour tourner sur des mobiles, des objets connectés, des robots ou des microcontrôleurs. Il tient dans un fichier de 16,9 Mo, s’exécute sur le CPU sans dépendance et transcrit sept langues, dont le français, sans que l’audio quitte l’appareil. Voici ce qu’il fait, comment il est construit et comment l’essayer.
En bref
- Un seul fichier de 16,9 Mo, exécuté sur le CPU, sans dépendance
- Transcription en anglais, allemand, français, espagnol, italien, néerlandais et polonais
- Horodatage de chaque mot et extraction d’embeddings audio
- Premier token en 11,1 ms pour 10 secondes d’audio sur un Apple M4 Pro
- Installation Python avec pip install cactus-needle
Whistle, un modèle de transcription qui tient dans 16,9 Mo
Whistle transforme de la parole en texte directement sur l’appareil. L’annonce de Cactus Compute le destine aux mobiles, objets portés, robots, maisons connectées, automobiles et microcontrôleurs. Le modèle est un fichier unique de 16,9 Mo, qui tourne sur le CPU et ne demande aucune dépendance.
Il se charge dans le même moteur C++ que Needle, un autre modèle du même éditeur, avec le même conteneur et la même quantisation. Le bac à sable de la page d’annonce télécharge le modèle au premier appui sur le micro, puis transcrit dans l’onglet, sans que l’audio sorte de l’appareil.
Ce que Whistle sait faire : transcrire, horodater les mots, produire des embeddings
La transcription accepte de l’audio mono à 16 kHz, jusqu’à 30 secondes en un seul passage. Les langues prises en charge sont l’anglais, l’allemand, le français, l’espagnol, l’italien, le néerlandais et le polonais. La langue est détectée automatiquement, sauf si tu la précises.
Le modèle remplit trois fonctions, toutes sur l’appareil :
- la transcription du texte, avec la langue détectée
- l’horodatage des mots : début, fin et probabilité de chacun, calculés à partir de l’attention du décodeur
- l’embedding de la parole : la sortie de l’encodeur, une ligne par tranche de 80 ms, sans produire de transcription
Comment fonctionne Whistle
L’audio est découpé en fenêtres de 25 ms, avancées de 10 ms, puis converti en 80 bandes de fréquences, limitées à 250-3500 Hz. Trente secondes donnent 3 000 trames, ramenées à 375 par un petit étage convolutif, soit une trame toutes les 80 ms. L’encodeur compte huit blocs d’attention, qui regardent l’ensemble du clip : une trame à 3 secondes peut se rapporter à une trame à 12 secondes.
Le décodeur compte aussi huit blocs, reprend la structure de Needle et ajoute à chaque couche une attention croisée qui lit l’encodeur. Ces calculs sont faits une fois à l’arrivée du clip, puis conservés pendant tout le décodage. Cinq faisceaux de recherche (beams) coûtent donc cinq petits caches de transcription, et non cinq passages sur l’audio.
Le modèle peut aussi favoriser certains mots, comme des noms propres, en relevant leur probabilité pendant la recherche. Le moteur mesure en outre le volume du clip avant le décodage : sous un seuil, il renvoie une transcription vide sans lancer la recherche. La transcription est limitée à 320 tokens.
Les chiffres annoncés : taille, vitesse, taux d’erreur
Cactus Compute compare Whistle à Whisper base et à Moonshine tiny v2, chacun sur son moteur officiel et avec ses réglages par défaut, sur 10 secondes d’audio et un CPU Apple M4 Pro. Whistle pèse 16,9 Mo, contre 145,3 Mo pour Whisper base et 41,9 Mo pour Moonshine tiny v2. Le premier token arrive en 11,1 ms, contre 73,2 ms et 22,8 ms.
Le décodage atteint 1 319 tokens par seconde pour Whistle, un débit supérieur à celui des deux autres modèles testés. Le temps avant le premier token suit la durée du clip : 5,9 ms pour 5 secondes, 11,1 ms pour 10 secondes et 36,3 ms pour 30 secondes. Whisper, lui, complète toute entrée à 30 secondes, et son temps reste donc le même quelle que soit la durée.
Côté taux d’erreur de mots, Whistle devance les deux autres sur LibriSpeech (test-clean et test-other), SPGISpeech, Earnings-22 et la moyenne FLEURS. Whisper base reste devant sur TED-LIUM, AMI et la moyenne MLS. Les scores de Whistle sont mesurés sur 86 174 énoncés. Ceux de Whisper et de Moonshine sont les chiffres publiés par leurs auteurs, et Moonshine ne couvre que l’anglais. L’éditeur affirme avoir vérifié qu’aucun audio de test ne figure dans les données d’entraînement ou de validation.
Installer Whistle et transcrire un fichier en Python
L’installation passe par pip. Un fichier WAV à 16 kHz, ou des échantillons bruts, ne demande rien de plus. Les autres fréquences d’échantillonnage et la capture au micro nécessitent l’option [mic], qui ajoute soxr et sounddevice.
Chaque appel renvoie le texte, la langue, le temps avant le premier token et le débit du décodeur. L’option word_timestamps=True ajoute les mots avec leurs temps et leur probabilité. keywords=["Siobhan", "Krzysztof"] favorise des expressions précises, et language="de" force la langue au lieu de la détecter. Deux commandes complètent l’ensemble : needle whistle playground transcrit depuis le micro dans le terminal, et needle whistle compare passe le même clip dans Whistle, Whisper et Moonshine avec leurs durées.
pip install cactus-needle
import needle
Déployer Whistle sur mobile, robot ou navigateur
Le moteur est fourni précompilé pour dix-sept cibles : macOS, Linux, Android, iOS, watchOS, Windows sur ARM, RISC-V, MIPS, le navigateur et un composant WASI. Chaque dossier contient un binaire needle, la bibliothèque libneedle.a et l’en-tête needle.h. L’API C dédiée à la parole se limite à trois fonctions : needle_load, needle_transcribe et needle_embed. Le moteur ne lit aucune variable d’environnement.
Le même binaire peut combiner Whistle et un modèle de texte. Avec Needle et un fichier d’outils, il transcrit un clip, puis répond à la transcription en renvoyant un objet JSON avec les appels de fonctions et les champs de parole, préfixés audio_. L’exemple de l’annonce transforme « turn off the kitchen lights » en un appel set_lights, ce qui rejoint le cas de la commande vocale pour objets connectés ou robots.
Quelques repères
- CPU : Le processeur principal d’un appareil. L’exécuter sur le CPU signifie qu’aucune carte graphique ni puce spécialisée n’est nécessaire.
- Taux d’erreur de mots : Mesure de la qualité d’une transcription : la part de mots erronés, manquants ou ajoutés par rapport à un texte de référence. Plus il est bas, meilleure est la transcription.
- Embedding : Représentation numérique d’un contenu, ici un son, sous forme de listes de nombres. Elle sert à comparer ou à analyser ce contenu sans passer par du texte.
Questions fréquentes
Whistle fonctionne-t-il hors ligne, sans cloud ?
Oui. Whistle s’exécute sur l’appareil, sur le CPU, et selon Cactus Compute l’audio ne le quitte pas. Le bac à sable de la page d’annonce télécharge le modèle une première fois, puis transcrit dans l’onglet.
Whistle comprend-il le français ?
Oui. Whistle transcrit l’anglais, l’allemand, le français, l’espagnol, l’italien, le néerlandais et le polonais. La langue est détectée automatiquement, ou imposée avec l’option language.
Comment installer Whistle en Python ?
Avec la commande pip install cactus-needle, puis needle.transcribe("clip.wav"). Un WAV à 16 kHz ne demande rien de plus ; les autres fréquences et le micro nécessitent l’option [mic].
Whistle peut-il donner l’heure de chaque mot d’une transcription ?
Oui. Avec word_timestamps=True, chaque mot est renvoyé avec son début, sa fin et sa probabilité. Dans le moteur en ligne de commande, l’option équivalente est --audio-word-timestamps.
À retenir
Whistle est un modèle de transcription de 16,9 Mo qui tourne sur le CPU, en sept langues, avec horodatage des mots et embeddings audio. Selon les mesures de son éditeur, il devance Whisper base sur plusieurs jeux de test mais reste derrière sur TED-LIUM, AMI et la moyenne MLS.
Sources
- cactuscompute.compage citée sur Hacker News