Sommaire11 parties
Firecrawl est une API de données web, open source, qui permet à un agent IA de chercher sur le web, de lire des pages et d’en tirer un contenu propre. Elle convertit une adresse en markdown, en JSON structuré ou en capture d’écran, sans que tu gères toi-même proxys et pages en JavaScript. Le projet est aussi proposé en service hébergé, avec une clé API.
En bref
- Convertit une URL en markdown, HTML, JSON structuré ou capture d’écran
- Cherche sur le web, explore un site entier ou en liste toutes les URL
- Se branche à un agent ou à un client MCP en une commande
- Open source (AGPL-3.0) et proposé en service hébergé avec clé API
Firecrawl, une API pour donner le web à une IA
Une page web brute contient beaucoup de bruit : menus, publicités, pied de page. Firecrawl récupère le contenu utile et le rend dans un format qu’un modèle de langage lit facilement, surtout le markdown. Le site du projet affirme que cela représente 93 % de jetons en moins à envoyer au modèle.
Il prend aussi en charge ce qui complique le scraping : proxys rotatifs, limites de débit, contenus que le JavaScript affiche tardivement. Le projet annonce une couverture de 96 % du web sur un test de 1 000 URL réalisé le 13 janvier 2026, contre 79 % pour Puppeteer et 75 % pour cURL.
Ce que Firecrawl sait faire
Trois fonctions forment le cœur du service, auxquelles s’ajoutent quatre autres pour les besoins plus larges. Chacune s’appelle par l’API, par un SDK (une bibliothèque pour ton langage) ou en ligne de commande.
- Search : cherche sur le web et renvoie le contenu complet des résultats
- Scrape : convertit une URL en markdown, HTML, captures d’écran ou JSON structuré
- Interact : charge une page, puis agit dessus avec une consigne en langage naturel ou du code
- Crawl : récupère toutes les pages d’un site avec une seule requête
- Map : liste toutes les URL d’un site, avec une recherche possible pour les trier par pertinence
- Batch Scrape : traite des milliers d’URL de façon asynchrone
Agir sur une page et laisser un agent chercher
Avec les actions, Firecrawl peut cliquer, défiler, écrire, attendre ou presser une touche avant d’extraire le contenu. Les notes de la version 2.9.0 (10 avril 2026) précisent que l’endpoint /interact garde la session entre les appels et propose un affichage en direct du navigateur.
La fonction Agent va plus loin : tu décris ce que tu veux, et l’agent cherche, navigue et récupère l’information, sans que tu connaisses les URL à l’avance. Le README la présente comme l’évolution de l’ancien endpoint /extract. Un réglage d’effort (low, medium ou high) fixe le budget de raisonnement, et tous les niveaux utilisent le modèle spark-2.
Firecrawl lit aussi les PDF et les DOCX. Depuis la version 2.10 (15 mai 2026), l’endpoint /parse accepte des fichiers locaux jusqu’à 50 Mo.
Installer et essayer Firecrawl
Le chemin décrit par le README passe par le service hébergé : tu t’inscris sur firecrawl.dev pour obtenir une clé API, et un terrain de jeu en ligne permet de tester. Ensuite, un SDK s’installe en une commande. Le README en propose pour Python, Node.js, Go, Java, Elixir, Rust et Ruby.
Pour Python, l’installation et un premier scrape ressemblent à ceci.
Brancher Firecrawl à un agent IA
Une commande installe les compétences (skills) de Firecrawl dans ton agent. Il faut ensuite le redémarrer. Le README cite notamment Claude Code, Antigravity et OpenCode comme agents compatibles.
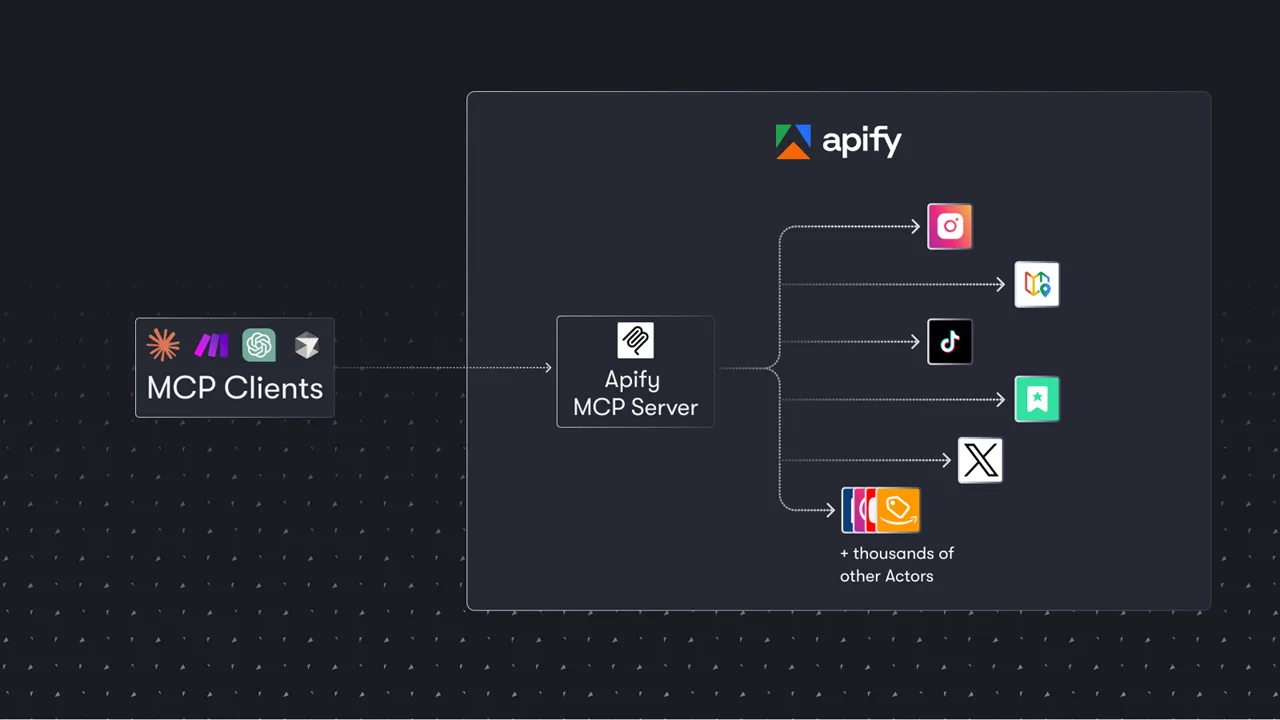
Les clients compatibles MCP se connectent avec le paquet firecrawl-mcp et la variable FIRECRAWL_API_KEY. La version 2.11.0 (19 juin 2026) ajoute un accès sans clé API à /scrape, /search, /interact et /parse depuis les clients officiels MCP, CLI et SDK.
npx -y firecrawl-cli@latest init --all --browserPour quels usages ?
Le site du projet cite la recherche approfondie, les assistants IA alimentés en contenu web à jour, les outils pour agents, l’alimentation automatique d’un parcours d’inscription et l’enrichissement de fiches commerciales. Il présente des entreprises clientes pour chacun de ces cas, comme Sierra, Lovable, Gamma ou Cognism.
Si tu cherches à transformer un site en markdown, à explorer toutes ses pages ou à extraire des données sans écrire de scraper, ces fonctions couvrent le besoin. La version 2.11.0 ajoute aussi une option redactPII pour retirer noms, e-mails et numéros de téléphone du contenu récupéré.
Où en est le projet et ce qu’il faut savoir
Au 8 octobre 2026, le dépôt compte 189 702 étoiles, 10 050 copies (forks), 175 contributeurs et 534 tickets et demandes de fusion ouverts. Il a été créé le 15 avril 2024, et sa dernière version publiée est la v2.11.0 du 19 juin 2026. Le code est en TypeScript à 73 % et en Python à 12 %.
La licence est l’AGPL-3.0. Le README présente le projet comme open source et disponible en service hébergé, mais il ne détaille pas ici d’installation sur ton propre serveur ni la grille de tarifs. Le site indique seulement un démarrage gratuit et deux mois offerts en cas d’abonnement annuel.
Quelques repères
- API : Une interface qui permet à un programme d’en appeler un autre pour obtenir un service ou des données, par des requêtes standardisées.
- MCP : Un protocole qui permet à un assistant ou à un agent IA de se connecter à des outils et à des services externes de façon uniforme.
- Jeton : Un morceau de texte, mot ou fragment de mot, que traite un modèle de langage. Moins il y a de jetons à lire, plus la requête est légère.
Questions fréquentes
Firecrawl est-il gratuit et open source ?
Firecrawl est open source, sous licence AGPL-3.0, et aussi proposé en service hébergé avec clé API. Le site du projet indique un démarrage gratuit, mais le README ne détaille pas la grille de tarifs.
Comment transformer un site en markdown avec Firecrawl ?
Avec la fonction Scrape pour une page, ou Crawl pour toutes les pages d’un site. Firecrawl renvoie un markdown sans menus ni publicités, ou d’autres formats comme du JSON structuré.
Firecrawl fonctionne-t-il avec Claude Code et les clients MCP ?
Oui. Une commande npx installe les skills de Firecrawl dans ton agent, et un paquet firecrawl-mcp connecte les clients MCP. Le README cite Claude Code, Antigravity et OpenCode.
Firecrawl peut-il lire les pages en JavaScript et les PDF ?
Oui. Le projet gère les pages riches en JavaScript, sans configuration, et lit les PDF et les DOCX. Il annonce 96 % de couverture sur un test de 1 000 URL du 13 janvier 2026.
À retenir
Firecrawl fournit à un agent IA ou à une application des données web propres, par la recherche, le scraping, le crawl et l’interaction avec les pages. Le code est ouvert sous AGPL-3.0, mais le chemin d’usage décrit par le projet passe par son service hébergé et sa clé API.
Sources
- firecrawlREADME
- firecrawl.devdocumentation officielle
- GitHubnotes de version