Sommaire11 parties
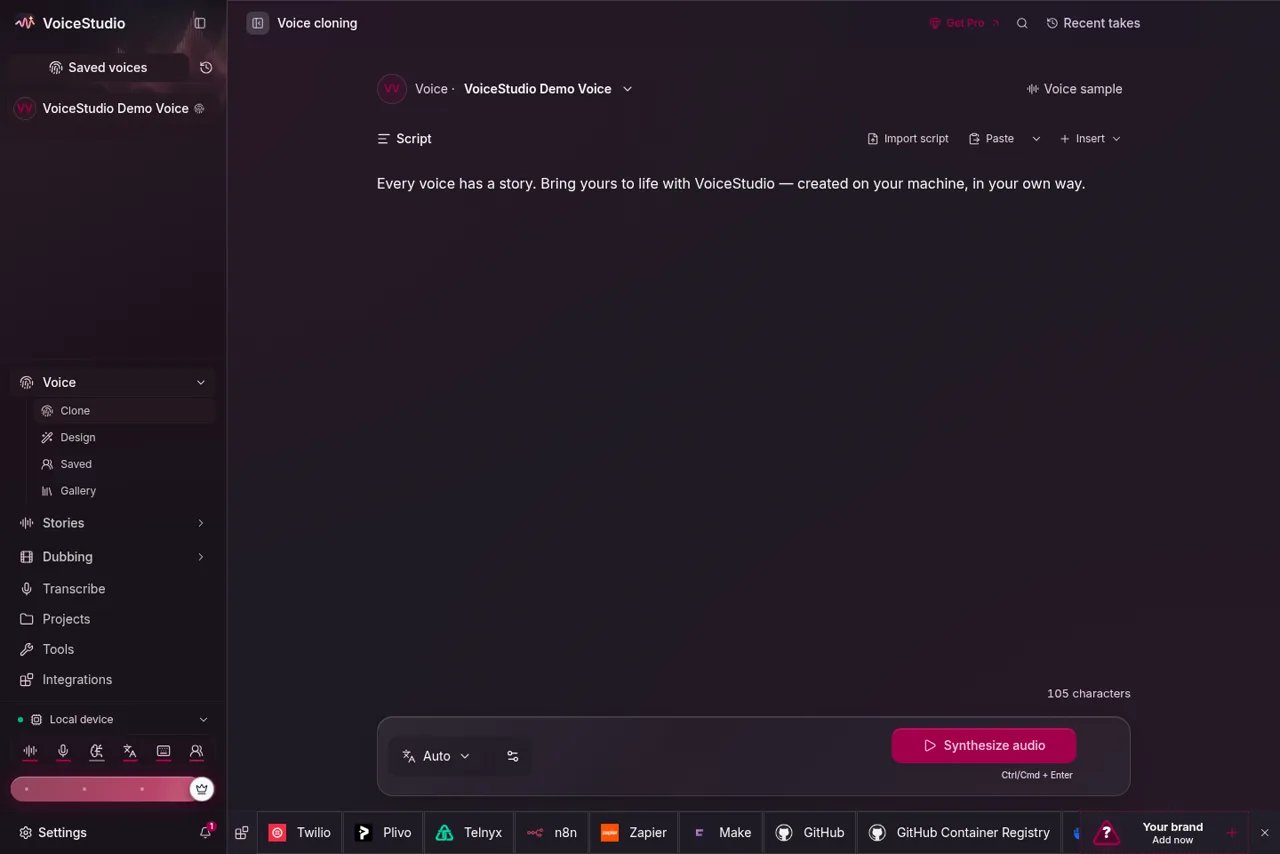
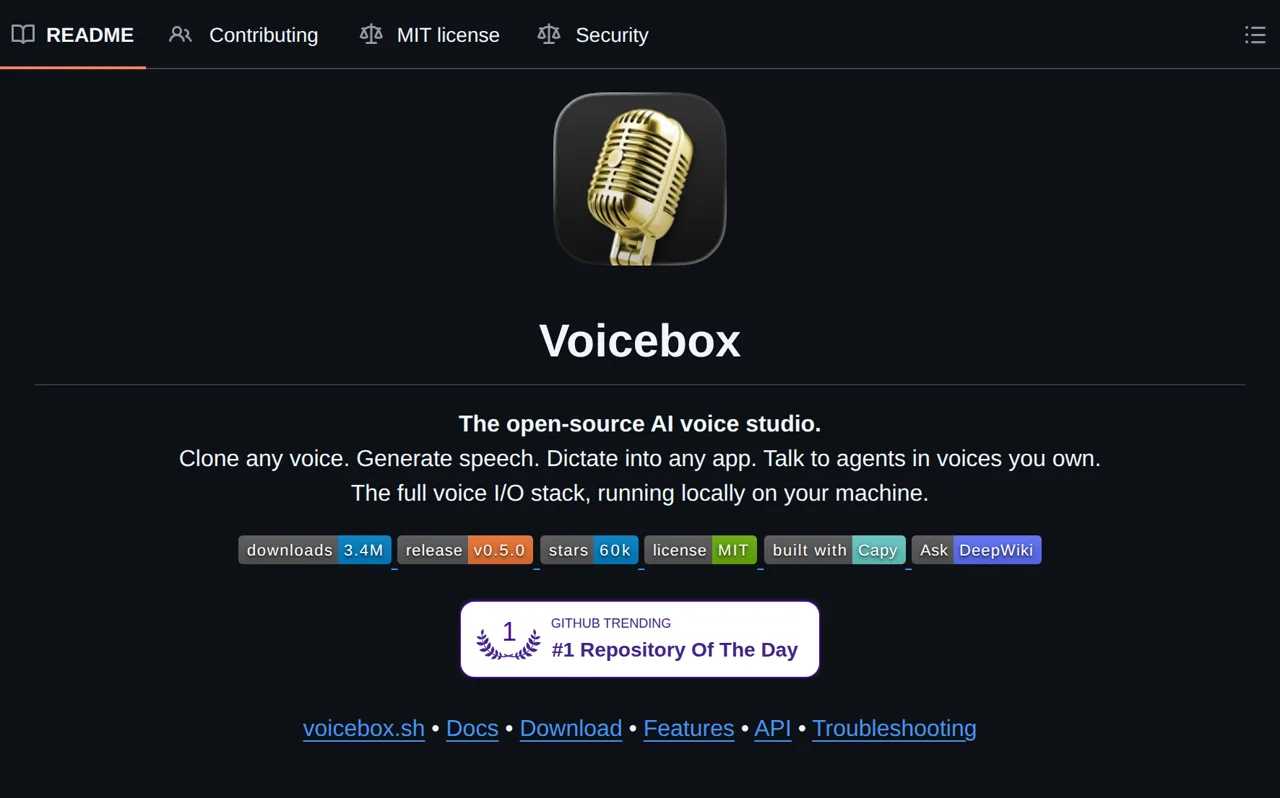
Voicebox est un studio de voix open source qui tourne sur ta machine : il clone une voix, transforme un texte en parole et transcrit ce que tu dictes. Il réunit huit moteurs de synthèse vocale, 23 langues et un serveur qui permet à un agent IA de te parler avec une voix que tu as clonée. Ses auteurs le présentent comme une alternative gratuite à ElevenLabs et à WisprFlow.
En bref
- Clone une voix à partir de quelques secondes d’audio, en local
- 8 moteurs de synthèse vocale, 23 langues, textes jusqu’à 50 000 caractères
- Dictée avec raccourci global et transcription par Whisper
- Serveur MCP et API REST intégrés pour donner une voix à un agent
- Licence MIT, applis macOS et Windows, ou Docker
Voicebox, un studio de voix qui reste sur ta machine
Voicebox règle un problème simple : les outils de voix par IA sont souvent des services en ligne, répartis entre ceux qui produisent de la voix et ceux qui transcrivent ce que tu dis. Le README cite ElevenLabs pour la sortie et WisprFlow pour l’entrée. Voicebox couvre les deux moitiés dans une seule application.
Tout s’exécute en local : les modèles, les données vocales et les enregistrements ne quittent pas ta machine, d’après le projet. Il est écrit surtout en Python (46 %), en TypeScript (42 %) et en Rust (9 %), et son interface repose sur Tauri plutôt que sur Electron.
Comment fonctionne Voicebox
Le principe repose sur des profils de voix. Tu crées un profil à partir d’un fichier audio, d’un enregistrement au micro ou d’un son capturé sur ton système, par exemple une vidéo ou un podcast. Le site officiel indique que le clonage fonctionne à partir de 3 secondes d’audio au minimum, et que l’enregistrement au micro est limité à 30 secondes.
Ensuite, tu choisis un moteur de synthèse vocale pour chaque génération. Les générations passent par une file d’attente : tu peux soumettre un texte et commencer à écrire le suivant, et une génération échouée peut être relancée. Un petit modèle de langage local, de la famille Qwen3, sert aux étapes de réécriture et de nettoyage.
Cloner une voix et générer de la parole
Le README décrit huit moteurs : Qwen3-TTS, Qwen CustomVoice, Qwen VoiceDesign, LuxTTS, Chatterbox Multilingual, Chatterbox Turbo, TADA et Kokoro. Chacun a ses points forts. Kokoro propose 50 voix prédéfinies avec un modèle léger, Qwen VoiceDesign crée une voix à partir d’une description écrite, et Chatterbox Multilingual couvre 23 langues.
Seul Chatterbox Turbo interprète des balises expressives comme [laugh] ou [sigh] ; les autres moteurs les lisent comme du texte. Après la génération, huit effets sont disponibles (réverbération, écho, changement de hauteur, compresseur, filtres…), avec quatre préréglages : Robotic, Radio, Echo Chamber et Deep Voice.
Pour les longs textes, Voicebox découpe aux limites de phrases, génère chaque morceau puis les enchaîne avec un fondu. La longueur maximale est de 50 000 caractères. Un éditeur « Stories » à pistes multiples permet aussi de monter des conversations ou des podcasts avec plusieurs voix.
- Importer et exporter des profils pour les sauvegarder ou les partager
- Plusieurs échantillons par profil pour améliorer le clonage
- Versions successives de chaque génération, avec favoris
- Effets par défaut attachés à chaque profil
Dicter dans n’importe quelle appli avec Voicebox
Voicebox sait aussi faire l’inverse : transformer ta voix en texte. Tu maintiens un raccourci global, tu parles, tu relâches, et la transcription se colle dans le champ de texte actif. Les notes de la version 0.5.0 donnent les raccourcis par défaut : Cmd droite + Option droite sur macOS, Ctrl droite + Maj droite sur Windows. Un mode « appui pour basculer » existe, avec son propre raccourci, et tout se règle dans les paramètres.
La transcription repose sur Whisper, en tailles Base, Small, Medium, Large et Turbo, sur 99 langues d’après le site. Une option fait nettoyer le texte par le modèle local, qui retire hésitations et reprises. Chaque dictée est conservée avec son audio dans l’onglet Captures, où tu peux la retranscrire, la corriger ou la rejouer avec une voix clonée.
Si l’autorisation d’accessibilité de macOS n’est pas accordée, la dictée fonctionne quand même : seul le collage automatique est désactivé et les transcriptions restent dans Captures.
Donner une voix à un agent IA
Voicebox embarque un serveur MCP. Un agent compatible, comme Claude Code, Cursor ou Cline, peut appeler l’outil voicebox_speak pour te parler avec l’un de tes profils. Une pastille s’affiche à l’écran pendant que l’agent parle, afin que rien ne sorte de ta machine sans que tu le voies. Tu peux aussi attribuer une voix différente à chaque agent.
Les profils peuvent recevoir une personnalité, un texte libre. Deux actions apparaissent alors : « Compose » fait improviser une phrase par le personnage, et « Speak in character » réécrit ton texte dans sa manière de parler avant de le lire. Le même point d’entrée existe en HTTP pour les scripts qui ne parlent pas MCP.
Pour brancher Claude Code, le README donne cette commande :
claude mcp add voicebox \
  --transport http \
  --url http://127.0.0.1:17493/mcp \
  --header "X-Voicebox-Client-Id: claude-code"
Installer Voicebox et utiliser son API
Le projet propose un DMG pour macOS (Apple Silicon et Intel), un MSI pour Windows et une version Docker. Sous Linux, il n’existe pas encore de binaire : il faut compiler depuis les sources en suivant les instructions du site. Pour Docker, la commande est :
Côté matériel, Voicebox exploite Metal sur Apple Silicon, CUDA sur NVIDIA, ROCm sur AMD, DirectML sous Windows et Intel Arc, ou le processeur seul, plus lentement. Le projet ne donne pas de configuration minimale globale ; il indique seulement que LuxTTS demande environ 1 Go de VRAM.
L’application expose une API REST locale, sans clé ni limite d’appels selon le site. Exemple de génération de parole :
docker compose up
curl -X POST http://127.0.0.1:17493/generate \
  -H "Content-Type: application/json" \
  -d '{"text": "Hello world", "profile_id": "abc123", "language": "en"}'
Où en est le projet Voicebox
Au 6 novembre 2026, le dépôt compte 59 527 étoiles, 7 466 copies, 106 contributeurs et 533 tickets et demandes de fusion ouverts. Il a été créé le 25 janvier 2026, et son code a été modifié pour la dernière fois le 7 octobre 2026. La dernière version publiée est la v0.5.0, du 25 avril 2026.
Cette version ajoute la dictée globale, les captures, le serveur MCP côté agent et les personnalités de voix. Les versions 0.4.4 et 0.4.5 corrigeaient une erreur « offline mode is enabled » au chargement des modèles. Le projet est sous licence MIT et dit rester gratuit, sans bannière ni interruption dans l’application. Les moteurs de transcription Parakeet v3 et Qwen3-ASR figurent sur sa feuille de route.
Quelques repères
- MCP : Le Model Context Protocol est un protocole ouvert qui permet à un assistant IA d’utiliser des outils externes, comme lire des fichiers ou déclencher une action. Il sert de langage commun entre l’assistant et ces outils.
- API REST : Une API REST est une façon pour un programme d’en commander un autre par des requêtes web. Cela permet d’intégrer une fonction, comme la génération de parole, dans ses propres scripts ou applications.
- VRAM : La VRAM est la mémoire de la carte graphique. Les modèles d’IA doivent y tenir pour tourner rapidement sur le GPU.
Questions fréquentes
Voicebox est-il gratuit ?
Oui, Voicebox est gratuit et open source, sous licence MIT. Le projet précise qu’il n’affiche ni bannière ni interruption dans l’application.
Voicebox fonctionne-t-il sans connexion Internet ?
Voicebox exécute modèles et enregistrements en local, et ses données ne quittent pas la machine. Les modèles doivent toutefois être téléchargés. Les notes de version signalent aussi que sans réseau, de courtes pauses d’une trentaine de secondes ont pu apparaître en version 0.4.4, corrigées en 0.4.5.
Combien de secondes d’audio faut-il pour cloner une voix avec Voicebox ?
Le site de Voicebox indique qu’un clonage est possible à partir de 3 secondes d’audio. L’échantillon peut être un fichier, un enregistrement au micro limité à 30 secondes ou un son capturé sur le système.
Voicebox existe-t-il pour Linux ?
Pas encore sous forme de binaire prêt à installer. Le README renvoie vers des instructions pour compiler Voicebox depuis les sources.
À retenir
Voicebox rassemble clonage de voix, synthèse vocale, dictée et voix d’agents IA dans une application locale sous licence MIT. Sa dernière version publiée est la v0.5.0 d’avril 2026, et il n’existe pas encore de binaire pour Linux.
Sources
- jamiepineREADME
- voicebox.shdocumentation officielle
- docs/README.mddocumentation officielle
- GitHubnotes de version